part08-自然语言处理-中文文本分类与聚类
part08-自然语言处理-中文文本分类与聚类
NLP知识目标
NLP知识目标
知识点1 朴素贝叶斯实现中文文本分类
- 理解文本分类(有监督)与文本聚类(无监督)的区别:是否需要人工标注、输出是什么。
- 理解多项式朴素贝叶斯的三个要素:先验概率、条件概率、拉普拉斯平滑,并能手算出与代码一致的结果。
- 理解词袋(CountVectorizer)为什么适合喂给多项式朴素贝叶斯。
- 掌握训练集/测试集必须共用同一个词表的工程原则(fit / transform 的正确分工)。
知识点2 KMeans 实现中文文本聚类
- 理解 KMeans 的四步迭代:随机初始化中心 → 分配样本 → 更新中心 → 收敛。
- 理解簇数 k 为什么必须人为指定,以及簇编号为什么不能当类别编号用。
- 理解聚类结果为什么无法评价"对错",只能评价簇内紧凑度与簇间分离度。
知识点3 【案例】垃圾短信分类
- 掌握中文文本分类的完整工程链路:读数据 → 去重去噪 → 分词 → 去停用词 → 平衡采样 → 向量化 → 训练 → 评价。
- 理解类别不均衡为什么会让准确率失去意义,以及平衡采样的作用。
- 理解混淆矩阵、精确率、召回率、F1、宏平均、加权平均的含义与读法。
知识点4 【案例】中文新闻主题聚类
- 掌握 JSON 行式语料的逐行读取与按文件名打标签的方法。
- 掌握聚类纯度的计算方式,能读懂"簇 × 真实类别"交叉表。
- 理解
fit/predict/fit_predict的语义差别,以及为什么测试集只能用predict。
知识点5 【案例】阿里云中文新闻主题分类
- 掌握商用 NLP API 的五步调用骨架,理解请求参数与两层返回结构。
- 理解商用接口的类目体系为什么不可自定义,以及它与自建分类器在数据、置信度、边界上的差别。
1. 中文文本分类与聚类
中文文本分类与聚类
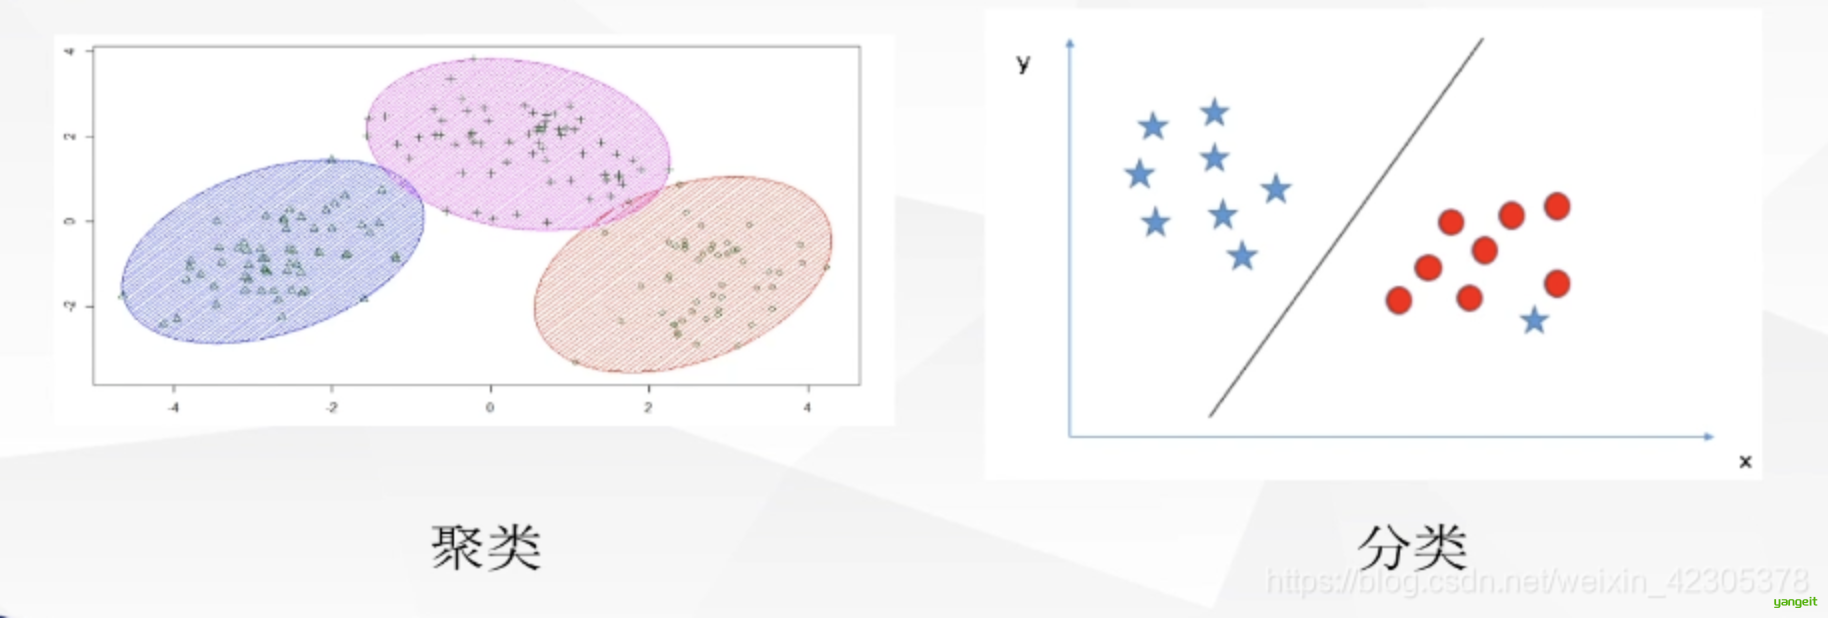
文本分类(Text Classification)是在已知类别集合的前提下,把一篇文本划归到其中一个类别,属于有监督学习——训练时每一条文本都必须带着人工标注好的类别标签。
文本聚类(Text Clustering)则是在没有任何标签的情况下,按内容相似度把文本自动分成若干组,属于无监督学习——分成几组由人指定,每组叫什么名字要事后人工解释。
两者的共同点是:都要先把中文文本变成数值向量,再用向量之间的相似度做判断。区别在于"有没有标准答案"
- 有标准答案就能算错对、能训练模型去拟合;
- 没有标准答案就只能按相似度抱团,也就无从谈论"准确率"。
典型业务应用场景: 👇
| 任务 | 场景举例 | 是否有标签 |
|---|---|---|
| 文本分类 | 垃圾短信/垃圾邮件识别、新闻自动归类、客服工单自动派单、评论情感极性判断、舆情标签打标 | 有 |
| 文本聚类 | 热点话题自动发现、新闻专题聚合、无标注语料预分组、用户提问归并、搜索结果归并 | 无 |
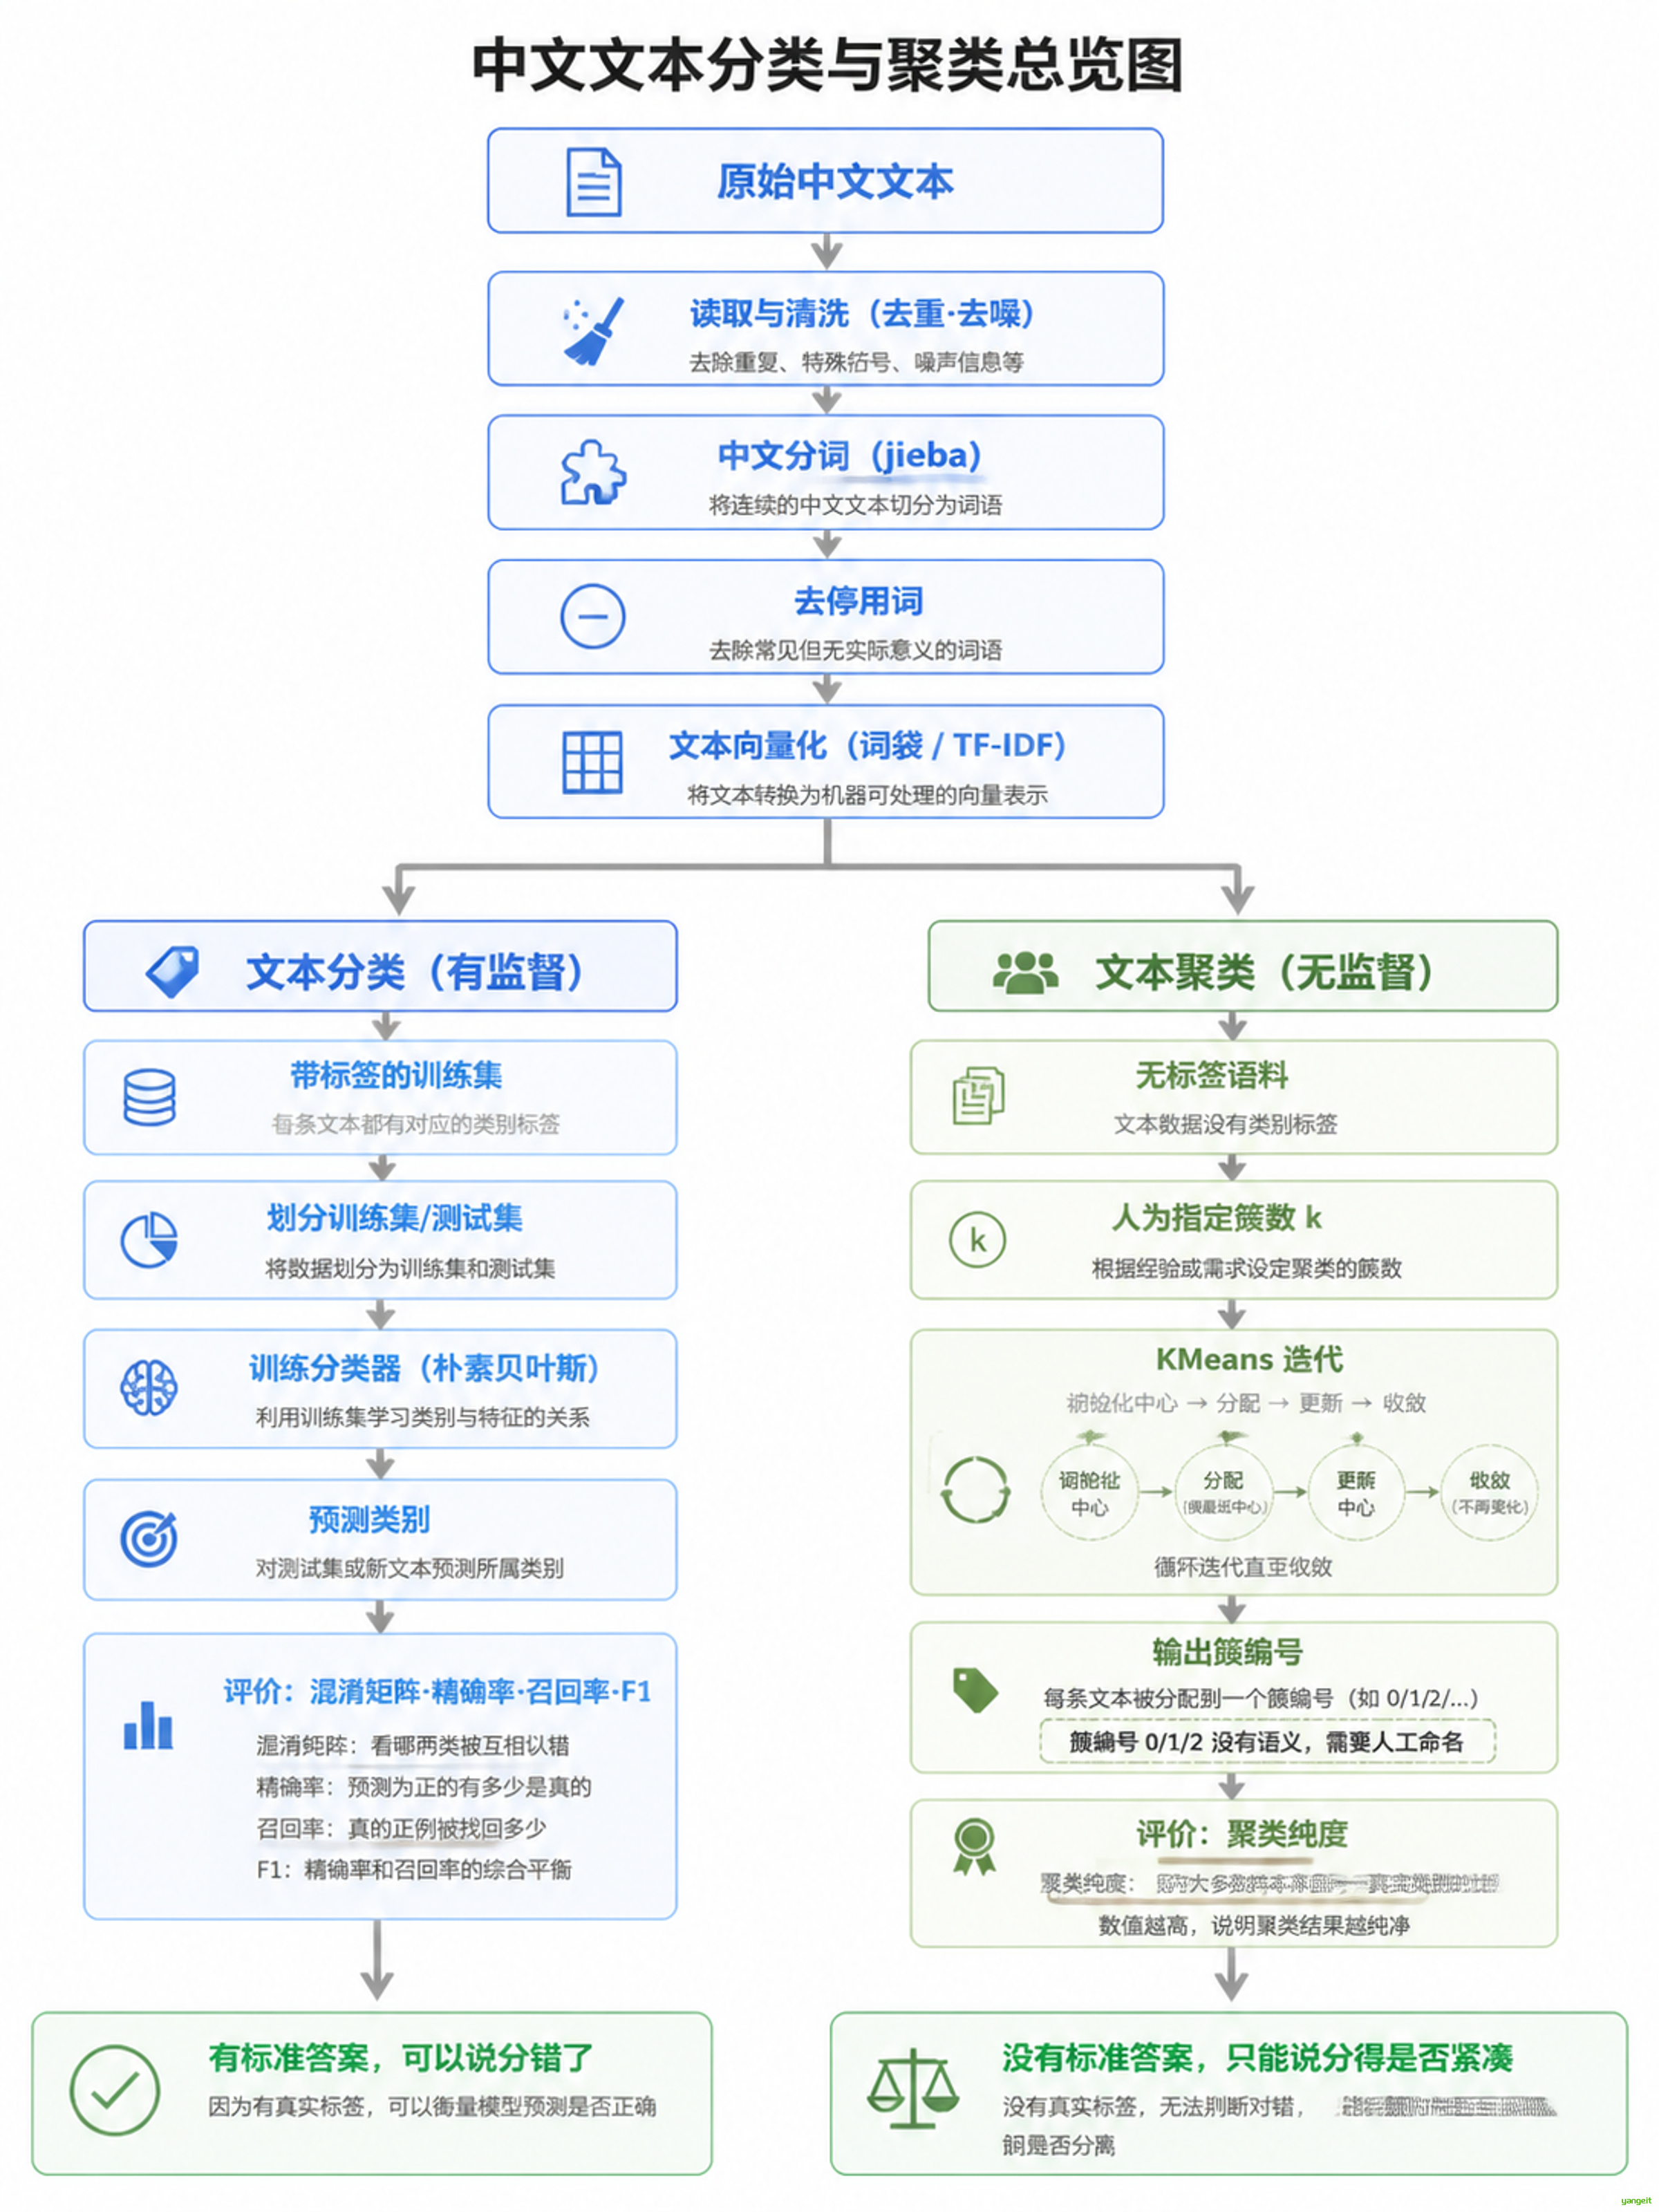
文本分类与聚类的完整处理流程:
原始中文文本(短信 / 新闻 / 评论)
→ 读取与清洗(去重、去噪、去特殊字符)
→ 中文分词(jieba,可加载自定义词典)
→ 去停用词、过滤空结果
→ 文本向量化(词袋 CountVectorizer 或 TF-IDF)
→ ┌─ 有标签 ──→ 划分训练集 / 测试集
   │              → 训练分类器(朴素贝叶斯、逻辑回归、SVM…)
   │              → 在测试集上预测
   │              → 评价(混淆矩阵、精确率、召回率、F1、准确率)
   └─ 无标签 ──→ 人为指定簇数 k
                  → KMeans 迭代(初始化中心 → 分配 → 更新 → 收敛)
                  → 评价(聚类纯度、轮廓系数)
                  → 人工解释每个簇代表什么
分类与聚类的横向对比:👇
| 对比维度 | 文本分类 | 文本聚类 |
|---|---|---|
| 学习方式 | 有监督 | 无监督 |
| 训练数据 | 每条文本都要有类别标签 | 不需要任何标签 |
| 类别从哪来 | 事先定义好,训练时告诉模型 | 由算法按相似度自动形成,事后人工命名 |
| 需要人为指定的参数 | 无(类别数由数据决定) | 必须指定簇数 k |
| 输出结果 | 每条文本一个类别名 | 每条文本一个簇编号(0、1、2…,本身无语义) |
| 能否说"分错了" | 能,有标准答案 | 不能,只能说"分得是否紧凑、是否可解释" |
| 常用指标 | 准确率、精确率、召回率、F1、混淆矩阵 | 聚类纯度、轮廓系数、Calinski-Harabasz 指数 |
| 典型算法 | 朴素贝叶斯、逻辑回归、线性 SVM、决策树 | KMeans、层次聚类、DBSCAN |
朴素贝叶斯与 KMeans 的核心差异: 👇
| 对比维度 | 多项式朴素贝叶斯 | KMeans |
|---|---|---|
| 训练时看不看标签 | 看,估计每个类别下每个词的出现概率 | 不看,只按向量距离抱团 |
| 模型里存了什么 | 每个类别的先验概率 + 每个词在该类下的条件概率 | k 个簇的中心点坐标 |
| 预测新文本 | 代入贝叶斯公式,取概率最大的类别 | 算它离哪个中心点最近 |
| 对特征的假设 | 假定各词互相独立("朴素"之名的由来) | 假定簇是球形的、大小相近 |
| 对数据量 | 几千条就能出可用结果 | 需要足够样本才能让中心点稳定 |
2 环境与依赖准备
前言
推荐 Python 3.8 及以上版本(本讲义实测使用 Python 3.13.14),编辑器推荐 PyCharm、Visual Studio Code 或 Jupyter Notebook。
pip install jieba scikit-learn pandas numpy matplotlib wordcloud imageio joblib -i https://pypi.tuna.tsinghua.edu.cn/simple国内镜像源偶发同步延迟,若某源提示找不到包,换成备用源即可:
pip install jieba scikit-learn pandas numpy matplotlib wordcloud imageio joblib -i https://mirrors.aliyun.com/pypi/simple/实测版本:Python 3.13.14 / jieba 0.42.1 / scikit-learn 1.9.1 / pandas 3.0.5 / numpy 2.5.3 / matplotlib 3.11.2 / wordcloud 1.9.6 / imageio 2.38.1。
本章依赖外部数据文件。本章代码统一用 ./data/ 访问数据,建议准备以下目录结构:
项目目录/
├── 代码8_1.ipynb             # 代码文件与 data 目录同级
├── 代码8_2.ipynb
├── …
├── data/                  # 教材配套数据,用 ./data/ 访问
│   ├── messages.csv       # 垃圾短信数据集,677291 条,约 53 MB
│   ├── stopword.txt       # 停用词表,GBK 编码,1900 行(短信案例用这一份)
│   ├── stopwords.txt      # 停用词表,UTF-8 编码(新闻案例用这一份)
│   ├── newdic1.txt        # jieba 自定义词典:女人节 / 手机号 / 通话 / 短信
│   ├── background.jpg     # 词云背景图,591 × 1181
│   └── json/              # 中文新闻语料,每类 500 条
│       ├── 从政.json
│       ├── 体育.json
│       ├── 国际.json
│       └── 经济.json
└── tmp/                   # 词云输出目录,必须提前手动创建
3.朴素贝叶斯实现中文文本分类
朴素贝叶斯实现中文文本分类
1.NLP知识点
- 文本分类是有监督学习:训练数据每一条都带类别标签,模型学的是"哪些词指向哪个类别"。
- 标准工程链路:
分词 → 向量化 → 训练分类器 → 预测 → 评价。 - 多项式朴素贝叶斯(MultinomialNB)的判定依据:对每条文本,分别计算它属于各个类别的概率,取概率最大的那个。
- "朴素"二字的含义:假定文本中每个词的出现互相独立,因此一条文本的概率可以拆成各个词概率的连乘。
- 先验概率是该类别在训练集中占的比例;条件概率是"已知是这个类别,这个词出现的概率"。
- 拉普拉斯平滑:给每个词的出现次数加 α(默认 1),同时给分母加上 α × 词表大小,避免"没见过的词"把整条乘积归零。
- 训练集与测试集必须共用同一个词表:测试集只能用训练集学来的词表做
transform,绝不能重新fit。
2.NLP理论知识点
朴素贝叶斯的判定公式是:
P(类别 | 文本) ∝ P(类别) × P(词1 | 类别) × P(词2 | 类别) × … × P(词n | 类别)先验概率:P(类别) = 类别在训练集中出现的次数 / 训练集总条数
等号右边第一项是先验概率,后面每一项是条件概率。模型训练时做的事,就是数一遍训练集,把这两类概率估计出来。
条件概率的估计方式(含平滑):
P(词 | 类别) = (该词在这个类别中出现的次数 + α) / (这个类别的总词数 + α × 词表大小)如:P(牛肉|水果)表示:已知是水果类,这个牛肉出现的概率。
分母里的α × 词表大小不能省。加平滑项是为了避免某个词在某类中一次都没出现过时概率变成 0——一旦有一个 0,整条连乘的结果就归零,模型会变成"只要见到没见过的词就绝对排除这个类别"。
例子:水果与肉类
训练集只有 6 条,每句 2 个词,两类各 3 条:
| 类别 | 训练文本 |
|---|---|
| 水果 | 苹果多汁 / 苹果新鲜 / 香蕉多汁 |
| 肉类 | 牛肉便宜 / 猪肉便宜 / 牛肉好吃 |
第一步,确定词表大小。 分词后共出现 8 个不同的词:苹果、多汁、新鲜、香蕉、牛肉、便宜、猪肉、好吃,所以 V = 8。
第二步,数词频。 每个类别各有 3 条 × 2 个词 = 6 个词,α 取 1,所以两类分母都是 6 + 1 × 8 = 14。
第三步,算条件概率。
| 词 | 水果类计数 | P(词|水果) | 肉类类计数 | P(词|肉类) |
|---|---|---|---|---|
| 苹果 | 2 | 3/14 ≈ 0.2143 | 0 | 1/14 ≈ 0.0714 |
| 多汁 | 2 | 3/14 ≈ 0.2143 | 0 | 1/14 ≈ 0.0714 |
| 新鲜 | 1 | 2/14 ≈ 0.1429 | 0 | 1/14 ≈ 0.0714 |
| 香蕉 | 1 | 2/14 ≈ 0.1429 | 0 | 1/14 ≈ 0.0714 |
| 牛肉 | 0 | 1/14 ≈ 0.0714 | 2 | 3/14 ≈ 0.2143 |
| 便宜 | 0 | 1/14 ≈ 0.0714 | 2 | 3/14 ≈ 0.2143 |
| 猪肉 | 0 | 1/14 ≈ 0.0714 | 1 | 2/14 ≈ 0.1429 |
| 好吃 | 0 | 1/14 ≈ 0.0714 | 1 | 2/14 ≈ 0.1429 |
第四步,算先验。 两类各 3 条,所以 P(水果) = P(肉类) = 0.5。
第五步,对测试文本"苹果多汁"连乘取大者。
P(水果 | 苹果多汁) ∝ 0.5 × 3/14 × 3/14 = 9/392
P(肉类 | 苹果多汁) ∝ 0.5 × 1/14 × 1/14 = 1/392

归一化:9/(9+1) = 0.90,1/(9+1) = 0.10
→ 判为水果,置信度 0.90
同理,"牛肉便宜"会得到 0.10 : 0.90,判为肉类。
平滑到底救了什么
看表里"牛肉"在水果类出现 0 次。如果不加平滑,P(牛肉|水果) = 0,那么"牛肉便宜"属于水果类的概率就是 0.5 × 0 × ... = 0,与肉类类的比值变成 0 : 某数,模型会给出"100% 是肉类"这种过度自信的结论。
加了平滑后,0 次变成 1/14,两类仍然可以比较大小,只是水果类会得到一个小而合理的概率。平滑的作用不是"修正误差",而是把"没见过"从"不可能"降级为"很少见"。
3.实操步骤
- 准备 6 条带标签的训练数据,每条包含原文和一个类别名。
- 写一个分词函数,内部调用
jieba.cut,再用' '.join(...)拼回空格分隔的字符串——CountVectorizer靠空格切词。 - 用
CountVectorizer()对训练集调用fit_transform,一次完成"建词表"和"统计词频"两件事,得到 6 行 × 8 列的矩阵。 - 用
MultinomialNB(alpha=1.0)的fit训练,alpha就是平滑项。 - 预测时对测试文本调用
vectorizer.transform(...),不是fit_transform:重新 fit 会按测试文本重建词表,列的含义和训练时完全不同。 - 用
predict拿类别,用predict_proba拿置信度,两者一起看。
最后把模型学到的条件概率反推出来,和手算表逐格对照。
对应源码片段(代码8-1)
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn numpy
# 实测环境:Python 3.13.14 + jieba 0.42.1 + scikit-learn 1.9.1
import jieba
import numpy as np
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB

# 训练集:6 条,两类各 3 条,每条 2 个词
train = [('苹果多汁', '水果'), ('苹果新鲜', '水果'), ('香蕉多汁', '水果'),
         ('牛肉便宜', '肉类'), ('猪肉便宜', '肉类'), ('牛肉好吃', '肉类')]


def seg(text):
    # jieba.cut 返回生成器,用空格拼回去,CountVectorizer 才认
    return ' '.join(jieba.cut(text))


texts = [seg(t) for t, _ in train]     # 分词后的 6 条文本
labels = [y for _, y in train]         # 对应的类别

vectorizer = CountVectorizer()
X_train = vectorizer.fit_transform(texts)   # fit 建词表 + transform 统计词频
print('[诊断] 词表(%d 个):' % len(vectorizer.vocabulary_),
      list(vectorizer.get_feature_names_out()))
print('[诊断] 词频矩阵形状:', X_train.shape)

clf = MultinomialNB(alpha=1.0)         # alpha=1 即拉普拉斯平滑
clf.fit(X_train, labels)

for text in ['苹果多汁', '牛肉便宜', '苹果好吃']:
    X_test = vectorizer.transform([seg(text)])   # 只能 transform,不能重新 fit
    pred = clf.predict(X_test)[0]
    proba = clf.predict_proba(X_test)[0]
    print('文本:%s → 预测:%s   P(水果)=%.4f  P(肉类)=%.4f'
          % (text, pred, proba[0], proba[1]))

# 把模型学到的参数反推出来,与手算表逐格对照
print('\n[诊断] 先验概率:',
      dict(zip(clf.classes_, np.exp(clf.class_log_prior_).round(4))))
for i, c in enumerate(clf.classes_):
    p = np.exp(clf.feature_log_prob_[i])
    print('[诊断] %s 的条件概率:' % c,
          {k: round(float(v), 4)
           for k, v in zip(vectorizer.get_feature_names_out(), p)})
预期输出:词表 8 个词、矩阵 6 行 × 8 列;两条测试文本分别判为水果、肉类,置信度 0.90 / 0.10;条件概率表与手算的 3/14、2/14、1/14 完全一致。
【运行结果以及解析】
[诊断] 词表(8 个): ['便宜', '多汁', '好吃', '新鲜', '牛肉', '猪肉', '苹果', '香蕉']
[诊断] 词频矩阵形状: (6, 8)
文本:苹果多汁 → 预测:水果   P(水果)=0.9000  P(肉类)=0.1000
文本:牛肉便宜 → 预测:肉类   P(水果)=0.1000  P(肉类)=0.9000
文本:苹果好吃 → 预测:水果   P(水果)=0.6000  P(肉类)=0.4000

[诊断] 先验概率: {'水果': 0.5, '肉类': 0.5}
[诊断] 水果 的条件概率: {'便宜': 0.0714, '多汁': 0.2143, '好吃': 0.0714, '新鲜': 0.1429, '牛肉': 0.0714, '猪肉': 0.0714, '苹果': 0.2143, '香蕉': 0.1429}
[诊断] 肉类 的条件概率: {'便宜': 0.2143, '多汁': 0.0714, '好吃': 0.1429, '新鲜': 0.0714, '牛肉': 0.2143, '猪肉': 0.1429, '苹果': 0.0714, '香蕉': 0.0714}
思考题
- 把测试文本换成"苹果好吃",先手算再运行,看是否与 0.60 : 0.40 一致。
- 参考答案:手算
0.5 × 3/14 × 1/14 = 3/392对0.5 × 1/14 × 2/14 = 2/392,比值 3 : 2,归一化正好 0.60 : 0.40。这个练习的价值在于用冲突证据检验自己是否真的理解了"连乘取大者"——两个词指向不同类别时,比的是乘积,不是投票个数。
- 参考答案:手算
- 思考:如果换成水果 6 条、肉类 2 条,同样的文本会怎样?
- 参考答案:先验变成 0.75 : 0.25,水果类的乘积整体乘以 3,会更容易判成水果。这说明先验就是训练集类别比例的体现,也是不平衡数据会让模型偏向多数类的原因(知识点3 会看到这个问题的极端版本:89.7% 的准确率什么也证明不了)。
4.KMeans实现中文文本聚类
KMeans实现中文文本聚类
1.NLP知识点
- 聚类是无监督学习:训练数据没有类别标签,算法只按向量之间的相似度把样本分成组。
- 簇数 k 必须由人指定,算法不会自己判断"应该分成几类"。
- 簇编号(0、1、2…)只是代号,本身没有任何语义,需要人工查看簇内文本后再命名。
- KMeans 的迭代过程:随机选 k 个中心点 → 把每个样本分配给最近的中心 → 用簇内均值更新中心 → 重复直到收敛。
- 文本聚类同样要先向量化,本节用 TF-IDF 把每条文本变成向量后再交给 KMeans。
2.NLP理论知识点
KMeans:把 n 个样本分成 k 组,使得每组内部样本到自己组中心的距离之和最小。它没有办法穷举所有分法(那是指数级的),所以用迭代逼近:
第 0 步:随机挑 k 个样本当作初始中心点
第 1 步:把每个样本分给离它最近的那个中心
第 2 步:把每个中心移动到它那一组样本的均值位置
第 3 步:回到第 1 步,直到分组不再变化(或达到最大迭代次数)这个过程有一个重要性质:它一定会收敛,但不一定收敛到最好的分法。初始中心点选得不同,结果可能完全不同。这就是 random_state 和 n_init 存在的意义:
| 参数 | 作用 | 版本注意 |
|---|---|---|
random_state | 固定随机种子,保证每次跑出同样的结果 | 只保证可复现,不保证结果最优 |
n_init | 换几组初始中心点各跑一次,取 inertia 最小的那次 | sklearn 1.4 起默认值从 10 改成 'auto'(k-means++ 时只跑 1 次);想多次初始化要显式写 n_init=10 |
聚类结果评价不了"对错",因为根本没有标准答案。能评价的是两件事: 👇
簇内是否紧凑(同簇样本彼此像不像)、
簇间是否分离(不同簇彼此远不远)。
本节的数据为什么能被分开
12 条文本实际来自 3 个话题,每个话题 4 条,话题内部共享词、话题之间不共享词:
| 话题 | 4 条文本 | 话题内的共享词 |
|---|---|---|
| 水果 | 苹果多汁 / 苹果新鲜 / 香蕉多汁 / 香蕉新鲜 | 苹果、香蕉、多汁、新鲜 |
| 家电 | 冰箱保鲜 / 冰箱静音 / 空调制冷 / 空调静音 | 冰箱、空调、静音、保鲜、制冷 |
| 体育 | 球员进球 / 球队进球 / 球员精彩 / 球队精彩 | 球员、球队、进球、精彩 |
TF-IDF 会把每条文本变成 13 维空间里的一个点。同一个话题的两条文本至少共享一个词,余弦相似度大于 0;不同话题的两条文本一个词都不共享,相似度为 0。KMeans 要做的就是把"相似度大于 0 的点"归到一起——这就是聚类在文本上的全部含义。
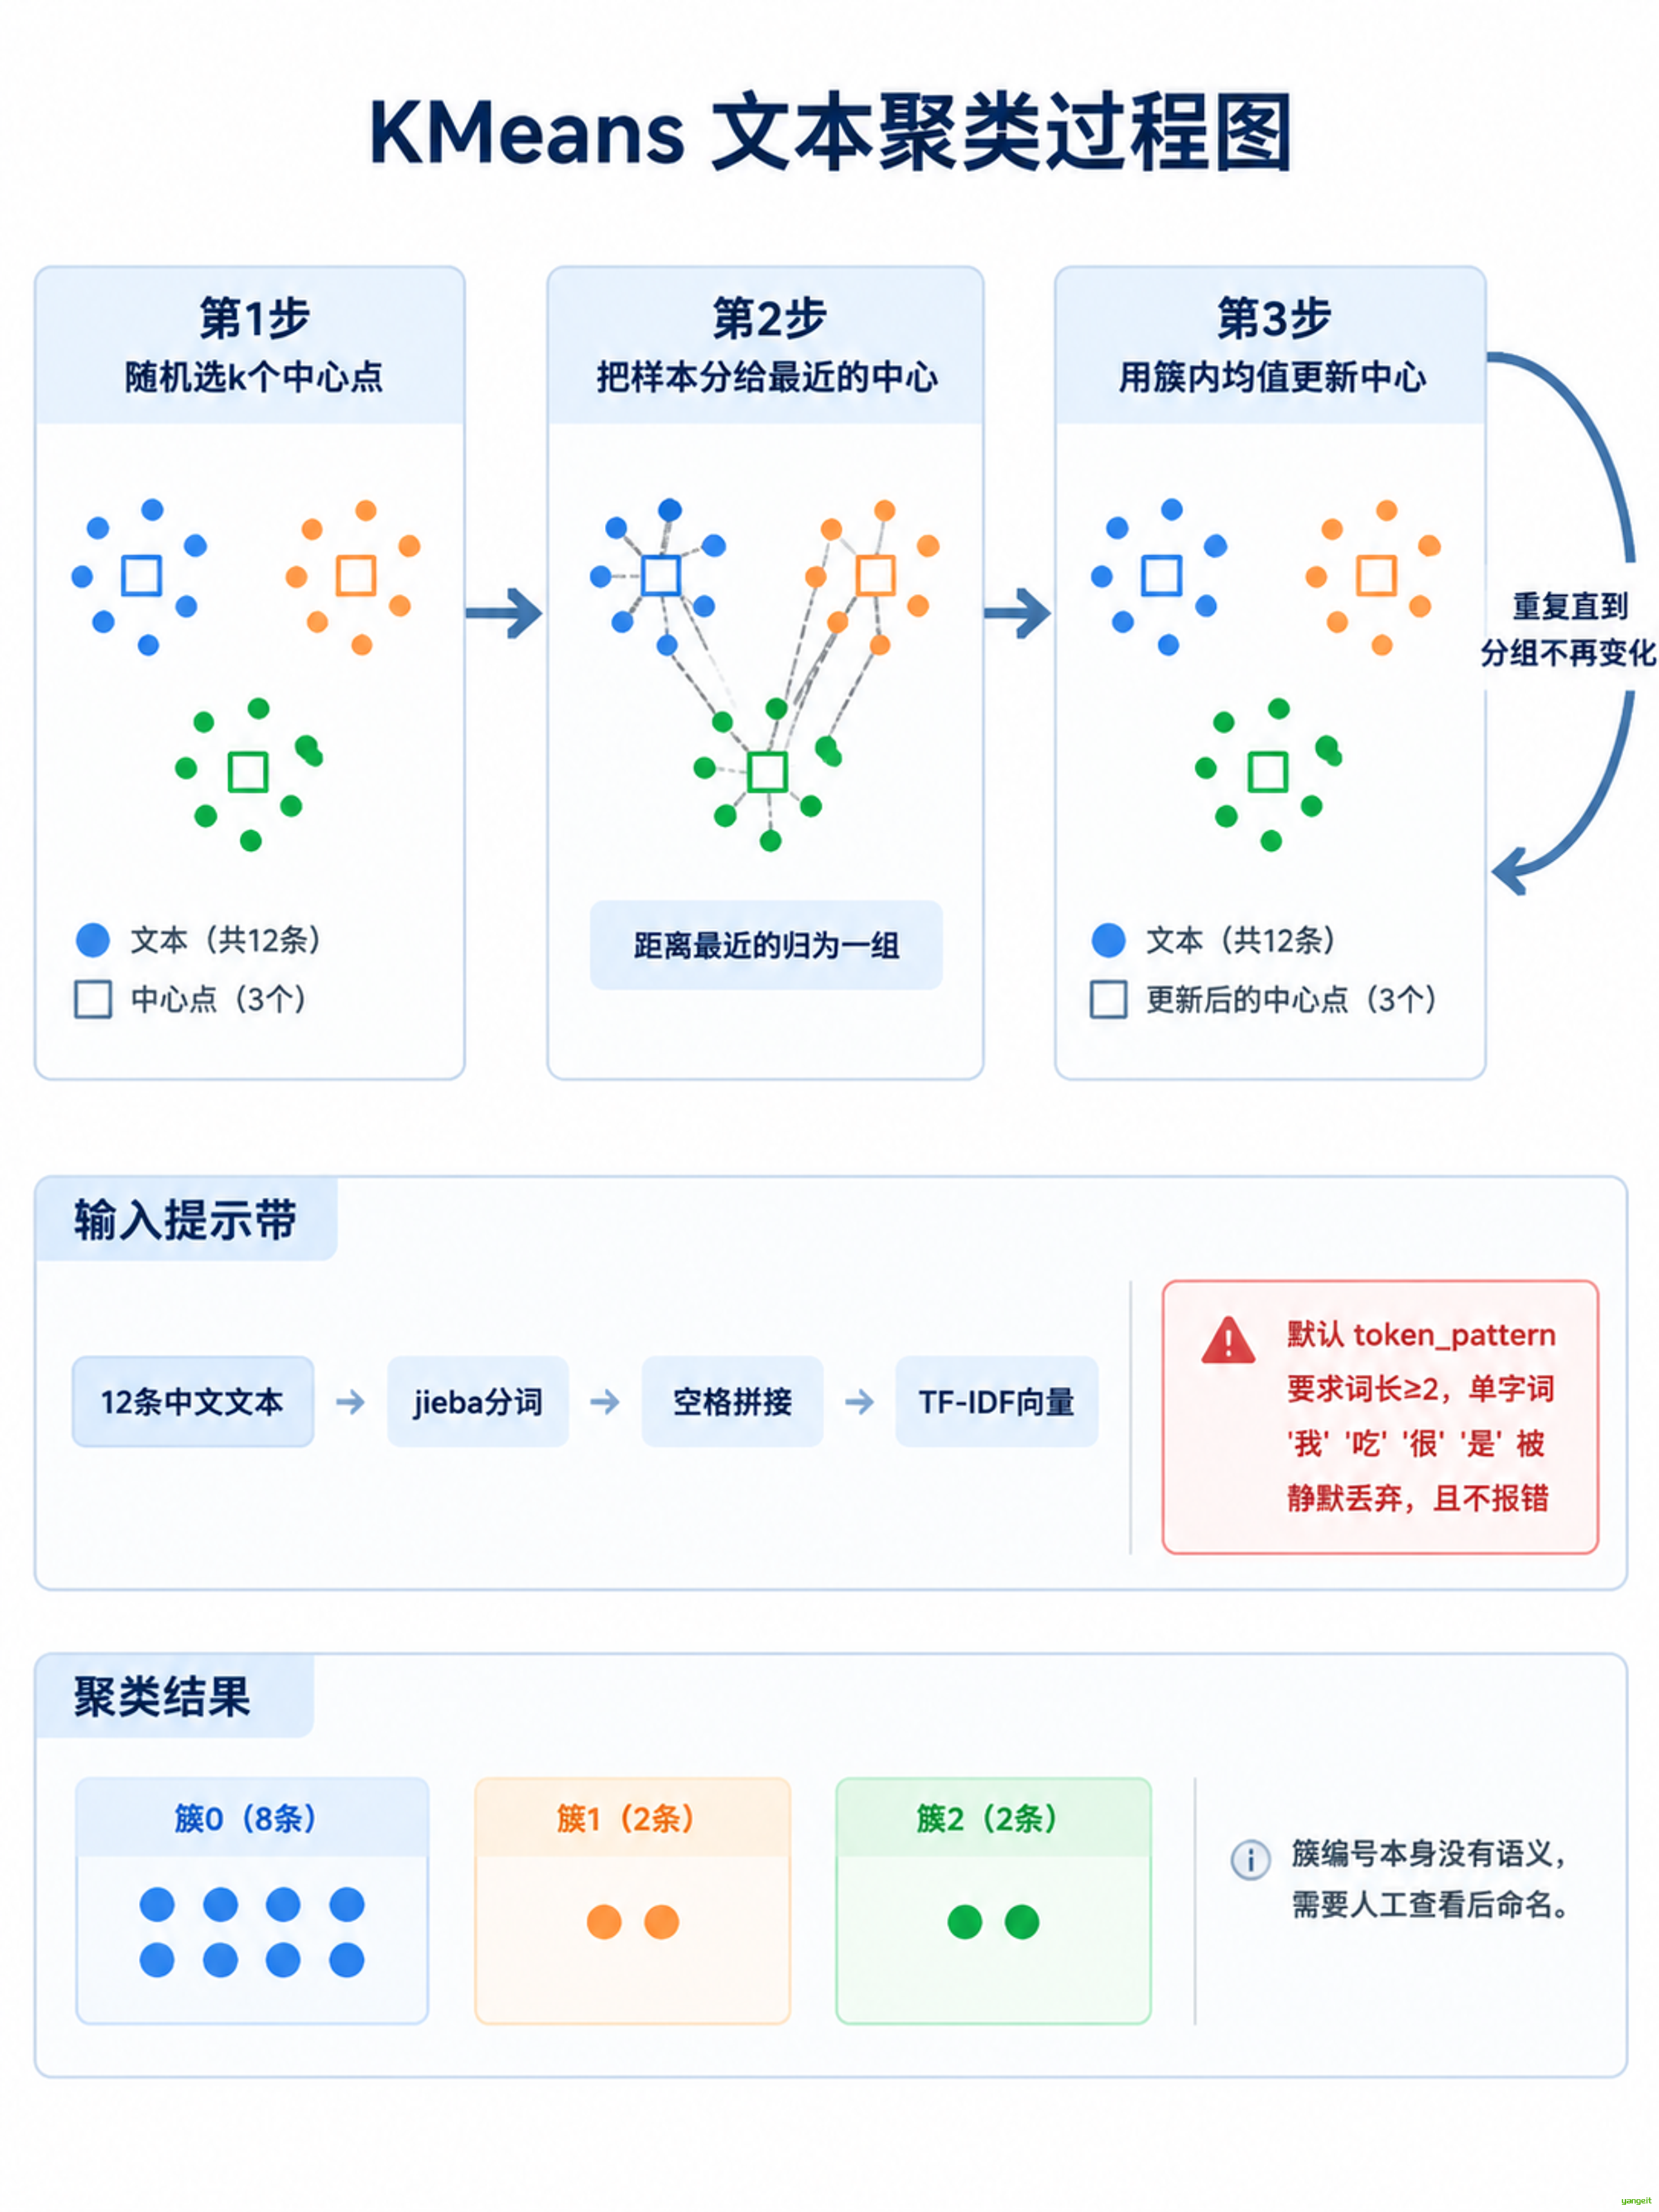
上图演示的是迭代过程本身;本节实际输出为三个簇各 4 条,详见下方运行结果。
3.实操步骤
- 准备 12 条无标签的中文文本,事先按"水果 / 家电 / 体育"三组组织,但不要把分组信息传给模型。
- 逐条用
jieba.lcut分词,再用' '.join(...)拼成空格分隔的字符串——这是TfidfVectorizer唯一认的输入格式,不拼空格的话整句话会被当成一个超长的词。 - 用
TfidfVectorizer()做向量化,得到 12 行 × 13 列的矩阵。 - 创建
KMeans(n_clusters=3, random_state=0, n_init=10):簇数 3 是人为指定的,random_state固定初始化以保证可复现,n_init=10让算法换 10 组初始中心点取最好的一次。 - 调用
fit训练——注意这里不传标签,这是聚类与分类最直观的差别。 - 从
labels_取出每条文本的簇编号,按簇分组打印,然后人工观察每个簇里都是什么内容并给它命名。
对应源码片段(代码8-2)
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn
# 实测环境:Python 3.13.14 + jieba 0.42.1 + scikit-learn 1.9.1
import jieba
from sklearn.cluster import KMeans
from sklearn.feature_extraction.text import TfidfVectorizer

# 12 条无标签文本:模型事先不知道有几类、每类是什么
texts = ['苹果多汁', '苹果新鲜', '香蕉多汁', '香蕉新鲜',     # 水果
         '冰箱保鲜', '冰箱静音', '空调制冷', '空调静音',     # 家电
         '球员进球', '球队进球', '球员精彩', '球队精彩']     # 体育

corpus = [' '.join(jieba.cut(t)) for t in texts]   # 分词后必须用空格拼接

tfidf = TfidfVectorizer() #TfidfVectorizer:文本特征提取器
X = tfidf.fit_transform(corpus) # fit_transform:先拟合再转换
print('[诊断] 词表(%d 个):' % len(tfidf.vocabulary_),
      list(tfidf.get_feature_names_out()))
print('[诊断] 特征矩阵形状:', X.shape)

# n_clusters 必须人为指定;n_init=10 表示换 10 组初始中心点取最优
km = KMeans(n_clusters=3, random_state=0, n_init=10)
km.fit(X)                                   # 聚类是无监督学习,不传标签
print('[诊断] 迭代次数:', km.n_iter_)
print('[诊断] 各簇样本数:',
      {int(c): int((km.labels_ == c).sum()) for c in range(3)})

# 按簇分组打印,比逐条打印更适合人工观察
for c in range(3):
    members = [texts[i] for i in range(len(texts)) if km.labels_[i] == c]
    print('簇%d(%d 条):' % (c, len(members)), ' / '.join(members))
【运行结果以及解析】
[诊断] 词表(13 个): ['保鲜', '冰箱', '制冷', '多汁', '新鲜', '球员', '球队', '空调', '精彩', '苹果', '进球', '静音', '香蕉']
[诊断] 特征矩阵形状: (12, 13)
[诊断] 迭代次数: 3
[诊断] 各簇样本数: {0: 4, 1: 4, 2: 4}
簇0(4 条): 冰箱保鲜 / 冰箱静音 / 空调制冷 / 空调静音
簇1(4 条): 球员进球 / 球队进球 / 球员精彩 / 球队精彩
簇2(4 条): 苹果多汁 / 苹果新鲜 / 香蕉多汁 / 香蕉新鲜
逐段读结果:
三个簇各 4 条,切得干干净净。 这不是巧合,而是数据本身的结构:三个话题内部共享词、话题之间零共享。KMeans 做的事情就是"把共享词的点抱成团",所以只要数据里有真实的团,它就能找到。
簇 0 是家电、簇 1 是体育、簇 2 是水果——但算法从没被告知这三个名字。 它只给出编号 0/1/2。名字是看了簇内文本之后人给加的。这就是"簇编号没有语义"的具体含义:换个
random_state,簇 0 完全可能变成水果,编号会重排,但簇内的 4 条仍然属于同一个话题。判断聚类好坏不能看编号,只能看簇内文本是否自洽。迭代 3 次就收敛了,说明这个结构很容易分。 第一次分配后中心点基本稳定,第二次再微调,第三次分组不再变化。真实数据(知识点4 的新闻)往往要更多次,而且可能收敛到不同的局部最优。
为什么这里用 TF-IDF 而朴素贝叶斯用词袋? 因为两者面对的模型不同:朴素贝叶斯要"计数",KMeans 要"距离"。TF-IDF 做了行归一化,让每条文本的向量长度为 1,比较的是方向(用词结构)而不是长度(文本长短),这对聚类更合适——否则一条长文本会因为向量模大而主导距离计算。
思考题
- 把
n_clusters分别改成 2 和 4,各跑一次,观察分组变化。- 参考答案:实测 k=2 时分成 8 / 4(水果和家电被合并成一个大簇,体育单独一簇);k=4 时分成 4 / 4 / 2 / 2(有一个真实话题被硬拆成两半)。这说明 k 的取值直接决定结果,而数据本身不会告诉你正确答案——k 小于真实话题数会合并,大于会拆分。
- 把
random_state改成 1、2、3,各跑一次,看簇编号和簇内成员有没有变化。- 参考答案:本例结构清晰,簇内成员三次都一致,变的是编号的顺序(比如簇 0 从家电变成体育)。这正好验证了"编号无语义、成员才有意义":比较两次聚类结果时,要比"谁和谁在一起",不能比"编号是几"。
- 思考:什么情况下应该选聚类而不是分类?
- 参考答案:拿不到标注数据、或者连"一共有几类"都不清楚的时候。典型场景是新业务冷启动(没有历史标注)、探索性分析(想看看用户反馈里都有哪些话题)、标注前的预分组(先聚类再人工标注,能大幅降低标注成本)。反过来,如果有标注数据且类别明确,分类的准确率和可解释性都远好于聚类——知识点3、知识点4 两个案例正好是这两种情况的对照。
5.垃圾短信分类案例
垃圾短信分类
1.NLP知识点
- 真实中文分类任务的第一步是拿到带标注的语料,本节用的是 677291 条中文短信,每条标注为"正常(0)"或"垃圾(1)"。
- 类别不均衡是真实语料的常态:本数据集里正常短信是垃圾短信的 8.7 倍,这个比例会直接影响模型行为和评价方式。
pandas.read_csv的index_col=0与header=None:前者把第一列当行索引,后者声明文件没有表头。- 预处理是一条完整链路:去重 → 去噪 → 加载自定义词典 → 分词 → 去停用词 → 过滤空结果,每一步都在缩小数据规模、提高信噪比。
- 平衡采样(欠采样):从多数类中随机抽取与少数类等量的样本,消除模型对多数类的偏好。
- 精确率与召回率是一对矛盾:一个看"判为垃圾的有多少真是垃圾",一个看"真正的垃圾抓到了多少",选哪个取决于业务代价。
2.NLP理论知识点
1️⃣ 第一步:先看清数据长什么样
读进来先做三件体检:看形状、看空值、看各类别各有多少条。
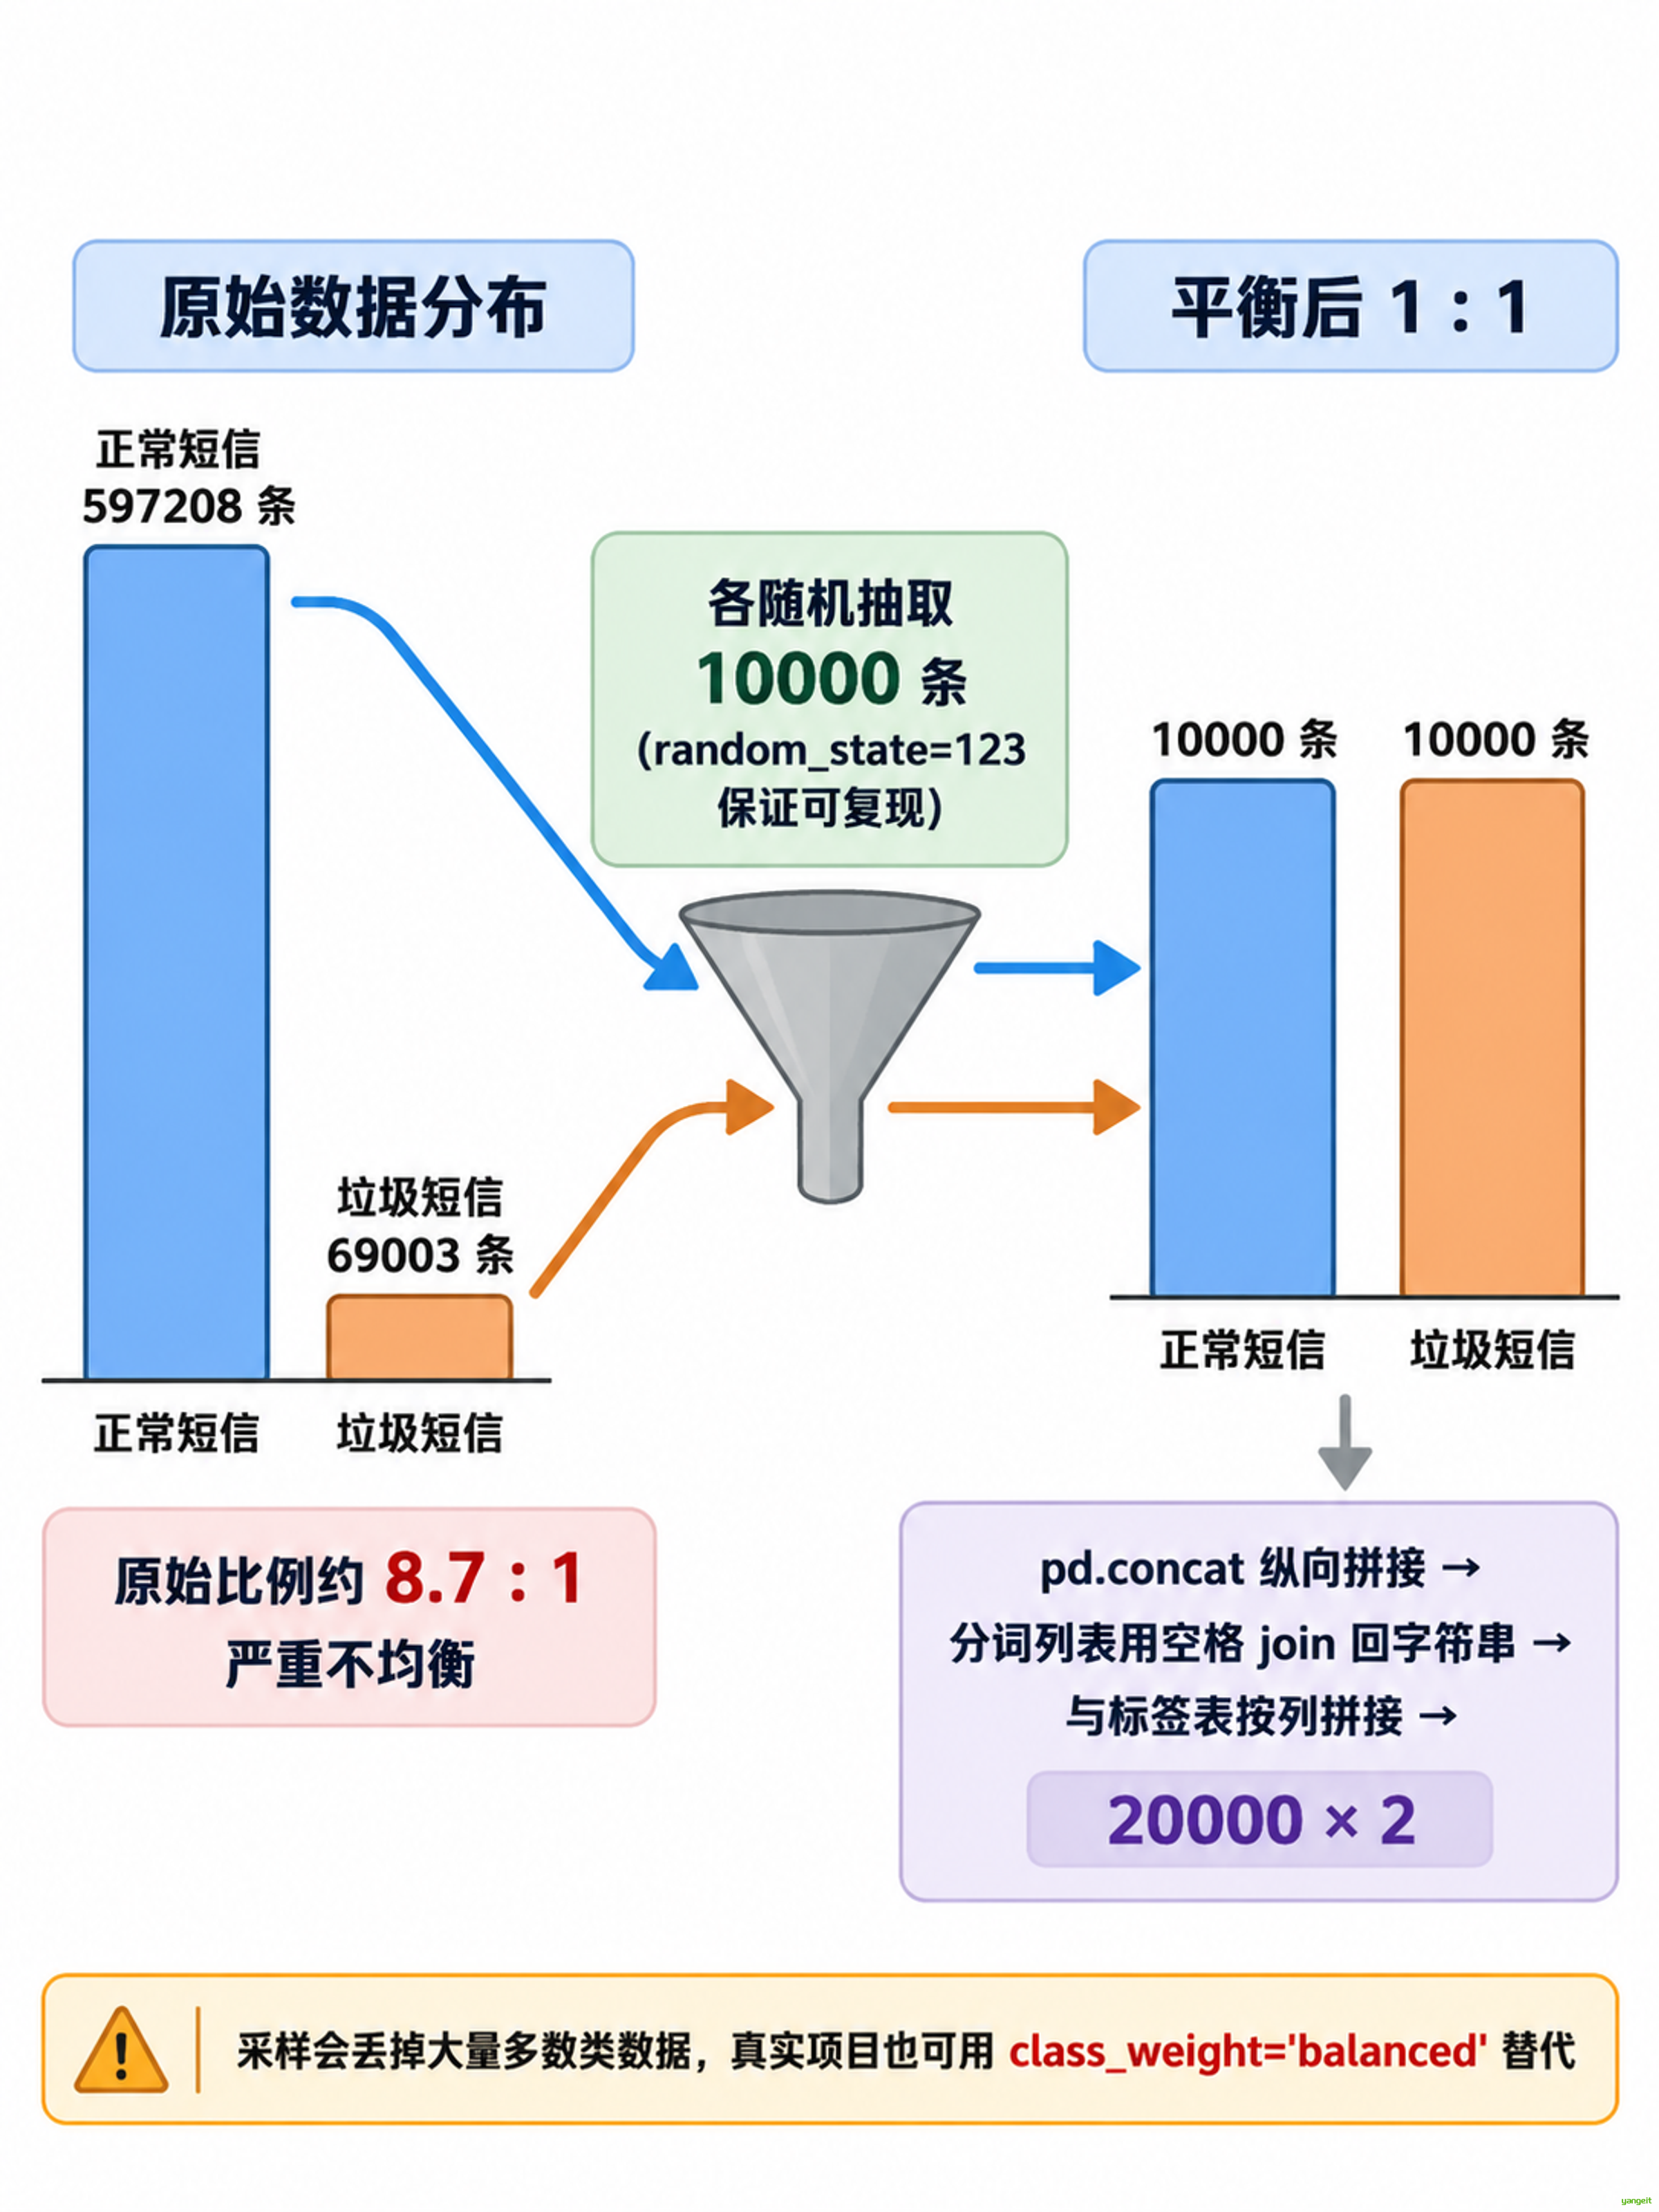
本数据集实测:正常 607510 条、垃圾 69781 条,比例约 8.7 : 1,垃圾只占 10.3%。
这个比例带来一个必须提前想清楚的问题——准确率陷阱:一个什么都不学、永远输出"正常"的模型,准确率就是 607510 / 677291 = 89.7%。这个数字看起来很漂亮,实际上一条垃圾短信都没拦住,召回率是 0。
所以在不均衡数据上,高准确率毫无意义。后面要做两件事来对付它:训练前做平衡采样(让两类等量),评价时看精确率和召回率(而不是只看准确率)。
2️⃣ 第二步:预处理链路
原始短信
→ 去重(drop_duplicates):群发模板会让同一条短信重复出现几百次
→ 去噪(re.sub 删掉指定的噪声字符):垃圾短信常用一长串 x 做占位或规避关键词
→ 加载自定义词典(jieba.load_userdict):防止"手机号""女人节"被切碎
→ 分词(jieba.cut)
→ 去停用词:去掉"的""了""是"这类高频但无区分度的词
→ 过滤分词后为空的记录:保证文本与标签一一对应
实测:677291 条原始短信 → 去重后 666360 条 → 过滤空列表后 666211 条,约 1.6% 的数据在这一步被淘汰。
3️⃣ 第三步:为什么要平衡采样
| 思路 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 欠采样 | 从多数类随机抽一部分,与少数类等量 | 训练快、数据均衡、实现简单 | 丢掉了大量多数类数据 |
| 过采样 | 把少数类复制多份,或合成新样本(如 SMOTE) | 不丢数据 | 容易过拟合,复制出的样本不带来新信息 |
| 调先验 | 给少数类更高的先验(朴素贝叶斯用 class_prior) | 不改动数据,保留全部信息 | 需要手动设定比例,调参更复杂 |
本节两类各抽 10000 条,合计 20000 条。采样后严格 1 : 1,模型不再有"猜多数类更划算"的捷径可走,必须真正去学两类文本的词分布差异。
597208 条正常短信只用了 10000 条,丢掉了 98.3%。真实项目里更推荐用
class_prior调先验或过采样,本节选欠采样是为了课堂演示的简洁与速度。
4️⃣ 第四步:向量化与训练
CountVectorizer 做两件事:fit 阶段扫描语料、建立词表(每个词分配一个列号);transform 阶段按这个词表统计每条文本的词频。
训练和预测必须共用同一个词表 —— 测试集用 cv.transform(x_test),一行搞定,绝不能重新 fit。
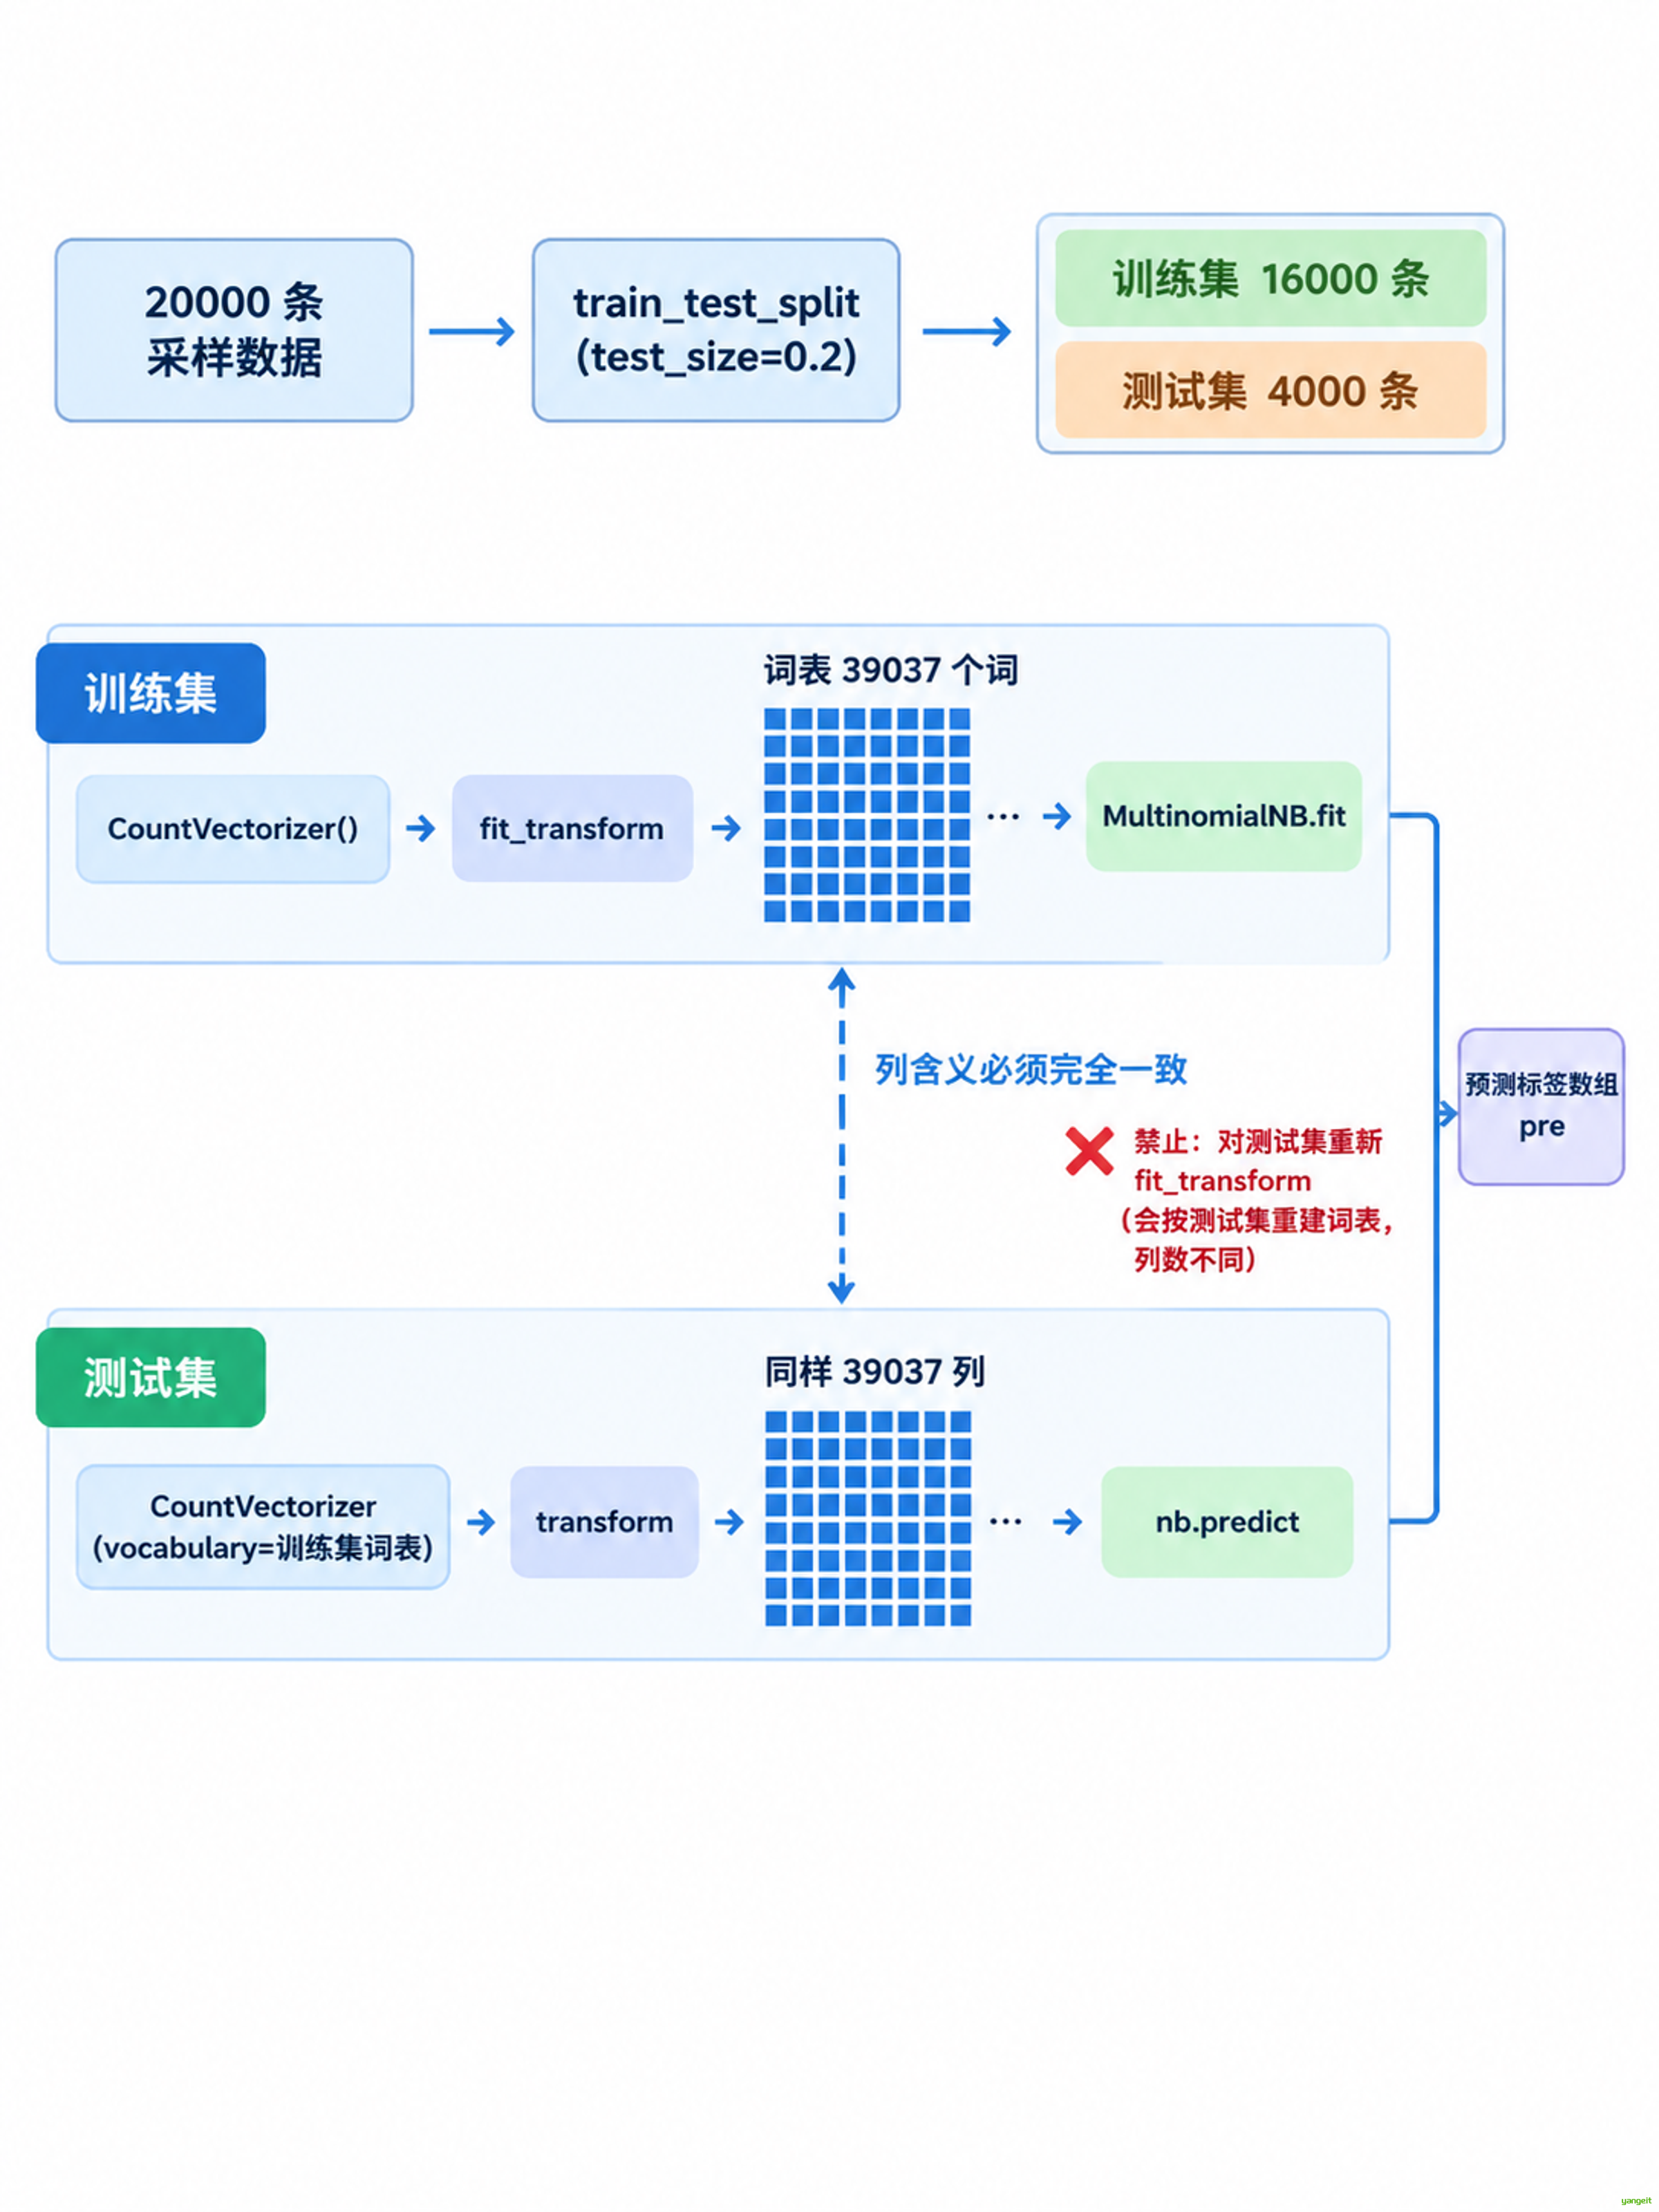
MultinomialNB 直接吃稀疏矩阵,不需要 toarray()。16000 × 39037 的矩阵约 6.2 亿个格子,转成稠密数组要 5 GB 内存,稀疏存储只要几十 MB。
这里有一个必须说明的真实损失:
CountVectorizer默认的token_pattern要求词长 ≥ 2,单字词会被静默丢弃。 上一节高频词表里的"元""号""折""送"都是单字,它们在本节的 39037 维词表里并不存在。这四个字恰恰是垃圾短信的强特征(元 13133 次、号 11615 次、折 10594 次、送 10576 次),丢掉它们等于丢了一批最有判别力的证据。
想让它们回来,只需在构造时加一个参数:
cv = CountVectorizer(token_pattern=r'(?u)\b\w+\b') # 允许单字词进词表这是本节模型精确率只有 0.89 的原因之一,也是可以直接动手改进的地方。
5️⃣ 第五步:混淆矩阵与四个指标
混淆矩阵的行是真实类别,列是预测类别。二分类下四个格子:
| 预测为 0(正常) | 预测为 1(垃圾) | |
|---|---|---|
| 真实为 0(正常) | TN 真阴性:正常短信判对了 | FP 假阳性:正常短信被误杀 |
| 真实为 1(垃圾) | FN 假阴性:垃圾短信漏网 | TP 真阳性:垃圾短信抓对了 |
由此定义出四个指标:
准确率 Accuracy  = (TP + TN) / 全部样本        整体判对的比例
精确率 Precision = TP / (TP + FP)              预测为垃圾的里面,有多少真是垃圾
召回率 Recall    = TP / (TP + FN)              真正的垃圾里,抓到了多少
F1 值            = 2 × P × R / (P + R)         精确率与召回率的调和平均
精确率和召回率是一对矛盾。
- 想把垃圾短信抓干净(高召回),就得放宽判定标准,代价是更多正常短信被误杀(低精确);
- 想保证不误杀(高精确),就得收紧标准,代价是更多垃圾漏网(低召回)。
在垃圾短信这个具体场景里,误杀的代价远大于漏网——用户的重要短信被扔进垃圾箱,比收到一条广告严重得多。所以真实系统通常优先保证精确率。反过来,在疾病筛查、故障预警这类场景里,漏检代价更大,就要优先保证召回率。选哪个指标不是技术问题,是业务问题。
3.实操步骤
- 用
pd.read_csv('./data/messages.csv', encoding='utf-8', index_col=0, header=None)读取数据,手动补列名['类别', '短信'],打印形状与类别分布做体检。 - 预处理:
drop_duplicates()去重 →re.sub('x', '', ...)去噪 →jieba.load_userdict('./data/newdic1.txt')加载业务词典 →jieba.cut分词 → 用set形式的停用词表过滤 →qustop.map(len) > 0丢掉空记录,再用同一批索引取标签。 - 从垃圾组和正常组各抽 10000 条,纵向拼接,把分词列表用
' '.join(...)拼回字符串,再与标签横向拼成一张 20000 行的表。 train_test_split(test_size=0.2, random_state=123)划分出 16000 条训练集和 4000 条测试集;训练集fit_transform建词表,测试集只transform。MultinomialNB训练并预测,最后用confusion_matrix与classification_report输出评价结果。
源码片段
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn pandas
# 实测环境:Python 3.13.14 + jieba 0.42.1 + scikit-learn 1.9.1 + pandas 3.0.5
import re
import jieba
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import MultinomialNB
from sklearn.metrics import confusion_matrix, classification_report

# ── 代码8-3:读取数据 ──────────────────────────────────
# index_col=0 把第 1 列当行索引;header=None 声明文件没有表头
data = pd.read_csv('./data/messages.csv', encoding='utf-8',
                   index_col=0, header=None)
data.columns = ['类别', '短信']
print('[1] 原始数据:', data.shape, ' 类别分布:', data.类别.value_counts().to_dict())

# ── 代码8-4:去重 → 去噪 → 分词 → 去停用词 ─────────────
temp = data.短信.drop_duplicates()                              # 去重
temp = temp.astype('str').apply(lambda x: re.sub('x', '', x))   # 删掉噪声字符 x

jieba.load_userdict('./data/newdic1.txt')                       # 业务词典
cut = temp.apply(lambda x: list(jieba.cut(x)))                  # 逐条分词

# sep 传一个文件里不存在的字符串:pandas 找不到分隔符,整行读成一列
stop = pd.read_csv('./data/stopword.txt', sep='ooo', encoding='gbk',
                   header=None, engine='python')
stop = set([' '] + list(stop[0]))                               # 用 set,in 判断 O(1)
qustop = cut.apply(lambda x: [w for w in x if w not in stop])   # 去停用词

# 丢掉分词后为空的记录;用同一批索引取标签,保证文本与标签一一对应
qustop = qustop[qustop.map(len) > 0]        # 向量化过滤,比逐条判断快几十倍
label = data.loc[qustop.index, '类别']
print('[2] 清洗后:', len(qustop), ' 类别分布:', label.value_counts().to_dict())

# ── 代码8-5:类别平衡采样(各 10000 条)─────────────────
num = 10000
spam = qustop.loc[label == 1].sample(num, random_state=123)     # 垃圾
norm = qustop.loc[label == 0].sample(num, random_state=123)     # 正常
sample = pd.concat([spam, norm])

my_data = pd.DataFrame({
    'message': sample.apply(lambda x: ' '.join(x)).values,      # 列表 → 空格分隔字符串
    'label': [1] * num + [0] * num})                            # 顺序与 sample 一致
print('[3] 采样后:', my_data.shape, ' 标签分布:', my_data.label.value_counts().to_dict())

# ── 代码8-6:词袋向量化 + 训练 ─────────────────────────
x_train, x_test, y_train, y_test = train_test_split(
    my_data.message, my_data.label, test_size=0.2, random_state=123)

cv = CountVectorizer() #CountVectorizer:词袋向量化
train_cv = cv.fit_transform(x_train)          # 训练集:学词表 + 统计词频
test_cv = cv.transform(x_test)                # 测试集:只复用训练集的词表
print('[4] 词袋矩阵:', train_cv.shape, ' / ', test_cv.shape,
      ' 词表:', len(cv.vocabulary_))

nb = MultinomialNB() #MultinomialNB:多项式朴素贝叶斯
nb.fit(train_cv, y_train)                     # 训练
pre = nb.predict(test_cv)                     # 预测

# ── 代码8-7:混淆矩阵 + 分类报告 ───────────────────────
print('[5] 混淆矩阵(行=真实,列=预测):')
# confusion_matrix:混淆矩阵
print(confusion_matrix(y_test, pre))
# classification_report:分类报告
print(classification_report(y_test, pre, digits=2))
【运行结果以及解析】
[1] 原始数据: (677291, 2)  类别分布: {0: 607510, 1: 69781}
[2] 清洗后: 666211  类别分布: {0: 597208, 1: 69003}
[3] 采样后: (20000, 2)  标签分布: {1: 10000, 0: 10000}
[4] 词袋矩阵: (16000, 39037) / (4000, 39037)  词表: 39037
[5] 混淆矩阵(行=真实,列=预测):
[[1779  236]
 [  29 1956]]
              precision    recall  f1-score   support

           0       0.98      0.88      0.93      2015
           1       0.89      0.99      0.94      1985

    accuracy                           0.93      4000
   macro avg       0.94      0.93      0.93      4000
weighted avg       0.94      0.93      0.93      4000
评价结果解析
原始 677291 条,正常 : 垃圾 = 607510 : 69781 ≈ 8.7 : 1。 记住这个比例,它是后面所有决策的起点。如果直接在原数据上训练,"永远输出正常"就有 89.7% 的准确率——这个数字不是模型能力,是数据比例的影子。
清洗后剩 666211 条,淘汰了约 1.6%。 去重淘汰 10931 条(群发模板),过滤空列表淘汰 149 条(正文被停用词吃光)。淘汰量不大,但去重是必要的:同一条模板短信在训练集里出现几百次,模型只会背模板。
采样后严格 1 : 1,各 10000 条。 从这一刻起,"乱猜"的准确率基线从 89.7% 降到 50%,模型拿到的任何高于 50% 的成绩才是真本事。平衡采样改变的不是数据量,是评价的参照系。
词表 39037 维,来自 16000 条训练短信。 平均每条短信只对应约 2.4 个词表词,说明短信文本极短、用词极分散(人名、地名、商品名、号码碎片)。矩阵 16000 × 39037 约 6.2 亿个格子,必须用稀疏格式存。
混淆矩阵(行=真实,列=预测):
预测为 0(正常) 预测为 1(垃圾) 真实为 0(正常) TN = 1779 FP = 236 真实为 1(垃圾) FN = 29 TP = 1956 FN = 29说明垃圾短信几乎全抓到了;FP = 236说明有 236 条正常短信被误杀。这两类错误的数量差(29 vs 236)就是模型"宁可错杀"的直接证据。两类的表现极不对称,这是本结果里最有价值的信息:
- 正常短信(类别 0):精确率 0.98、召回率 0.88。2015 条正常短信里有 236 条被误判成垃圾,误杀率 11.7%。
- 垃圾短信(类别 1):精确率 0.89、召回率 0.99。1985 条垃圾短信里只有 29 条漏网(1.5%),但被判为垃圾的里面约有 11% 其实是正常短信。
把这个和业务对齐:垃圾短信过滤最怕误杀(用户的重要短信被扔进垃圾箱),而当前模型每 100 条正常短信就误杀约 12 条。真上线的第一件事应该是把判定阈值调严、优先保精确率,代价是召回率下降。
macro avg 与 weighted avg 都是 0.93~0.94,几乎相同。 因为采样后两类样本数接近(2015 / 1985),加权几乎不产生影响。若换成原始的 8.7 : 1 数据,两者会明显分开,此时应以 macro avg 为准。
建模前的词频体检(可选)
正式训练前,按类别统计高频词,能提前确认"两类文本到底差在哪"。实测结果:
| 垃圾短信高频词 | 次数 | 正常短信高频词 | 次数 |
|---|---|---|---|
| 活动 | 17010 | 手机 | 28910 |
| 元 | 13133 | 年 | 18087 |
| 号 | 11615 | 说 | 15824 |
| 折 | 10594 | 电脑 | 15527 |
| 送 | 10576 | 南京 | 15284 |
| 您好 | 9867 | 飞机 | 15034 |
| 优惠 | 9576 | 百度 | 10276 |
| 全场 | 6207 | 医院 | 9666 |
垃圾短信是清一色的促销话术(活动、元、折、送、您好、优惠),正常短信是日常聊天和生活信息(手机、说、电脑、南京、飞机、医院)。看到这两组词,就能确信"用词的差异足以区分两类短信",后面建模是有依据的。 建模前先做这个体检,能避免"数据本身就没区分度却怪模型不准"。
思考题
把
CountVectorizer改成CountVectorizer(token_pattern=r'(?u)\b\w+\b'),让单字词进入词表,重新训练并对比四项指标。- 参考答案:词表会从 39037 涨到五万以上("元""号""折""送"等单字重新出现),精确率通常会有提升,因为这几类单字正是垃圾短信的强特征。这个练习直接验证了上一节说的"单字丢弃是真实损失",也说明特征工程的收益往往比调模型参数更直接。
思考:如果业务要求"误杀率必须低于 2%",当前模型达标了吗?该往哪个方向调?
- 参考答案:当前误杀率 = 236/2015 = 11.7%,远高于 2%,差了近 6 倍。要达标需要提高判定阈值(让模型更保守地判垃圾),代价是召回率明显下降。这就是精确率—召回率权衡在真实业务中的样子:没有一个模型能同时把两个指标拉满,只能按业务代价选一个平衡点。
具体怎么调:调阈值,把MultinomialNB的threshold参数从 0.5 调高,比如 0.6、0.7、0.8。调阈值是调模型参数,但不是调模型本身,所以不需要重新训练。
代码如下:
nb.threshold = 0.6 pre = nb.predict(test_cv) print('[5] 混淆矩阵(行=真实,列=预测):') print(confusion_matrix(y_test, pre))- 参考答案:当前误杀率 = 236/2015 = 11.7%,远高于 2%,差了近 6 倍。要达标需要提高判定阈值(让模型更保守地判垃圾),代价是召回率明显下降。这就是精确率—召回率权衡在真实业务中的样子:没有一个模型能同时把两个指标拉满,只能按业务代价选一个平衡点。
6.中文新闻主题聚类案例
中文新闻主题聚类
1.NLP知识点
- JSON 行式存储(JSON Lines):文件里每一行是一个独立的 JSON 对象,支持逐行流式读取,几个 GB 的语料也不会一次载入内存。
- 按文件名做类别标签:
从政.json→ 类别"从政",省去额外的标签文件。 - 固定位置切分数据集:每个文件前 400 条作训练集、后 100 条作测试集,四类在两边都严格等量。
- 文本清洗:新闻正文里常混入制表符、回车、换行,用正则
[\t\r\n]统一清除。 - 聚类纯度(Purity):对每个簇取簇内占比最大的真实类别作为该簇的名字,统计"按这个名字能认对多少样本"。
- 标签在聚类里的特殊角色:训练阶段完全不用标签,标签只在评估阶段出现——它是考卷,不是输入。
2.NLP理论知识点
1.案例全景:七步流水线
data/json/ 4 个文件--->一张表
   │ ① 读 JSON    逐行读、取 contentClean、文件名当标签、前 400 / 后 100
   ▼
原始新闻文本  1600 / 400
   │ ② 分词       jieba 精确模式 + 去停用词 + 空格拼回
   ▼
"股市 上涨 通胀 预期" 这样的字符串
   │ ③ 词频       CountVectorizer → 词频矩阵
   │ ④ TF-IDF     TfidfTransformer → TF-IDF 矩阵
   ▼
1600 × 61533 的特征向量
   │ ⑤ KMeans     fit 训练 / predict 预测
   ▼
每条新闻的簇编号(0 / 1 / 2 / 3)
   │ ⑥ 评估       纯度 + 交叉表
   ▼
0.6706(训练)  0.6825(测试)
│ ⑦ 读结果 给簇起名、解释这个数从哪来| 步骤 | 做什么 | 解决什么问题 |
|---|---|---|
| ① 读 JSON | 4 个文件 → 一张表 | 把散落的语料变成规整的样本和标签 |
| ② 分词 | 中文切词、去停用词 | 中文没有空格,不切词整句就是一个"词" |
| ③ 词频 | 文本 → 计数向量 | 让算法能"看见"词 |
| ④ TF-IDF | 计数 → 加权向量 | 压掉到处都有的虚词、消除文档长短差异 |
| ⑤ KMeans | 向量 → 簇编号 | 按距离把相似的新闻归堆 |
| ⑥ 评估 | 簇编号 + 标签 → 纯度 | 在没有标准答案的前提下算出一个分数 |
| ⑦ 读结果 | 交叉表 → 簇名 + 结论 | 把数字变成能说给人听的判断 |
七步里只有第 ⑤ 步是聚类本身,前四步都在"把文本变成可比的距离"。 文本任务里特征工程占的篇幅远大于算法,真实分工也是这样的。
2. 词频矩阵 —— CountVectorizer 学词表 👇
CountVectorizer.fit 只学一样东西:词表。
扫描全部训练文档 → 把出现过的词收集起来 → 排序 → 每个词分配一个列号
词表 = {通胀: 1234, 股市: 887, 球员: 5120, …}   61533 个词 → 61533 列

1234它代表"通胀"这个词在词表里的位置,也就是"第 1234 列"。
transform 就是拿这张"列号对照表"去查:文档里某个词在第几列,就在那一列的格子里 +1。
矩阵的每一行是一篇新闻,每一列是一个词,格子里是"这个词在这篇新闻里出现了几次"。
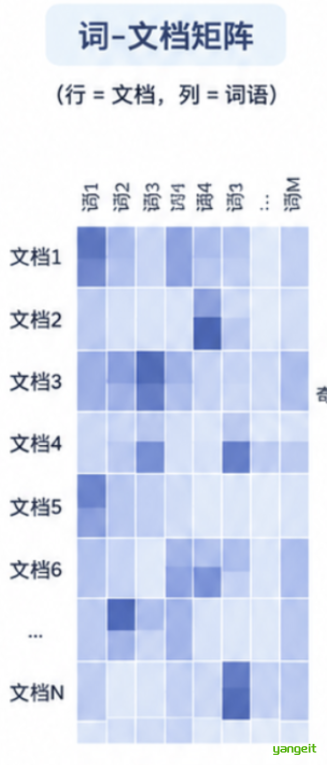
训练集用 fit_transform(既建表又查表),测试集只能用 transform(只查表)。 测试集一旦重新 fit,建出的是一张全新的列号表,和训练时的那张对不上。
3. TF-IDF —— 压制高频、消除长短差异
词频矩阵有一个致命问题:谁出现得多,谁嗓门就大。
"表示" 出现 20 次   ← 几乎每篇新闻都有,毫无区分度
"通胀" 出现  3 次   ← 只有经济新闻有,信息全在这
词频矩阵里 20 > 3,KMeans 算距离时"表示"贡献了 6.7 倍的距离。两篇毫不相干的新闻,只因为都堆满"表示、记者、报道",就被算成"很近"。
TfidfTransformer 修正两件事。
第一件:乘 IDF,压掉到处都有的词。
IDF(词) = ln((1 + 总文档数) / (1 + 含该词的文档数)) + 1| 词 | 出现在多少篇 | IDF 约值 | 含义 |
|---|---|---|---|
| 表示 | 800 / 1600 | 1.69 | 一半文章都有,几乎不算信息 |
| 通胀 | 6 / 1600 | 6.59 | 只有少数文章有,强特征 |
回到上面的例子:词频 20 : 3(差 6.7 倍)→ TF-IDF 20 × 1.69 : 3 × 6.59 ≈ 34 : 20(差 1.7 倍)。IDF 不是让虚词消失,是让它闭嘴。
第二件:按行做 L2 归一化,消除文档长短差异。
3000 字的长新闻在词频矩阵里每个格子都大,跟谁的欧氏距离都大,会被甩成孤立的簇。归一化后所有向量长度都是 1,比的只剩方向,也就是"用词分布像不像"。
对单位向量还有一个性质:
‖x − y‖² = ‖x‖² + ‖y‖² − 2x·y = 2 − 2cosθ归一化之后,欧氏距离和余弦相似度一一对应。所以"TF-IDF + L2 归一化 + KMeans"在效果上就等于"余弦距离聚类",只是借用了 KMeans 的迭代框架。
4.KMeans —— 训练一次,预测多次
三个方法必须分清:
| 方法 | 做什么 | 用在谁身上 |
|---|---|---|
fit(X) | 在 X 上训练模型,更新中心点 | 训练集 |
predict(X) | 用已有模型给 X 打簇编号,不改模型 | 测试集 / 新数据 |
fit_predict(X) | 先在 X 上训练,再返回 X 的簇编号 | 只想快速拿到分组、不需要复用模型时 |
5.评估 —— 纯度与交叉表
聚类没有标准答案,但本节的数据集有真实类别(文件名给的),所以可以事后对答案。纯度是最直观的指标:
对每个簇:数一数簇内哪个真实类别最多,把"最多的那个数量"记下来
纯度 = 各簇最大值之和 / 样本总数
它的含义是:如果给每个簇起一个名字(取簇内最多的类别),有多少比例的样本会被分对这个名字。
用一个 8 条样本的迷你例子手算一遍:
样本:水果 4 条、家电 4 条,被聚成 2 个簇
簇 0:水果 4 条、家电 2 条  → 最多的类别是水果,认对 4 条
簇 1:水果 0 条、家电 2 条  → 最多的类别是家电,认对 2 条
纯度 = (4 + 2) / 8 = 0.75
6.读结果 —— 给簇起名,解释这个数
拿到簇编号之后还有三件事,代码一件都替你做不了:
第一件,给簇起名。 输出里只有簇 0/1/2/3,没有"这是体育新闻"。名字是人看了簇内文本之后才起的,这个动作本身是聚类落地时最耗人力的一步。
第二件,看交叉表。 纯度只是一个数,交叉表才能说明这个数怎么来的:哪几个簇干净、哪几个簇是杂烩、哪一类被硬拆开了。
第三件,归因。 分不干净可能是三种原因,一个纯度数字分不清是谁的锅:
| 换什么 | 如果纯度上升 | 说明问题在 |
|---|---|---|
加 min_df 或 SVD 降维 | 上升 | 特征表示:低频噪声词太多 |
| 换 DBSCAN / 层次聚类 | 上升 | 算法:KMeans 的球形、等大假设不成立 |
| 怎么换都不动 | 不动 | 数据:类别之间用词本来就重叠 |
KMeans 在高维 TF-IDF 上表现一般,具体有三个原因:
| 原因 | 具体表现 |
|---|---|
| 维度灾难 | 61533 维空间里,样本之间的距离趋于一致,"最近的簇"失去区分度 |
| 簇形状假设 | KMeans 假定簇是球形、大小相近,真实文本簇形状不规则、大小悬殊 |
| 稀疏向量 | 大量 0 会把中心点拉向原点,中心点本身的可解释性变差 |
改进方向:先降维(LSA / 截断 SVD,降到 100~300 维)再做 KMeans。文本聚类里,降维往往就是去噪,因为高维里绝大多数是只出现一两次的词。
3.实操步骤
- 读数据:
os.listdir遍历 4 个 JSON,readline()逐行解析,取contentClean并用正则清洗;os.path.splitext(file)[0]取文件名当标签;每个文件前 400 条作训练、后 100 条作测试。 - 分词:停用词读成
set(in判断 O(1)),seg_word()里用jieba.cut(cut_all=False)精确模式,过滤停用词后用空格拼回字符串。 - 词频:
CountVectorizer().fit_transform(train_corpus)建词表并计数,测试集用transform复用同一张词表。 - TF-IDF:
TfidfTransformer().fit_transform(...)加权并归一化,测试集用transform;打印两个shape确认列数相等。 - 聚类:
KMeans(n_clusters=4, random_state=4).fit(train_weight),测试集用predict,不重新训练。 - 评估:
purity()分别算训练集和测试集纯度,各输出一张交叉表。 - 读结果:按交叉表给 4 个簇起名,说明哪几类混在一起、为什么混。
演示代码
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn pandas
# 实测环境:Python 3.13.14 + jieba 0.42.1 + scikit-learn 1.9.1 + pandas 3.0.5
import json
import os
import re
import jieba
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer, TfidfTransformer
from sklearn.cluster import KMeans

# ── 代码8-8(第 1 步):逐行读取 JSON 语料,按文件名打标签 ─────
train_data, test_data = pd.DataFrame(), pd.DataFrame()
for file in os.listdir('./data/json/'):
    with open('./data/json/' + file, 'r', encoding='utf-8') as f:
        content = []
        while True:
            line = f.readline()                    # 逐行读,适合大文件
            if not line:
                break
            obj = json.loads(line)                 # 每行一个独立 JSON 对象
            content.append(re.sub('[\t\r\n]', '', obj['contentClean']))
    df = pd.DataFrame(content)
    df[1] = os.path.splitext(file)[0]              # 文件名(去扩展名)= 类别

    train_data = pd.concat([train_data, df[:400]], ignore_index=True)   # 前 400 条训练
    test_data = pd.concat([test_data, df[400:]], ignore_index=True)     # 后 100 条测试
print('[1] 训练集/测试集:', train_data.shape, test_data.shape)
print('    训练集类别分布:', train_data[1].value_counts().to_dict())

# ── 代码8-9(第 2 步):分词函数(训练集与测试集必须用同一个)───
stop = pd.read_csv('./data/stopwords.txt', sep='bucunzai', encoding='utf-8',
                   header=None, engine='python')
stop = set([' '] + list(stop[0]))


def seg_word(data):
    corpus = []
    for i in range(len(data)):
        string = data.iloc[i, 0].strip()                    # 取正文,去首尾空白
        words = [w for w in jieba.cut(string, cut_all=False)  # 精确模式分词
                 if w not in stop]                          # 过滤停用词
        corpus.append(' '.join(words))                      # 拼成空格分隔字符串
    return corpus


train_corpus = seg_word(train_data)
test_corpus = seg_word(test_data)


print('[2] 分词完成:', len(train_corpus), len(test_corpus))

# ── 代码8-10(第 3、4 步):词频 → TF-IDF(测试集只能 transform)─
vectorizer = CountVectorizer()          # 文本 → 词频矩阵
tfidf = TfidfTransformer()              # 词频矩阵 → TF-IDF 矩阵

train_weight = tfidf.fit_transform(vectorizer.fit_transform(train_corpus)).toarray()
test_weight = tfidf.transform(vectorizer.transform(test_corpus)).toarray()
print('[3] 特征矩阵:', train_weight.shape, test_weight.shape,
      ' 列数一致:', train_weight.shape[1] == test_weight.shape[1])


# ── 代码8-11(第 5、6 步):KMeans 训练 + 训练集纯度 ──────────
# 这里不写 n_init=10:61533 维稠密矩阵上跑 10 组初始化约需 3 分钟;
# 默认 n_init='auto' 只跑 1 组,结果完全相同,速度快 10 倍
km = KMeans(n_clusters=4, random_state=4)
km.fit(train_weight)                    # 只在训练集上训练一次
print('[4] 中心点形状:', km.cluster_centers_.shape, ' 迭代次数:', km.n_iter_)
print('    各簇样本数:', pd.Series(km.labels_).value_counts().to_dict())


def purity(labels, truth):
    """纯度:每个簇取簇内最多的真实类别,统计被"命名正确"的样本比例"""
    df = pd.DataFrame({'簇': labels, '真实': truth})
    correct = sum(df[df['簇'] == c]['真实'].value_counts().iloc[0]
                  for c in df['簇'].unique())
    return df, correct, correct / len(df)


df_train, c_train, p_train = purity(km.labels_, train_data[1].values)
print('[5] 训练集纯度 = %d / %d = %.4f' % (c_train, len(df_train), p_train))
print(pd.crosstab(df_train['簇'], df_train['真实']))

# ── 代码8-12(第 5、6 步):测试集用 predict,不重新训练 ───────
test_labels = km.predict(test_weight)   # 不能写 fit_predict
df_test, c_test, p_test = purity(test_labels, test_data[1].values)
print('[6] 测试集纯度 = %d / %d = %.4f' % (c_test, len(df_test), p_test))
print(pd.crosstab(df_test['簇'], df_test['真实']))
【运行结果以及解析】
[1] 训练集/测试集: (1600, 2) (400, 2)
    训练集类别分布: {'从政': 400, '体育': 400, '国际': 400, '经济': 400}
[2] 分词完成: 1600 400
[3] 特征矩阵: (1600, 61533) (400, 61533)  列数一致: True
[4] 中心点形状: (4, 61533)  迭代次数: 10
    各簇样本数: {2: 619, 1: 589, 3: 203, 0: 189}

[5] 训练集纯度 = 1073 / 1600 = 0.6706
真实   从政   体育   国际   经济
簇
0       1      0      9    179
1      27     35    327    200
2     170    365     64     20
3     202      0      0      1

[6] 测试集纯度 = 273 / 400 = 0.6825

真实  从政   体育   国际   经济
0     0      0      1     42
1     3      7     79     51
2    38     93     20      6
3    59      0      0      1
解析
第 5 步:中心点形状 (4, 61533),迭代 10 次,四个簇 619 / 589 / 203 / 189。 中心点的形状是"簇数 × 特征数",4 个中心点、每个 61533 维——这正是"高维"的具体样子。
第 6 步:训练集纯度 0.6706 = 1073 / 1600。 看交叉表,每个簇取最大值:
| 簇 | 从政 | 体育 | 国际 | 经济 | 该簇主导类别 | 最大值 |
|---|---|---|---|---|---|---|
| 0 | 1 | 0 | 9 | 179 | 经济(很纯) | 179 |
| 1 | 27 | 35 | 327 | 200 | 国际(较杂) | 327 |
| 2 | 170 | 365 | 64 | 20 | 体育(较纯) | 365 |
| 3 | 202 | 0 | 0 | 1 | 从政(非常纯) | 202 |
179 + 327 + 365 + 202 = 1073,1073 / 1600 = 0.6706。读法就是"每个簇认一个主类别,认对了 67% 的样本"。
只有两个簇是干净的:簇 3 几乎完美地聚出了从政新闻(202 / 205),簇 0 基本聚出了经济类(179 / 189)。 簇 1 是个大杂烩(国际 327 + 经济 200 + 体育 35 + 从政 27),簇 2 里也混着 170 篇从政。纯度 0.67 的全部损失都来自这两个不干净的簇。
为什么"经济"会被拆成两半(簇 0 有 179、簇 1 有 200)? 因为 KMeans 必须分出 4 个球形簇,而"国际"和"经济"两类新闻在用词上高度重叠(都谈贸易、政策、国家),它们的样本在向量空间里连成一片,KMeans 只能从中间切开。这是 KMeans"假定簇是球形、大小相近"这个前提与真实数据不符的直接后果。
第 6 步(测试集):纯度 0.6825 = 273 / 400,与训练集的 0.6706 只差 1.2 个百分点。 这才是真正有意义的对比:模型没有在训练集上"背答案",聚类结构可以泛化到未见过的 400 篇新闻。
而且测试集各簇的"性格"与训练集完全一致——簇 3 依然是从政(59)、簇 2 依然是体育(93)、簇 0 依然是经济(42)、簇 1 依然是"国际为主的大杂烩"(79)。这种一致性说明聚类抓到了稳定的主题结构,不是随机分组。
第 7 步:0.67 是什么水平? 四个类别随机猜的基线约 0.25,0.67 确实远高于随机,但离可用(通常要求 0.85 以上)还有明显距离。按第 7 步的归因表,这里最可能的原因是特征表示:61533 维里绝大多数是只出现一两次的词。所以第一步该做的不是换算法,而是降维——加 min_df=3 或截断 SVD 到 100~300 维。
思考题
- 思考:为什么聚类任务也要划分训练集和测试集?聚类不是不需要标签吗?
- 参考答案:聚类训练确实不需要标签,但评价需要。划分出一份"模型没见过"的测试集,才能检验聚类结构是否可泛化,而不只是记住了训练样本的分组。本节用真实类别算纯度,这个标签虽然不参与训练,但参与评价——评价集必须独立,否则指标就是自欺欺人。
7.阿里云中文新闻主题分类案例
前言
1.NLP知识点
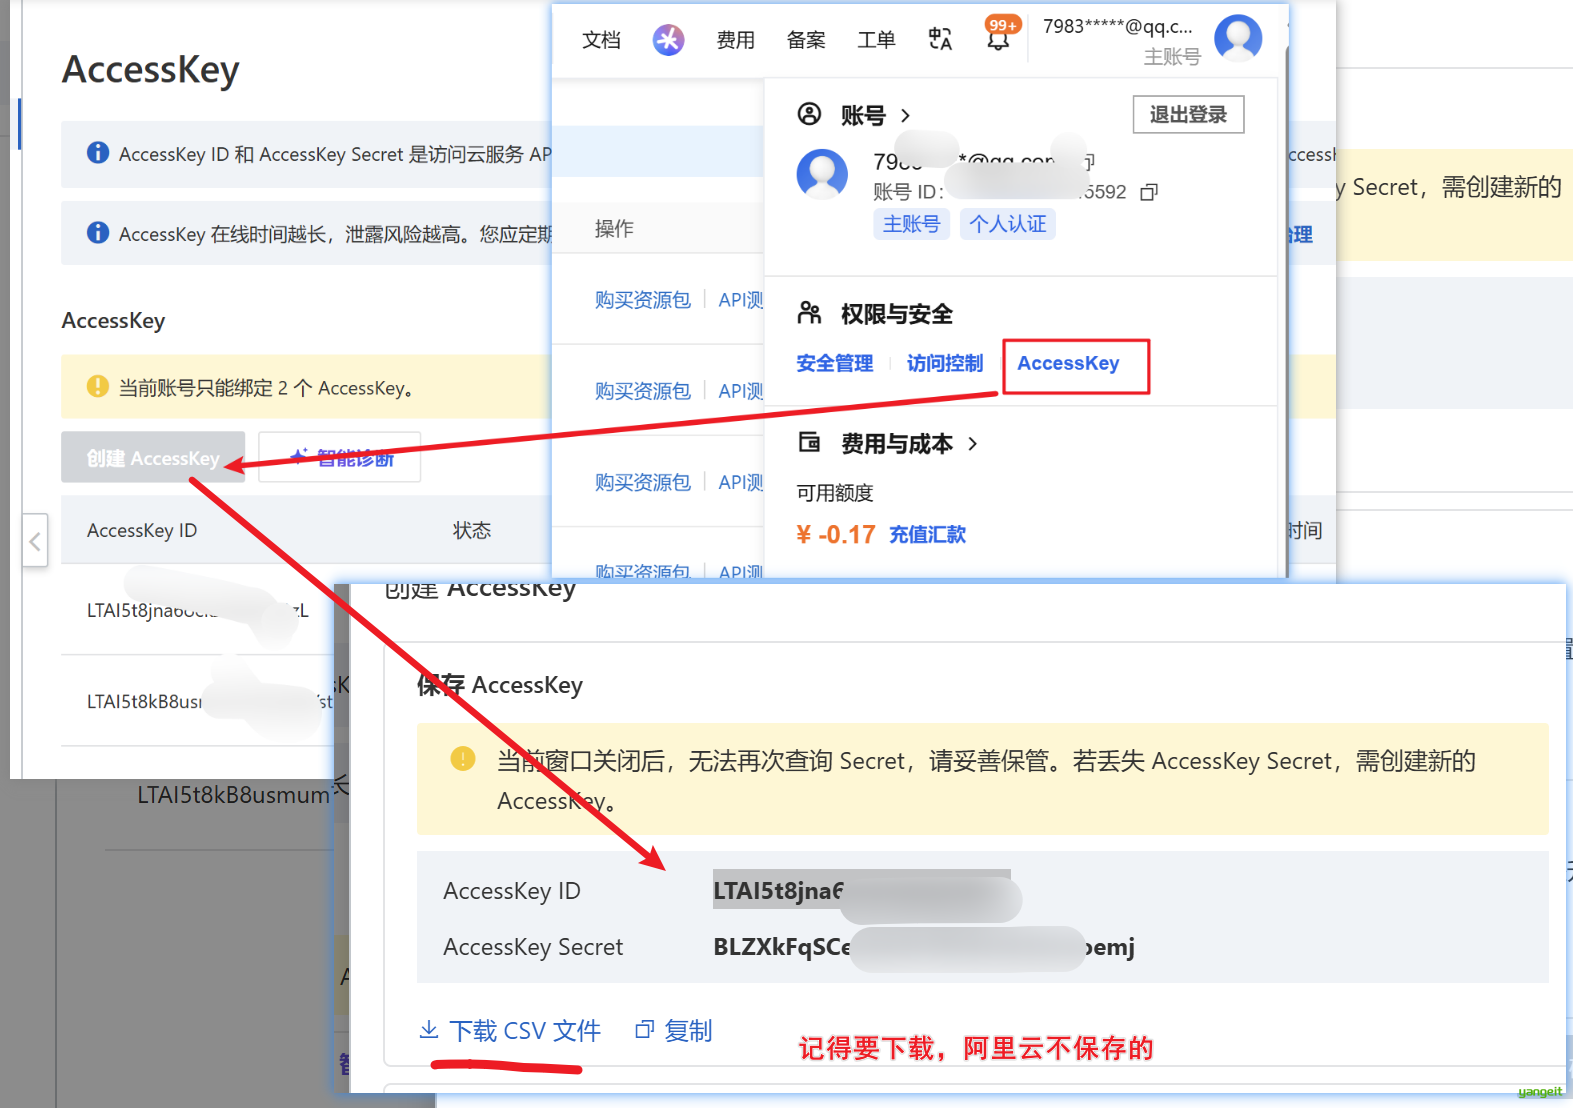
阿里云的自然语言处理链接:https://alinlp.console.aliyun.com/overview
开通基础文本--->智能文本分类--->新闻分类--->Api测试--->感受下-->右上角的用户中获取AccessKey和AccessKeySecret--->复制到环境变量--->安装SDK--->写代码
1.接口说明
| 前缀 | 全称 | 请求类 | 干什么 |
|---|---|---|---|
| TC | Text Classification | GetTcChGeneralRequest | 本节要用的:新闻分类 |
| WS | Word Segmentation | GetWsCustomizedChGeneralRequest | 分词 |
| SA | Sentiment Analysis | GetSaChGeneralRequest | 情感倾向 |
| POS | Part of Speech | GetPosChEcomRequest | 词性标注 |
| NER | Named Entity Recognition | GetNerChEcomRequest | 实体识别 |
2.内置的 19 个类目
| 分组 | 类目 |
|---|---|
| 时政法治 | 时政、法治、反腐前沿、港澳台、国内、国际、军事 |
| 财经民生 | 财经、房产、汽车、教育、健康、美食、旅游、社会 |
| 文体 | 体育、文娱、动漫 |
| 科技 | 数码科技 |
4.和自建模型的差别
| 维度 | 知识点3 朴素贝叶斯 | 本节 阿里云 API |
|---|---|---|
| 代码量 | 约 60 行 | 约 14 行 |
| 标注数据 | 20000 条 | 一条不要 |
| 类目 | 想定几个定几个 | 固定 19 个 |
| 置信度 | predict_proba 给 0.90 | 没有 |
| 训练耗时 | 几分钟 | 0 |
| 数据边界 | 不出本机 | 文本发到云上 |
| 断网 | 照跑 | 直接失败 |
一句话:API 把"训练"换成了"调用",代价是失去控制权。
2.实操步骤
- 开通"自然语言处理·基础版"的智能文本分类(新闻),安装 SDK:
pip install aliyun-python-sdk-alinlp==1.0.20。 - 配置凭证环境变量
NLP_AK_ENV/NLP_SK_ENV,代码里用os.getenv读。 - 准备 10 条杜撰新闻:9 条能对上内置类目,1 条(环保)故意对不上。
- 逐条调用
GetTcChGeneral,对返回的Data做二次解析,取出labelName。 - 汇总:成功条数、类目分布、与预期不符的条目。
演示代码
# 运行环境:Python 3.8+
# 安装依赖:pip install aliyun-python-sdk-alinlp==1.0.20
import os
import json
from aliyunsdkcore.client import AcsClient
from aliyunsdkalinlp.request.v20200629 import GetTcChGeneralRequest

# ── 代码8-13:10 条杜撰新闻(9 条能对上类目,1 条故意对不上)──
NEWS = [
    ("娱乐", "由张晓峰执导的古装剧《山河月明》昨日在横店杀青,主演李一桐、王凯现身发布会,剧组首次公开三分半钟预告片。"),
    ("军事", "海军某驱逐舰支队近日在东海某海域组织实弹射击演练,多型舰艇与舰载直升机协同,检验复杂电磁环境下的编队防空能力。"),
    ("政务", "国务院常务会议部署进一步优化营商环境,要求年底前清理规范涉企收费,压减审批环节,降低制度性交易成本。"),
    ("科技", "某厂商发布新一代折叠屏手机,搭载自研 4nm 芯片与 2K 内屏,铰链寿命提升至 50 万次,售价 8999 元起。"),
    ("环保", "生态环境部通报,长江流域水质优良断面比例达到 97%,干流连续四年保持Ⅱ类水质,沿岸化工企业搬迁改造完成率超九成。"),
    ("体育", "中超第 28 轮,主队在补时阶段连入两球,2:1 逆转客队,提前两轮锁定联赛前四,获得下赛季亚冠资格。"),
    ("财经", "央行宣布下调金融机构存款准备金率 0.25 个百分点,释放长期资金约 5000 亿元,市场普遍预期 LPR 将同步下行。"),
    ("教育", "教育部印发通知,明确义务教育阶段作业总量控制要求,小学三至六年级书面作业平均完成时间不超过 60 分钟。"),
    ("健康", "国家卫健委提示,秋冬季节流感进入高发期,老年人、儿童等重点人群应尽早接种疫苗,出现持续高热应及时就医。"),
    ("旅游", "暑期国内游订单同比增长 35%,西北线路最热,新疆、青海机票预订量翻倍,亲子游与研学游占比超过六成。"),
]

# ── 代码8-14:建客户端(凭证从环境变量读,不写死在代码里)──
client = AcsClient('<your-access-key-id>', '<your-access-key-secret>', 'cn-hangzhou')

# ── 代码8-15:逐条调用,Data 要解两次 ─────────────────
for tag, text in NEWS:
    req = GetTcChGeneralRequest.GetTcChGeneralRequest()   # 导入的是模块,调模块里的同名类
    req.set_Text(text)                                     # 正文,上限 5000 字
    req.set_ServiceCode('alinlp')                          # 固定值
    body = json.loads(client.do_action_with_exception(req))
    label = json.loads(body['Data'])['result']['labelName']   # 第一次解出字符串,第二次解出字典
    print(f'{tag:<4} → {label}')
【运行结果】
娱乐   → 文娱
军事   → 健康
政务   → 法治
科技   → 财经
环保   → 法治
体育   → 体育
财经   → 财经
教育   → 教育
健康   → 法治
旅游   → 美食
本章小结
| 知识点 | 解决什么问题 | 核心产出 | 关键指标 |
|---|---|---|---|
| 知识点1 朴素贝叶斯 | 有标签,怎么把文本分到已知类别 | 词表 + 先验 + 条件概率 | 预测类别 + 置信度(可手算验证) |
| 知识点2 KMeans | 无标签,怎么按相似度抱团 | k 个中心点 + 每条文本的簇编号 | 簇内是否自洽(需人工看) |
| 知识点3 垃圾短信 | 真实规模的不均衡二分类 | 20000 条平衡样本 + 分类器 | 精确率 0.89 / 召回率 0.99 / 准确率 0.93 |
| 知识点4 新闻聚类 | 真实规模的多话题聚类 | 4 个簇 + 交叉表 | 纯度 0.6706(训练)/ 0.6825(测试) |
| 知识点5 阿里云新闻分类 | 不训模型,直接调商用接口分类 | 10 条新闻 + 19 个固定类目 | 类目命中情况(无置信度) |