part07-自然语言处理-文本向量化
part07-自然语言处理-文本向量化
NLP知识目标
- 理解文本向量化的作用:把中文文本转换为计算机可计算的数值向量。
- 理解独热编码、词袋模型(BOW)、TF-IDF 三类离散表示的原理与局限。
- 理解 Word2Vec 中 CBOW 与 Skip-Gram 两种网络结构的区别。
- 理解 Doc2Vec 中 DM 与 DBOW 两种结构的区别。
- 理解稀疏向量(离散表示)与稠密向量(分布式表示)的差异。
- 能够比较七种向量化方法在维度、稀疏性、语义表达能力和语料需求上的差异。
- 掌握 jieba 分词配合 sklearn、gensim 完成文本向量化的代码工程流程。
1. 文本向量化
文本向量化
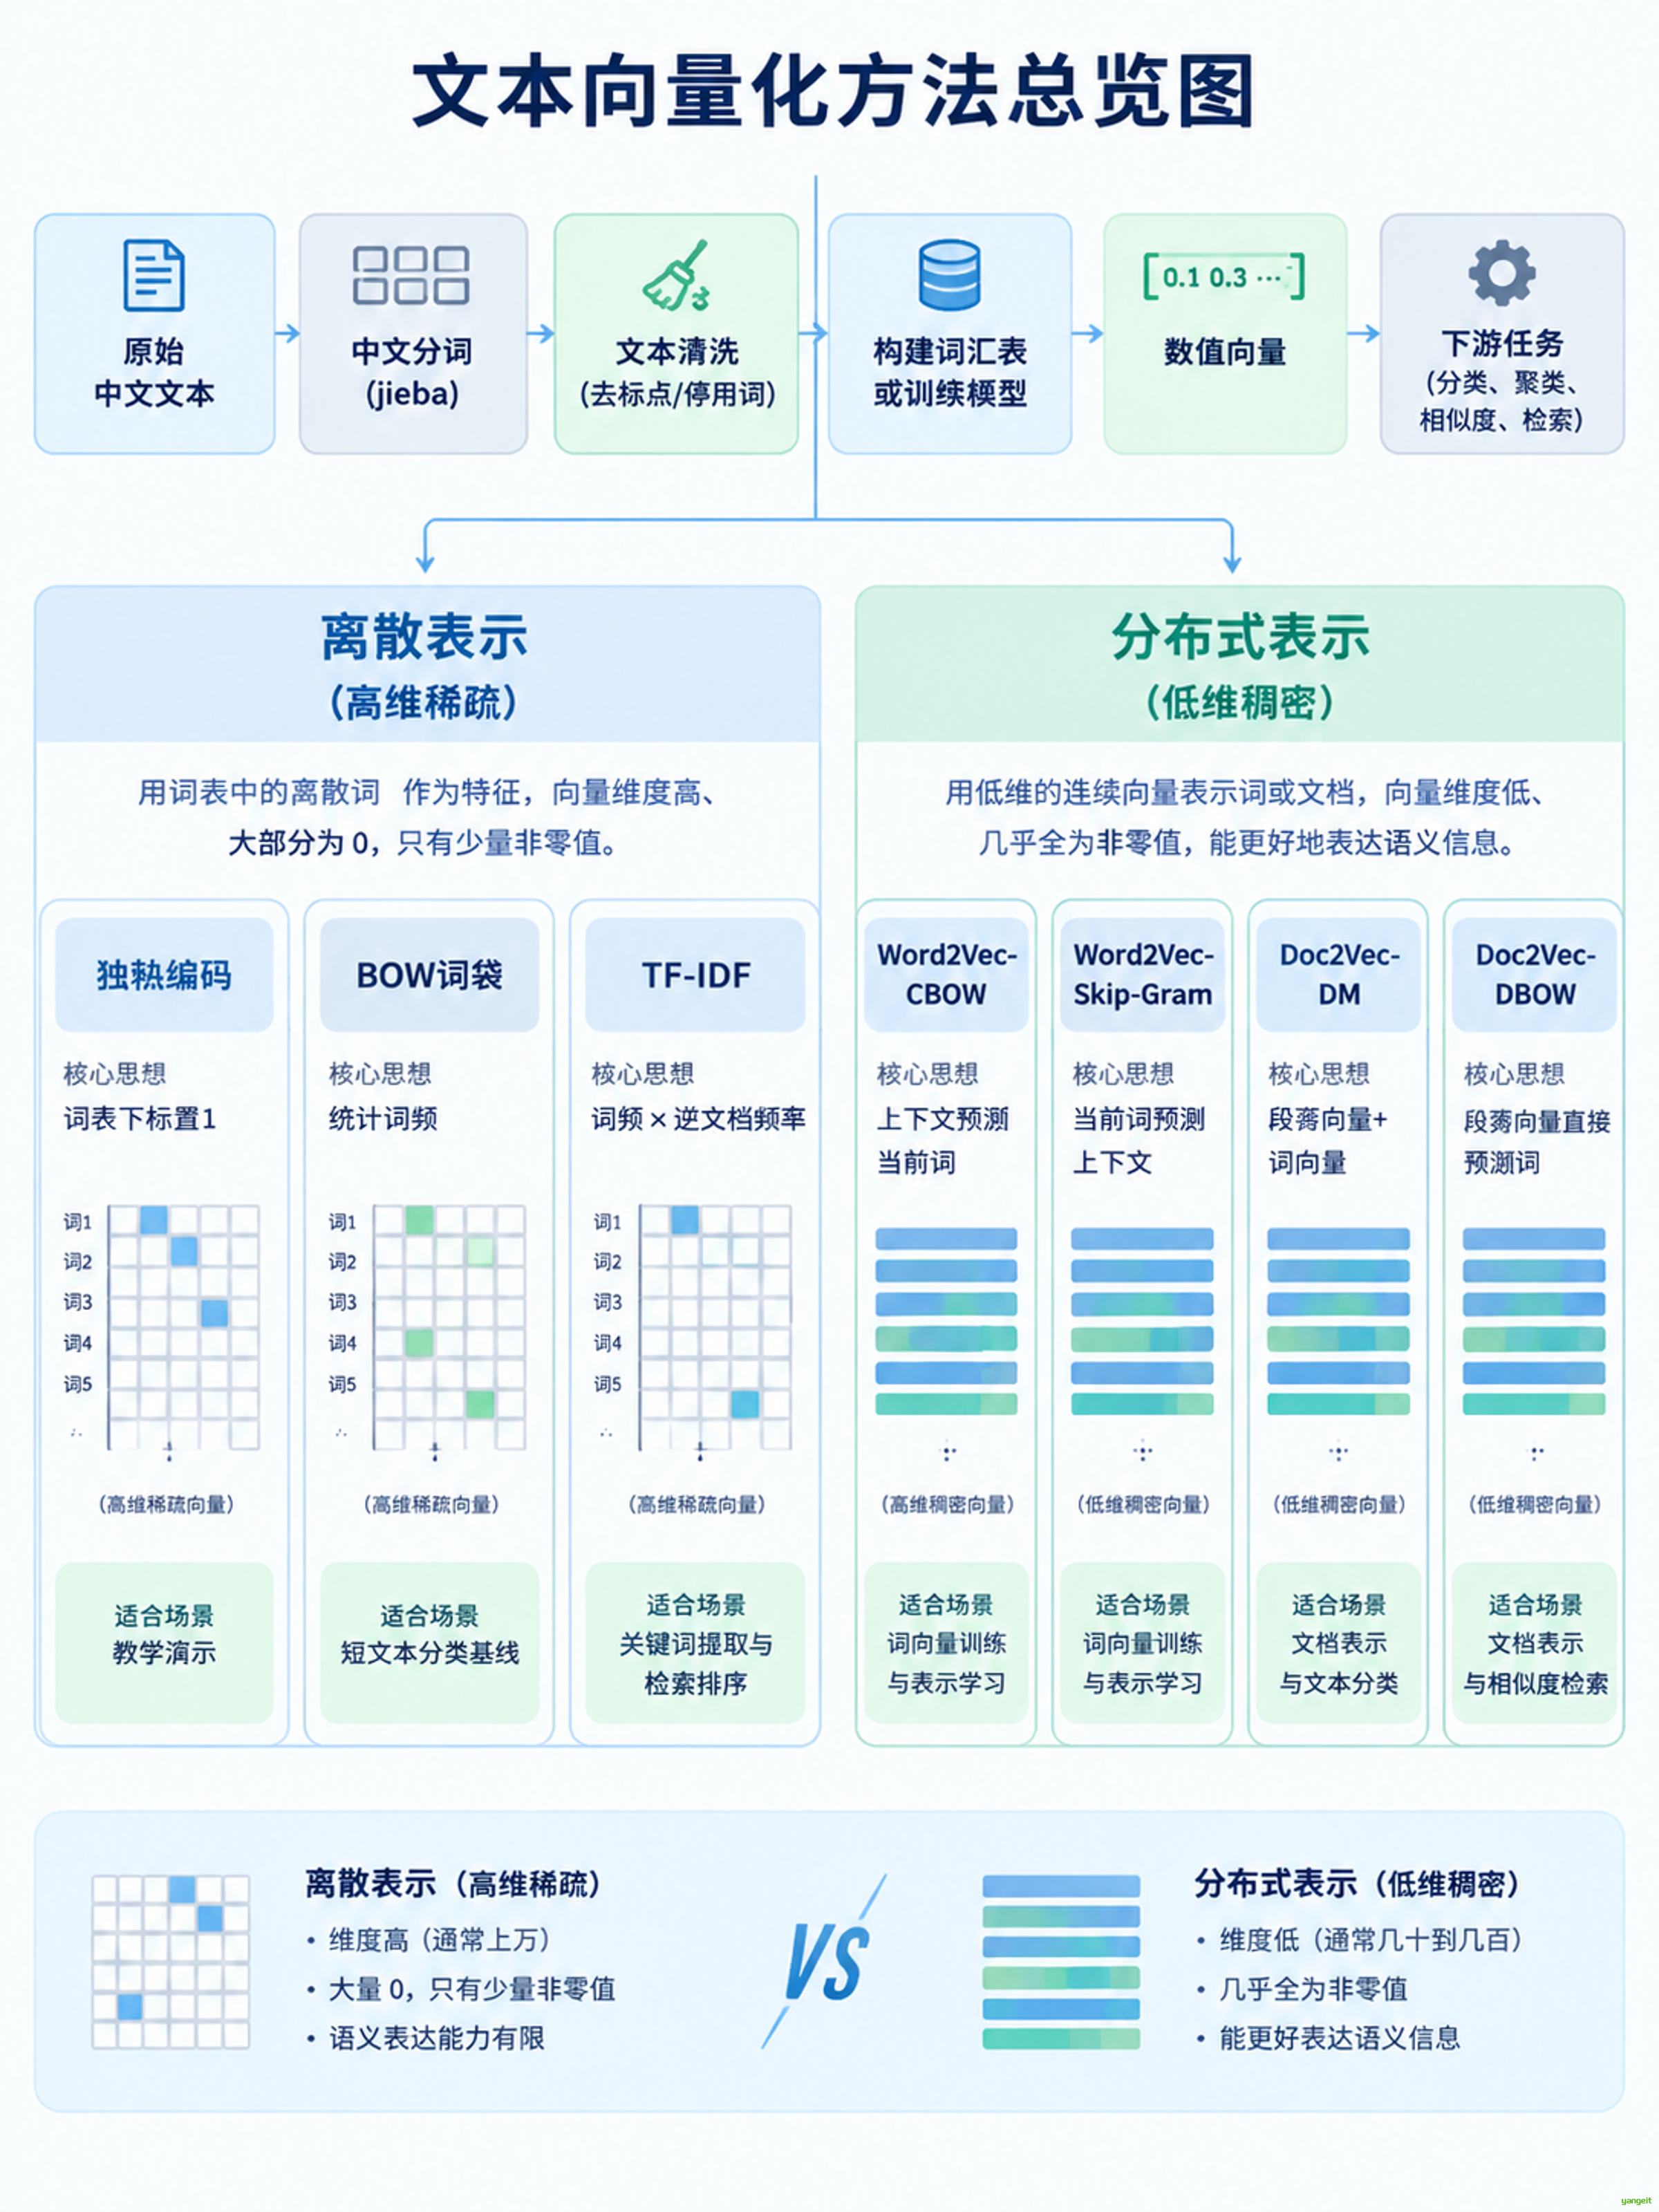
文本向量化(Text Vectorization)是把文本转换为数值向量的过程。计算机不能直接"理解"汉字,只能做数值运算,因此几乎所有 NLP 任务的第一步都是把文本变成向量。向量化之后,文本才能参与分类、聚类、相似度计算、检索排序等运算。
典型业务应用场景: 👇
- 新闻与商品评论的自动分类
- 情感倾向判断
- 智能客服的问答匹配
- 以文搜文与推荐召回
- 文本聚类与热点发现
- 作为神经网络模型的输入特征。
文本向量化的完整处理流程: 👇
原始中文文本
→ 中文分词(jieba.lcut / jieba.cut)
→ 文本清洗(去除标点、换行、停用词)
→ 构建词汇表 或 训练向量模型
→ 生成向量(离散表示 或 分布式表示)
→ 送入下游任务(分类、聚类、相似度、检索)
本章节讲解七种向量化方法对比: 👇
| 方法 | 核心思想 | 向量里每个数字的含义 | 适合场景 |
|---|---|---|---|
| 独热编码 One-Hot | 给词表每个词分配一个下标,出现置 1 | 该词是否出现(0 或 1) | 教学演示、类别型特征编码 |
| 词袋模型 BOW | 统计每个词在文本中出现几次 | 词频(非负整数) | 短文本分类基线、特征工程 |
| TF-IDF | 词频乘以逆文档频率 | 词对当前文本的区分度权重 | 关键词提取、文本分类、检索排序 |
| Word2Vec-CBOW | 用上下文词预测当前词 | 稠密词向量的某一维(无直观含义) | 需要词级语义相似度、作为模型输入 |
| Word2Vec-Skip-Gram | 用当前词预测上下文词 | 稠密词向量的某一维(无直观含义) | 大语料训练、低频词表示 |
| Doc2Vec-DM | 段落向量与词向量共同预测目标词 | 稠密段落向量的某一维 | 句级/段级相似度与聚类 |
| Doc2Vec-DBOW | 只用段落向量预测随机采样的词 | 稠密段落向量的某一维 | 长文档表示、训练速度要求高 |
从表示形态看,这七种方法可以分成两大阵营: 👇
| 阵营 | 包含方法 | 向量特点 | 能否表达语义相近 |
|---|---|---|---|
| 离散表示 | 独热、BOW、TF-IDF | 维度等于词表大小,高维稀疏,绝大多数位置是 0 | 不能,词与词在向量空间中相互正交 |
| 分布式表示 | Word2Vec、Doc2Vec | 维度人工指定(如 50、100),低维稠密,几乎没有 0 | 能,语义相近的词向量夹角小 |
2 环境与依赖准备
前言
推荐 Python 3.8 及以上版本(本讲义实测使用 Python 3.13.14),编辑器推荐 PyCharm、Visual Studio Code 或 Jupyter Notebook。
pip install jieba scikit-learn gensim numpy -i https://pypi.tuna.tsinghua.edu.cn/simple国内镜像源偶发同步延迟,若某源提示找不到包,换成备用源即可:
pip install jieba scikit-learn gensim numpy -i https://mirrors.aliyun.com/pypi/simple/公共素材
公共素材
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn gensim numpy
# 实测环境:Python 3.13.14 / jieba 0.42.1 / scikit-learn 1.9.1 / gensim 4.4.0 / numpy 2.2.6

import jieba
import numpy as np
from sklearn.feature_extraction.text import CountVectorizer, TfidfVectorizer
from gensim.models import Word2Vec
from gensim.models.doc2vec import Doc2Vec, TaggedDocument

jieba.setLogLevel(20)          # 关掉 jieba 加载词典时的日志输出


# ============================================================
# 素材一:迷你语料(4 句 / 14 个词)—— 给独热、BOW、TF-IDF 用
# ============================================================
mini_sentences = ['我喜欢吃苹果也喜欢吃香蕉',
                  '我喜欢吃橙子',
                  '我喜欢用手机听音乐',
                  '我喜欢用电脑写代码']

# 同一批句子准备两种形态,对应两类 API:
#   mini_tokens —— 列表的列表,独热编码手工实现时用
#   mini_texts  —— 空格分隔的字符串,sklearn 的向量化器只认这种格式
mini_tokens = [jieba.lcut(s) for s in mini_sentences]
mini_texts = [' '.join(t) for t in mini_tokens]


# ============================================================
# 素材二:训练语料(300 句 / 2000 个词 / 3 个话题)—— 给 Word2Vec、Doc2Vec 用
# 模板写成"词元元组",等价于已经分好词的句子;
# 若写成字符串,jieba 会把"想买手机"粘成一个词,槽位结构当场被破坏
# ============================================================
topic_data = {
    '水果': {
        'words': ['苹果', '香蕉', '橙子', '葡萄', '西瓜'],
        'templates': [
            ('{p}', '喜欢', '在', '早上', '吃', '新鲜', '的', '{w}'),
            ('{p}', '昨天', '从', '市场', '买', '回来', '两斤', '{w}'),
            ('{w}', '洗', '干净', '以后', '味道', '更', '甜'),
            ('{p}', '把', '{w}', '放进', '冰箱', '保存'),
        ],
    },
    '数码': {
        'words': ['手机', '电脑', '平板', '耳机', '相机'],
        'templates': [
            ('{p}', '打算', '换', '一个', '新的', '{w}'),
            ('{p}', '每天', '用', '{w}', '看', '视频', '和', '听', '音乐'),
            ('{w}', '没电', '以后', '什么', '都', '做', '不了'),
            ('{p}', '昨天', '把', '{w}', '修好', '了'),
        ],
    },
    '天气': {
        'words': ['晴天', '下雨', '刮风', '下雪', '多云'],
        'templates': [
            ('今天', '的', '天气', '是', '{w}'),
            ('{p}', '不', '喜欢', '{w}', '的', '时候', '出门'),
            ('明天', '大概', '还是', '{w}'),
            ('{w}', '的', '时候', '适合', '在', '家', '休息'),
        ],
    },
}
people = ['我', '他', '她', '我们', '他们']

# 生成语料:3 话题 × 5 词 × 5 主语 × 4 句式 = 300 句
corpus, topics = [], []
for name, t in topic_data.items():
    for w in t['words']:
        for p in people:
            for tpl in t['templates']:
                corpus.append([x.format(p=p, w=w) for x in tpl])
                topics.append(name)           # 记录每句的话题,后面用来验证聚类
corpus_texts = [' '.join(s) for s in corpus]

print('迷你语料:%d 句 / %d 个词' % (len(mini_sentences), len({w for t in mini_tokens for w in t})))
print('训练语料:%d 句 / %d 个词 / %d 个话题' % (len(corpus), sum(len(s) for s in corpus), len(topic_data)))


# ============================================================
# 工具函数:第 8、9 节的余弦检索共用
# ============================================================
def cosine(a, b):
    """余弦相似度 = 点积 ÷ 两个模长的乘积。方向越一致越接近 1,正交为 0。"""
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))


def top_match(new_vec, doc_vecs, topics, texts, k=3):
    """按话题取最大相似度,再返回全局最相似的 k 篇——用来验证新句落进了哪个话题。"""
    print('\n新句与各话题的最大相似度:')
    for name in dict.fromkeys(topics):
        best = max(cosine(new_vec, doc_vecs[i]) for i, t in enumerate(topics) if t == name)
        print(f'  {name}: {best:.4f}')

    rank = sorted(range(len(doc_vecs)), key=lambda i: -cosine(new_vec, doc_vecs[i]))[:k]
    print(f'\n最相似的 {k} 篇训练文档:')
    for i in rank:
        print(f'  [{topics[i]}] {texts[i]}  余弦={cosine(new_vec, doc_vecs[i]):.4f}')
跑通后只输出两行:
迷你语料:4 句 / 14 个词
训练语料:300 句 / 2000 个词 / 3 个话题
3.独热编码实现中文文本向量化
独热编码实现中文文本向量化
1.NLP知识点
- 理解独热编码的编码规则:向量长度等于词表大小,出现过的词置 1,其余置 0。
- 理解独热的三个局限:维度随词表膨胀、极度稀疏、任意两个词的向量正交。
- 理解独热"能反映句子重合了几个词、不能表达词义"这条分界线。
- 理解词汇表顺序必须固定,否则向量无法跨次运行复用。
2.代码实操能力
- 使用 jieba.lcut 完成中文分词并观察分词结果。
- 用集合推导式收集词语、用 sorted 固定词汇表顺序。
- 用
{词: 下标}字典建索引,手写 one_hot 函数完成编码。 - 用纯 Python 实现余弦相似度,对比词级与句级结果。
3.NLP理论知识点
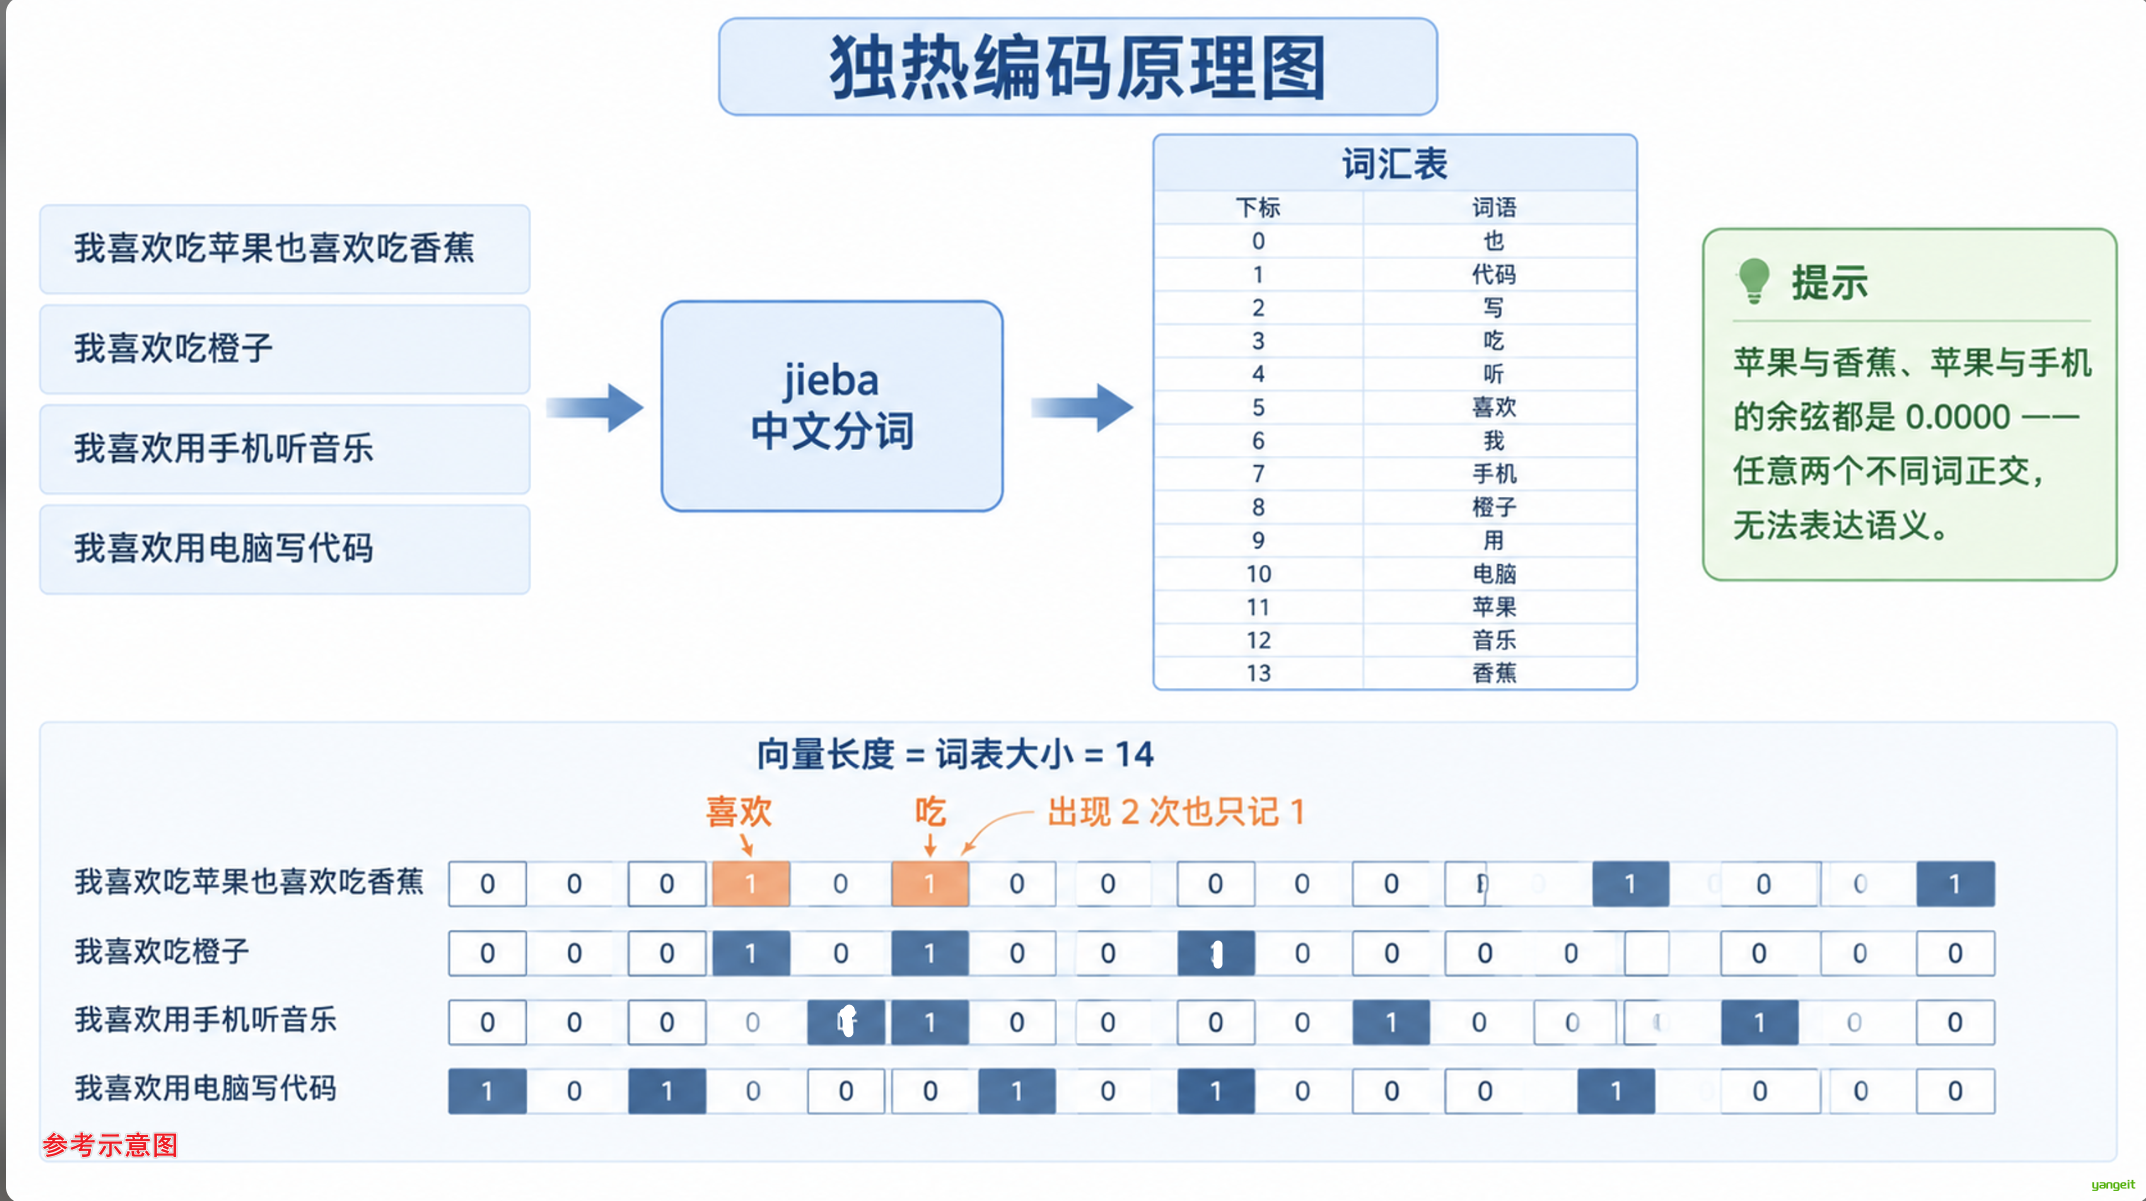
独热编码(One-Hot Encoding)是最直观的向量化方式:先统计语料里出现过的全部词语,得到词表 vocab,为每个词分配唯一下标;表示一句话时,生成一条长度等于 len(vocab) 的全 0 向量,句子里出现过的词,把对应下标的位置改成 1。
本节使用一组 4 句话的迷你语料。语料已经去掉了标点,等价于"清洗之后"的形态:
句子1  我喜欢吃苹果也喜欢吃香蕉   →  我 / 喜欢 / 吃 / 苹果 / 也 / 喜欢 / 吃 / 香蕉
句子2  我喜欢吃橙子               →  我 / 喜欢 / 吃 / 橙子
句子3  我喜欢用手机听音乐         →  我 / 喜欢 / 用 / 手机 / 听 / 音乐
句子4  我喜欢用电脑写代码         →  我 / 喜欢 / 用 / 电脑 / 写 / 代码
4 句话一共用到 14 个不同的词。词表按字典序(Unicode 码位)固定下来:
下标   0    1    2   3    4    5     6   7     8     9   10    11   12    13
词语   也  代码   写  吃   听  喜欢    我  手机  橙子    用  电脑  苹果  音乐  香蕉
句子1 的独热向量:
[1, 0, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 0, 1]
 也 代码 写 吃 听 喜欢 我 手机 橙子 用 电脑 苹果 音乐 香蕉
它有三个绕不开的问题: 👇
第一,维度灾难。词表有多少个词,向量就有多少维。真实中文语料动辄几万甚至几十万词,每个句子的向量就是几十万维,其中绝大多数位置是 0。
第二,无法表达词频。"喜欢"和"吃"在句子1 里各出现 2 次,向量里都只记 1 个 1,重复出现的信息被直接抹掉。这是独热和词袋模型的根本区别。
第三,无法表达语义。任意两个不同词的独热向量做点积恒为 0:"苹果"和"香蕉"的相似度,与"苹果"和"手机"的相似度完全一样,模型看不出前两者都是水果。
还有一条常被忽略的分界线:句子层面的余弦相似度并不是 0。两句话共用的词越多,余弦越高。所以独热回答的是"两句话重合了几个词",回答不了"这两个词意思像不像"。这条分界线,正是后面 TF-IDF 要解决的问题。
4.实操步骤
- 素材已在「公共素材」cell 里备好:4 句话、
jieba.lcut分词结果mini_tokens(列表的列表)。本节从mini_tokens开始,不再重复分词。 - 用集合推导式
{w for words in mini_tokens for w in words}去重得到词表,再套一层sorted把顺序固定下来——字典序稳定,跨次运行、跨机器都一致。 - 用字典推导式建
index_of = {词: 下标}。取下标是 O(1),比vocab.index(word)的线性查找更快,词表大时差距明显。 - 定义 one_hot 函数:先造一条长度等于词表长度的全 0 列表,再遍历句子里的词把对应位置置 1。
- 调用公共 cell 里的
cosine,分别算"词 vs 词"和"句子 vs 句子"的余弦,观察两者的区别。它里面就是"点积 ÷ 两个模长的乘积"。
对应源码片段
# 前置:先运行「2. 环境与依赖准备 → 公共素材」cell
# 本节用到:mini_sentences、mini_tokens、cosine

# 构建词表:集合去重后排序,字典序固定,向量才能跨次运行复用
vocab = sorted({w for words in mini_tokens for w in words})

# 词 → 下标的字典:取下标 O(1),比 vocab.index() 的线性查找快得多
index_of = {w: i for i, w in enumerate(vocab)}


# 独热编码:长度 = 词表大小,出现过的词置 1,出现多次仍然只置 1
def one_hot(words):
    vector = [0] * len(vocab)
    for w in words:
        vector[index_of[w]] = 1
    return vector


vectors = [one_hot(words) for words in mini_tokens]

print('分词结果:')
for s, words in zip(mini_sentences, mini_tokens):
    print('  ', s, '->', words)

print('\n词表(%d 个词):' % len(vocab), vocab)
print('下标:             ', list(range(len(vocab))))

print('\n文本向量:')
for i, (s, v) in enumerate(zip(mini_sentences, vectors)):
    print(f'句子{i + 1}: {s}')
    print('   ', v)

print('\n词与词的余弦相似度:')
for a, b in [('苹果', '香蕉'), ('苹果', '橙子'), ('苹果', '手机'), ('手机', '电脑')]:
    print(f'  {a} vs {b} = {cosine(one_hot([a]), one_hot([b])):.4f}')

print('\n句子与句子的余弦相似度:')
print(f'  句子1 vs 句子2 = {cosine(vectors[0], vectors[1]):.4f}')
print(f'  句子1 vs 句子3 = {cosine(vectors[0], vectors[2]):.4f}')
print(f'  句子2 vs 句子3 = {cosine(vectors[1], vectors[2]):.4f}')
print(f'  句子3 vs 句子4 = {cosine(vectors[2], vectors[3]):.4f}')
【运行结果以及解析】
分词结果:
   我喜欢吃苹果也喜欢吃香蕉 -> ['我', '喜欢', '吃', '苹果', '也', '喜欢', '吃', '香蕉']
   我喜欢吃橙子 -> ['我', '喜欢', '吃', '橙子']
   我喜欢用手机听音乐 -> ['我', '喜欢', '用', '手机', '听', '音乐']
   我喜欢用电脑写代码 -> ['我', '喜欢', '用', '电脑', '写', '代码']

词表(14 个词): ['也', '代码', '写', '吃', '听', '喜欢', '我', '手机', '橙子', '用', '电脑', '苹果', '音乐', '香蕉']
下标:              [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13]

文本向量:
句子1: 我喜欢吃苹果也喜欢吃香蕉
    [1, 0, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 0, 1]
句子2: 我喜欢吃橙子
    [0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0]
句子3: 我喜欢用手机听音乐
    [0, 0, 0, 0, 1, 1, 1, 1, 0, 1, 0, 0, 1, 0]
句子4: 我喜欢用电脑写代码
    [0, 1, 1, 0, 0, 1, 1, 0, 0, 1, 1, 0, 0, 0]

词与词的余弦相似度:
  苹果 vs 香蕉 = 0.0000
  苹果 vs 橙子 = 0.0000
  苹果 vs 手机 = 0.0000
  手机 vs 电脑 = 0.0000

句子与句子的余弦相似度:
  句子1 vs 句子2 = 0.6124
  句子1 vs 句子3 = 0.3333
  句子2 vs 句子3 = 0.4082
解析与理论对照:
| 输出里看到 | 对应哪条理论 |
|---|---|
| 4 句话一共 14 个词 → 每条向量都是 14 维 | 向量长度 = 词表大小。词表涨到 5 万,向量就是 5 万维,这就是维度灾难的来处 |
| 句子1 里"喜欢""吃"各出现 2 次,向量里各只有 1 个 1 | 只记"是否出现",不记出现几次。词频信息在这一步就丢了 |
| 苹果 vs 香蕉 = 0.0000,苹果 vs 手机 = 0.0000,四个组合全是 0 | 任意两个不同词正交。在独热空间里,"水果"和"数码"没有任何区别 |
| 句子1 vs 句子2 = 0.6124,句子1 vs 句子3 = 0.3333 | 句子层面不是 0:余弦只反映"共用了几个词"(1 和 2 共用 3 个词,1 和 3 共用 2 个词) |
| 句子1、2 共用的三个词是"我""喜欢""吃" | 句子相似度被高频虚词主导,而"苹果/橙子"这种真正区分话题的词只占 1 个位置 |
把最后两行连起来看,就是一条完整的推理链:独热能算出句子间的重合度,但重合度几乎全由"我""喜欢"这类到处都出现的词贡献,真正有区分度的词反而被淹没。要修正这一点,就得给词加权
结论:独热编码只回答"这个词出现没有",不回答"出现几次",更不回答"什么意思"。它适合讲清"向量=数值列表"这个起点,以及在类别型特征上做编码;不适合直接用作文本表示。另外,sorted 固定词表顺序是必须养成的习惯,否则同一份代码换次运行,列的含义就变了。
4.BOW词袋模型实现中文文本向量化
BOW词袋模型实现中文文本向量化
1.NLP知识点
- 理解词袋模型的核心假设:把文本看成"装在袋子里的词",丢弃词序和语法。
- 理解 BOW 与独热的关系:独热是"是否出现",BOW 是"出现几次"。
- 理解 BOW 的维度仍然等于词表大小,稀疏性和语义缺陷都没有改善。
- 理解 CountVectorizer 的 token_pattern 参数,以及它默认丢弃中文单字词的行为。
2.NLP理论知识点
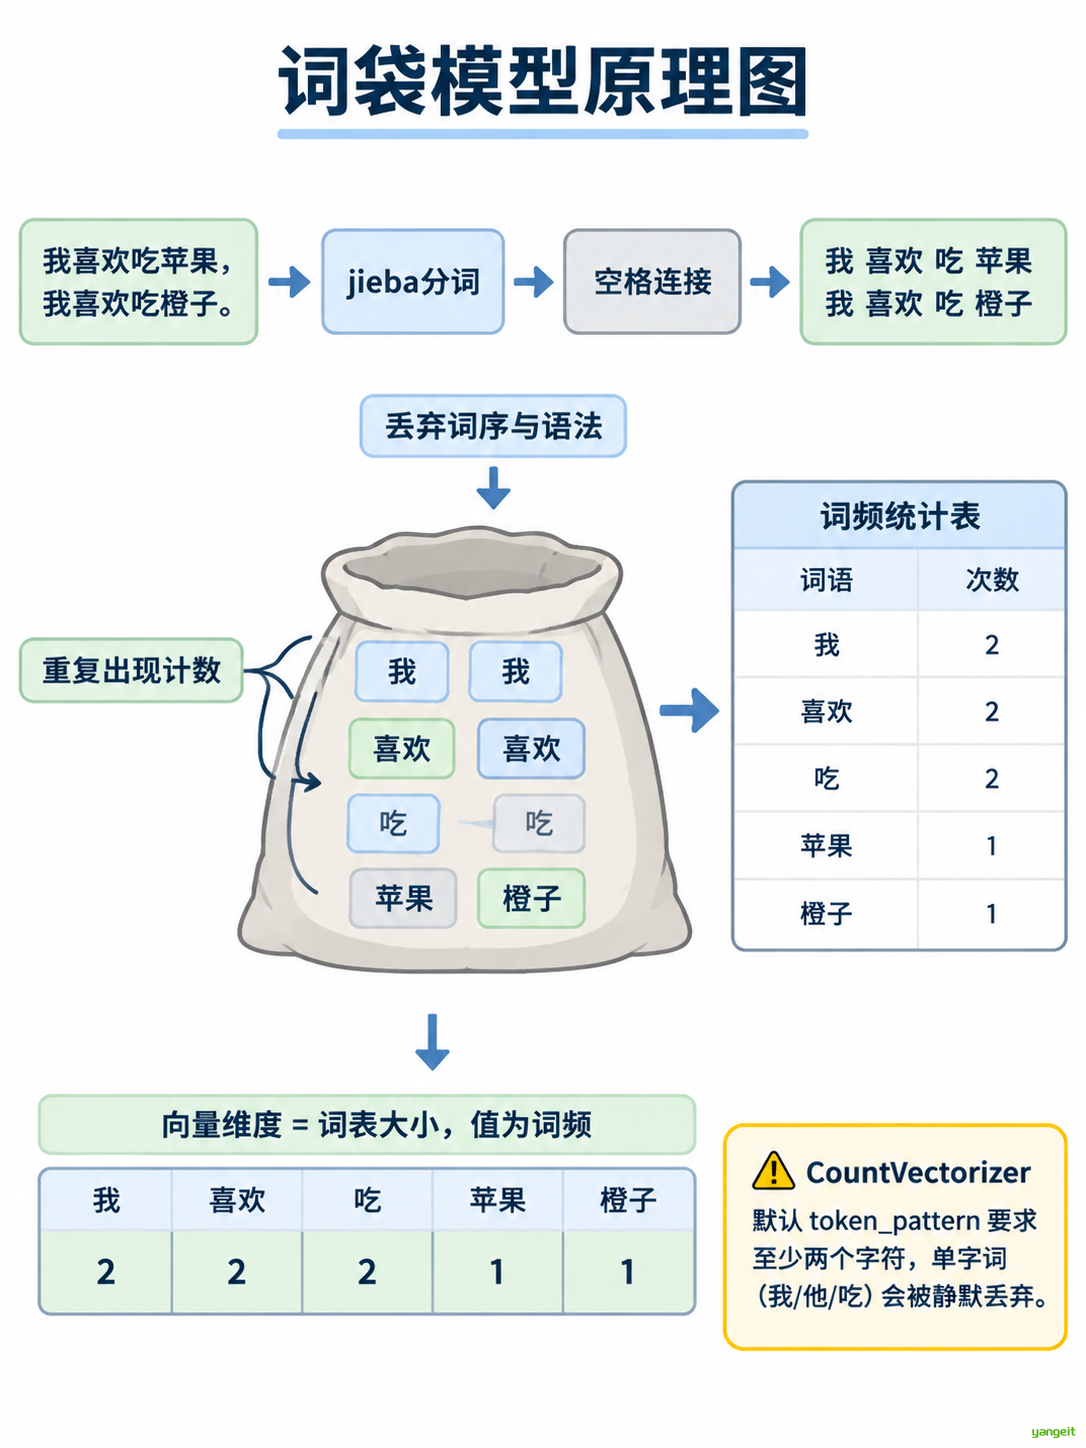
词袋模型(Bag of Words,BOW)在独热的基础上前进了一步:它不再只记录"有没有",而是记录"出现几次"。做法是把文本看成一只袋子,袋子里装着所有出现过的词,词与词之间的先后顺序、语法结构一概不管。
"我喜欢吃苹果,也喜欢吃香蕉"
→ 分词:我 / 喜欢 / 吃 / 苹果 / 也 / 喜欢 / 吃 / 香蕉
→ 词袋:{我:1, 喜欢:2, 吃:2, 苹果:1, 也:1, 香蕉:1}
BOW 的向量维度仍然等于词表大小,仍然稀疏,仍然无法表达语义——"苹果"和"香蕉"在向量空间里还是正交的。它比独热多出的唯一信息就是词频。
正因为维度完全一样,本节和上一节可以逐位对照:同一批 4 句话、同一个 14 词词表、同一个字典序,唯一的变化就是"1"变成了"出现次数"。
4.实操步骤
- 直接取公共 cell 里的
mini_texts——它和上一节的mini_tokens是同一批句子的两种写法,只是换成了"空格分隔的字符串",因此可以和独热编码的结果逐位对照。 - 实例化
CountVectorizer(token_pattern=r'(?u)\b\w+\b'),显式保留单字词。默认参数要求词长 ≥ 2,中文里的"我""吃""用"会被静默丢弃,词表就和上一节对不上了。 - 调用
fit_transform一步完成"建词表 + 统计词频",返回稀疏矩阵;用get_feature_names_out()取列名,X[i].toarray()展开某一行。 - 用
X[0, features.index('喜欢')]定点取值,和独热编码的同一位置做对照。
对应源码片段
# 前置:先运行「2. 环境与依赖准备 → 公共素材」cell
# 本节用到:mini_sentences、mini_texts(空格分隔的形态)

# 创建词袋模型
# token_pattern 显式写成 \w+:默认的 \w\w+ 要求词长 ≥ 2,会把"我""吃""用"等单字词静默丢弃
vectorizer = CountVectorizer(token_pattern=r'(?u)\b\w+\b')

# 文本向量化:fit 学习词表,transform 统计词频,fit_transform 一步做完
X = vectorizer.fit_transform(mini_texts)
# X 是 scipy 稀疏矩阵,只保存非零元素,打印前要用 toarray() 展开

features = vectorizer.get_feature_names_out() # 列名 = 词表

print('分词后用空格连接:')
for s in mini_texts:
    print('  ', s)

print('\n特征词(%d 个):' % len(features))
print(' ', list(features))
print('   下标:', list(range(len(features))))

print('\n词频矩阵:')
for i, s in enumerate(mini_sentences):
    print(f'句子{i + 1}: {s}')
    print('   ', X[i].toarray()[0])

pos = list(features).index('喜欢')
print('\n对照:句子1 中 "喜欢" 的计数 =', X[0, pos], '(独热编码里这一位恒为 1)')
print('矩阵形状 =', X.shape, ' 非零元素个数 =', X.nnz)

print('\n句子与句子的余弦相似度:')
for i in range(3):
    for j in range(i + 1, 4):
        print(f'  {i + 1} vs {j + 1} = {cosine_similarity(X[i:i + 1], X[j:j + 1])[0][0]:.4f}')
【运行结果以及解析】
分词后用空格连接:
   我 喜欢 吃 苹果 也 喜欢 吃 香蕉
   我 喜欢 吃 橙子
   我 喜欢 用 手机 听 音乐
   我 喜欢 用 电脑 写 代码

特征词(14 个):
  ['也', '代码', '写', '吃', '听', '喜欢', '我', '手机', '橙子', '用', '电脑', '苹果', '音乐', '香蕉']
   下标: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13]

词频矩阵:
句子1: 我喜欢吃苹果也喜欢吃香蕉
    [1 0 0 2 0 2 1 0 0 0 0 1 0 1]
句子2: 我喜欢吃橙子
    [0 0 0 1 0 1 1 0 1 0 0 0 0 0]
句子3: 我喜欢用手机听音乐
    [0 0 0 0 1 1 1 1 0 1 0 0 1 0]
句子4: 我喜欢用电脑写代码
    [0 1 1 0 0 1 1 0 0 1 1 0 0 0]
解析与理论对照:
| 输出里看到 | 对应哪条理论 |
|---|---|
| 特征词 14 个,顺序和上一节的词表完全一致 | 两种表示的维度来源相同:都等于词表大小 |
| 句子1 的"喜欢"=2、"吃"=2,其余位置仍是 1 | BOW 唯一比独热多出的信息就是词频:同一句里出现两次,这次记下来了 |
| 把这份矩阵和上一节的独热向量逐位比,只有 2 个位置从 1 变成 2 | 两个表示的差别是局部的:只有"喜欢""吃"这两处在句子1 里重复出现,其余位置完全一致 |
| 矩阵形状 (4, 14),非零元素只有 22 个(4×14=56) | 60% 的格子是 0,稀疏性一点没变 |
| 苹果 vs 香蕉在这里仍然算不出相似度 | 词与词依旧正交,语义缺陷没有改善 |
结论:BOW 用两行 sklearn 代码就能完成,比手写独热规范(词表有序、直接返回稀疏矩阵、内存友好)。它把"出现几次"这个信息补上了,但维度、稀疏性、语义三件事一件都没解决。它适合做短文本分类的基线,不适合做语义表示。
思考题
- 把句子1 改成"我喜欢吃苹果",重新运行,词频矩阵和独热向量还有区别吗?
参考:没有区别了。所有词的计数都是 1,BOW 就退化成独热。BOW 的价值只在"同一个词在一句里重复出现"时才体现。 - 给语料加一句"我喜欢吃苹果也喜欢吃橙子",哪些位置会变?它和句子1 的余弦是多少?
参考:特征词还是 14 个(没有新词),矩阵多出一行;新句子的"喜欢""吃"各记 2。它与句子1 只差一个位置(香蕉 vs 橙子),余弦高达 0.9167——两句话说的水果并不一样,BOW 却认为几乎相同。这就是"只有词频、没有词序和语义"的代价。 - 思考:为什么 BOW 叫"词袋"?在情感分析里,"这部电影不好看"和"这部电影不,好看"会怎样?
参考:把词倒进袋子摇匀,顺序和语法都丢了。两句的词袋完全相同,但"不好"被拆开后否定含义丢失,模型可能判成正面——这就是丢词序的代价。
5.TF-IDF实现中文文本向量化
TF-IDF实现中文文本向量化
1.NLP知识点
- 理解 TF-IDF = TF × IDF 的含义,以及它为什么能压低"我""喜欢"这类到处都出现的词。
- 理解 IDF 与文档频率 DF 的反向关系,以及 DF = N 时 IDF 恰好等于 1 这个边界。
- 理解 sklearn 中 smooth_idf 与 L2 归一化的默认行为。
- 理解 TF-IDF 的每一维不再是可读的整数,而是带小数的相对权重。
2.NLP理论知识点
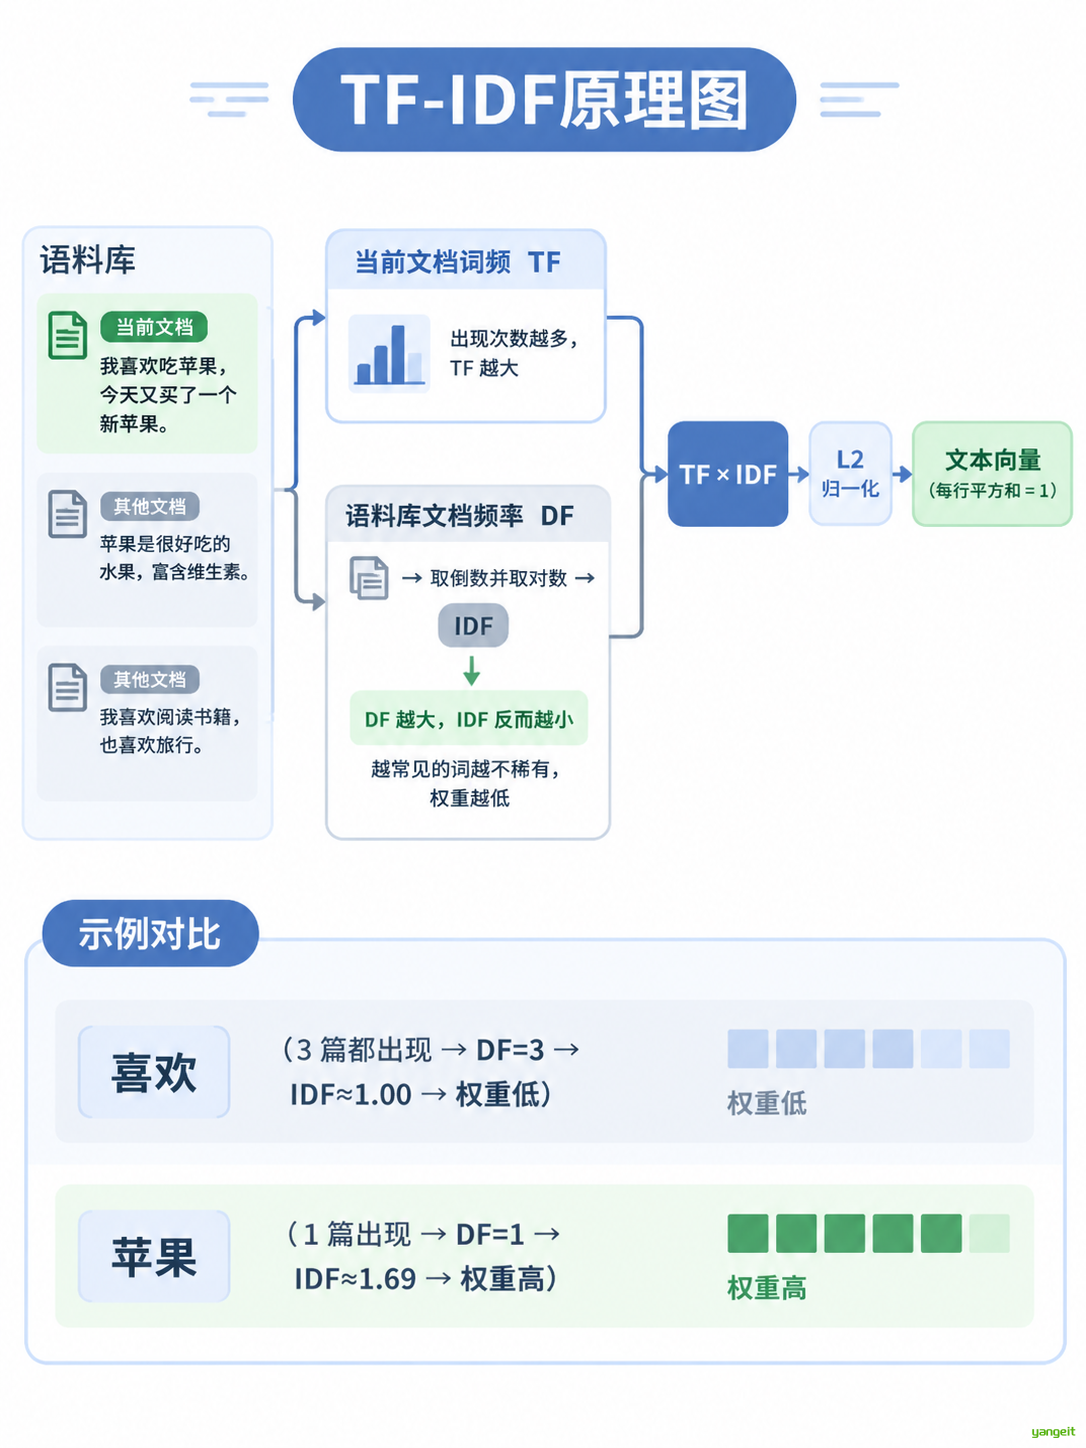
BOW 有个明显问题:像"我""喜欢" 这种几乎每句都出现的词,词频很高,但对区分文档毫无帮助。TF-IDF 就是为解决这个而生的,它由两部分相乘:👇
TF(词频)      = 词语在当前文档中的出现次数
DF(文档频率)  = 语料中包含该词的文档数
IDF(逆文档频率)= log((N + 1) / (DF + 1)) + 1        # sklearn 默认 smooth_idf 形式
TF-IDF          = TF × IDF
IDF 是反向的:一个词在越多的文档里出现(DF 越大),它的 IDF 反而越小。两个边界值要记住:
DF = N(每篇都出现)→ IDF = log((N+1)/(N+1)) + 1 = 1        → 权重不再被放大
DF = 1(只在一篇出现)→ IDF = log((N+1)/2) + 1,N=4 时约 1.9163 → 权重明显抬高
sklearn 的 TfidfVectorizer 默认还会对每一行做 L2 归一化,让每行向量的平方和等于 1。好处是不同长度的文本可以直接用余弦相似度比较;代价是向量里的数字不再能跨文档比大小,它表示的是"该词在这篇文档内部的相对重要程度"。
。
3.实操步骤
- 继续用
mini_texts,与前面的 BOW 结果可以一一对照。 - 实例化
TfidfVectorizer(token_pattern=r'(?u)\b\w+\b')后调用fit_transform,一步得到 TF-IDF 矩阵。 - 打印特征词和每篇文档的向量;再用
vectorizer.idf_把每个词的 IDF 与它出现的文档数排在一起,验证"DF 越大 IDF 越小"。 - 用
CountVectorizer取同一批文本的原始词频,做"TF / DF / IDF / 权重"的分解,看清权重是怎么算出来的。 - 用
np.linalg.norm(..., axis=1)打印每行 L2 范数,确认归一化生效。
对应源码片段
# 前置:先运行「2. 环境与依赖准备 → 公共素材」cell
# 本节用到:mini_sentences、mini_texts、np

# 创建 TF-IDF 模型:内部先算词频,再乘 IDF,最后按行做 L2 归一化
vectorizer = TfidfVectorizer(token_pattern=r'(?u)\b\w+\b')

# 文本向量化
X = vectorizer.fit_transform(mini_texts)
features = list(vectorizer.get_feature_names_out())

print('特征词(%d 个):' % len(features))
print(' ', features)
print('   下标:', list(range(len(features))))

print('\nTF-IDF 向量(保留 4 位小数):')
for i, s in enumerate(mini_sentences):
    print(f'句子{i + 1}: {s}')
    print('   ', np.round(X[i].toarray()[0], 4))

# 验证一:IDF 与文档频率的对应关系,按 IDF 从小到大排
print('\n各词的 IDF:')
for w, v in sorted(zip(features, vectorizer.idf_), key=lambda x: x[1]):
    df = int((X.toarray()[:, features.index(w)] > 0).sum())
    print(f'  {w:4s} IDF = {v:.4f}   出现于 {df} / {len(mini_sentences)} 篇')

# 验证二:把句子1 里三个词的 TF / DF / IDF / 权重拆开看
print('\n句子1 中三个词的权重分解:')
cnt = CountVectorizer(token_pattern=r'(?u)\b\w+\b')
C = cnt.fit_transform(mini_texts).toarray()
cfeat = list(cnt.get_feature_names_out())
row = X[0].toarray()[0]
for w in ['喜欢', '吃', '苹果']:
    print(f'  {w}: TF={C[0, cfeat.index(w)]}  DF={int((C[:, cfeat.index(w)] > 0).sum())}'
          f'  IDF={vectorizer.idf_[features.index(w)]:.4f}  权重={row[features.index(w)]:.4f}')

# 验证三:每行 L2 范数应为 1,证明归一化生效
print('\n每行 L2 范数 =', np.round(np.linalg.norm(X.toarray(), axis=1), 4))
【运行结果以及解析】
特征词(14 个):
  ['也', '代码', '写', '吃', '听', '喜欢', '我', '手机', '橙子', '用', '电脑', '苹果', '音乐', '香蕉']
   下标: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13]

TF-IDF 向量(保留 4 位小数):
句子1: 我喜欢吃苹果也喜欢吃香蕉
    [0.3821 0.     0.     0.6026 0.     0.3988 0.1994 0.     0.     0.
 0.     0.3821 0.     0.3821]
句子2: 我喜欢吃橙子
    [0.     0.     0.     0.5357 0.     0.3546 0.3546 0.     0.6794 0.
 0.     0.     0.     0.    ]
句子3: 我喜欢用手机听音乐
    [0.     0.     0.     0.     0.4899 0.2557 0.2557 0.4899 0.     0.3863
 0.     0.     0.4899 0.    ]
句子4: 我喜欢用电脑写代码
    [0.     0.4899 0.4899 0.     0.     0.2557 0.2557 0.     0.     0.3863
 0.4899 0.     0.     0.    ]

各词的 IDF:
  喜欢   IDF = 1.0000   出现于 4 / 4 篇
  我    IDF = 1.0000   出现于 4 / 4 篇
  吃    IDF = 1.5108   出现于 2 / 4 篇
  用    IDF = 1.5108   出现于 2 / 4 篇
  也    IDF = 1.9163   出现于 1 / 4 篇
  代码   IDF = 1.9163   出现于 1 / 4 篇
  写    IDF = 1.9163   出现于 1 / 4 篇
  听    IDF = 1.9163   出现于 1 / 4 篇
  手机   IDF = 1.9163   出现于 1 / 4 篇
  橙子   IDF = 1.9163   出现于 1 / 4 篇
  电脑   IDF = 1.9163   出现于 1 / 4 篇
  苹果   IDF = 1.9163   出现于 1 / 4 篇
  音乐   IDF = 1.9163   出现于 1 / 4 篇
  香蕉   IDF = 1.9163   出现于 1 / 4 篇

句子1 中三个词的权重分解:
  喜欢: TF=2  DF=4  IDF=1.0000  权重=0.3988
  吃: TF=2  DF=2  IDF=1.5108  权重=0.6026
  苹果: TF=1  DF=1  IDF=1.9163  权重=0.3821

每行 L2 范数 = [1. 1. 1. 1.]
解析与理论对照:
| 输出里看到 | 对应理论 |
|---|---|
| "喜欢""我"出现于 4/4 篇 → IDF 恰好 1.0000 | DF = N 时 IDF = 1,公式的下界。到处都出现的词,权重不再被放大 |
| "吃""用"出现于 2/4 篇 → IDF = 1.5108 | DF 从 4 降到 2,IDF 从 1.0 升到 1.51,方向确实相反 |
| "苹果"只出现在 1 篇 → IDF = 1.9163 | DF = 1 时的上界,log((4+1)/2)+1 = 1.9163,与公式逐位吻合 |
| 句子1 里"喜欢"和"吃"的 TF 都是 2,权重却是 0.3988 与 0.6026 | TF 相同、IDF 不同 → 权重不同。这正是 TF-IDF 相对 BOW 的核心价值 |
| "苹果"TF 只有 1,权重 0.3821,仍高于"我"的 0.1994 | 少而专的词被抬起来,多而泛的词被压下去 |
| 每行 L2 范数 = 1.0 | 默认 norm='l2' 生效,权重只能在篇内横向比较,不能跨篇直接比大小 |
结论:TF-IDF 在 BOW 的基础上增加了"区分度"这一维,用 IDF 压低到处都出现的词,是关键词提取、文本分类和检索排序的经典基线。但要记住两点:IDF 与 DF 反向;默认做了 L2 归一化,权重不能跨文档直接比大小。它优化的只是权重分配,维度、稀疏和语义三件事依旧没变
思考题
把语料扩成 5 句,其中两句含"苹果",重新计算"苹果"的 IDF。
参考:N=5、DF=2,IDF = log((5+1)/(2+1)) + 1 = log(2) + 1 ≈ 1.6931,比 DF=1 时的 1.9163 更低。出现范围变广,权重随之下降。思考:TF-IDF 能表达"苹果"和"香蕉"都是水果吗?如果不能,需要什么方法?
参考:不能。TF-IDF 只是给每个词一个权重,词与词在向量空间中仍然正交。要表达语义相近,必须换分布式表示(Word2Vec、Doc2Vec 或预训练模型),让共现模式相近的词学到相近的向量。
6.实词->向量化(Word2Vec)
CBOW模型实现词向量化
1.NLP知识点
- 理解分布式表示的思想:用低维稠密向量表示词,语义相近的词向量夹角小。
- 理解 CBOW 的训练任务:用上下文词预测当前词。
- 理解 window、vector_size、min_count、sg、epochs 五个核心参数的含义。
- 理解"语料要够规模、上下文要够区分"这两个前提,以及模板语料是怎么构造出来的。
2.代码实操能力
- 用"模板 + 槽位"批量生成带主题标注的训练语料。
- 用 gensim 的 Word2Vec 训练 CBOW 模型(sg=0)。
- 用
model.wv取词向量,index_to_key看词表。 - 用
most_similar做词级相似度查询,用similarity查指定词对的数值。
3.NLP理论知识点
前面三种方法都属于离散表示,共同缺陷是词与词正交,无法表达语义 。分布式表示换了个思路:不要求每一维有明确含义,而是让"语义相近的词,向量也相近"。👈
Word2Vec 是分布式表示的代表作,它有两种结构: 👇
1️⃣ CBOW(Continuous Bag of Words):拿当前词前后各 window 个上下文词,用它们的向量去预测当前词,可以理解为"看周围猜中间"。它对高频词效果好、训练快。
2️⃣ Skip-Gram:反过来,拿当前词去预测它的上下文,即"看中间猜周围"。它对低频词更友好,计算量也更大。
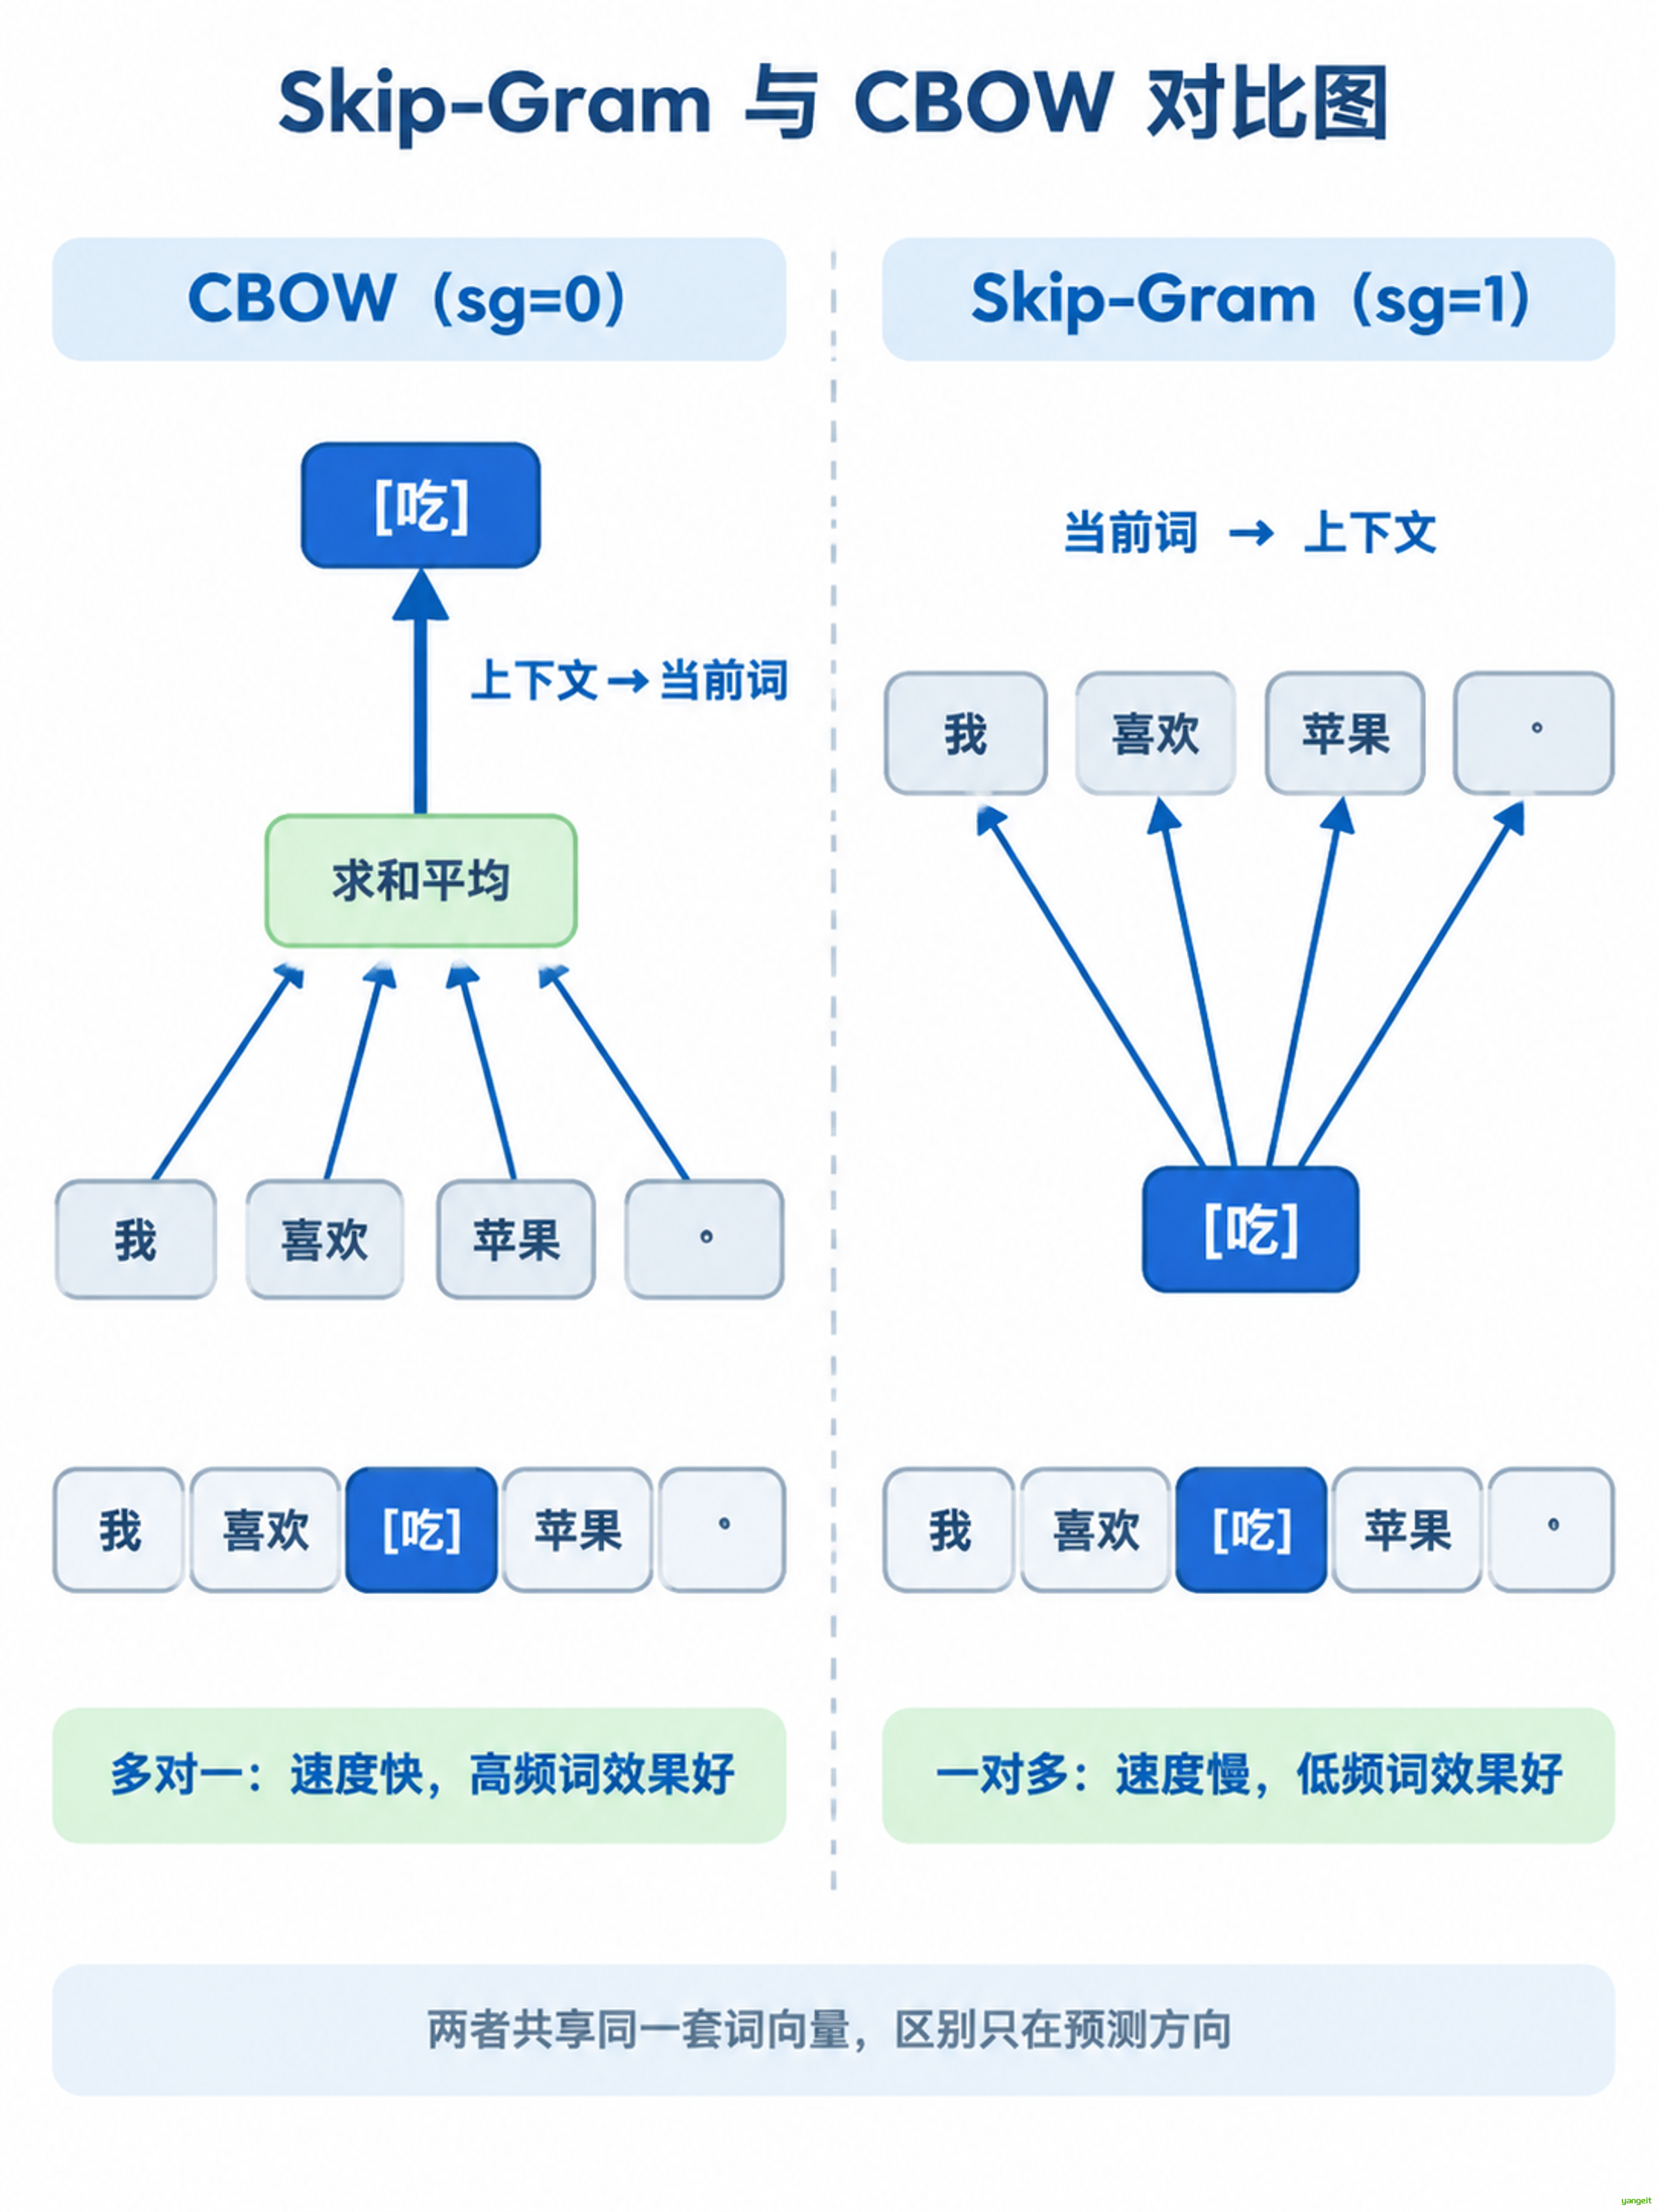
gensim 里用 sg 参数切换:sg=0 是 CBOW,sg=1 是 Skip-Gram。核心参数:
| 参数 | 含义 | 本例取值 |
|---|---|---|
| sentences | 训练语料,二维列表,每个内层列表是一个句子的分词结果 | corpus |
| window | 上下文窗口半径,决定一个词能看到左右各几个词 | 2 |
| min_count | 词频阈值,低于它的词被丢弃 | 1 |
| sg | 训练算法,0 = CBOW,1 = Skip-Gram | 0 |
| vector_size | 词向量维度,人工指定 | 50 |
| workers | 并行训练线程数;设为 1 配合 seed 才能严格复现 | 1 |
| seed | 随机种子 | 42 |
| epochs | 迭代轮数 | 100 |
对应源码片段
# 前置:先运行「2. 环境与依赖准备 → 公共素材」cell
# 本节用到:corpus(300 句 / 2000 词 / 3 个话题)

print('句子数 =', len(corpus), ' 总词数 =', sum(len(s) for s in corpus))

# 训练 CBOW:sg=0。workers=1 + seed 固定,保证结果可复现
model = Word2Vec(sentences=corpus, vector_size=50, window=2, min_count=1,
                 sg=0, workers=1, seed=42, epochs=100) #sentences:语料;vector_size:词向量维度;window:上下文窗口半径;min_count:词频阈值;sg:训练算法;workers:并行训练线程数;seed:随机种子;epochs:迭代轮数

wv = model.wv
print('词表大小 =', len(wv.index_to_key))

# 打印词向量:50 维全部打印会占满屏幕,这里只看前12 维
print('\n词向量(只打印前 12维):')
for w in ['苹果', '手机', '晴天']:
    print(f'  {w}: {np.round(wv[w][:12], 4)}  维度 = {wv[w].shape}')

# 跨话题的相似度:应该明显低于同话题内部
# `similarity(w1, w2)`:输入一对词 → 输出【这两个词之间的相似度数值】(余弦值,-1~1)
print('\n跨主题的相似度:')
print('  苹果-手机 = %.4f' % wv.similarity('苹果', '手机'))
print('  苹果-晴天 = %.4f' % wv.similarity('苹果', '晴天'))
print('  苹果-西瓜 = %.4f' % wv.similarity('苹果', '西瓜'))
print('  晴天-多云 = %.4f' % wv.similarity('晴天', '多云'))

# 最近邻:查四个代表词,看它们各自落在哪个话题里,
#**`most_similar(w, topn=N)`:输入一个查询词 → 在整个词表遍历,返回和它最像的 Top N 邻居(词 + 分数列表)**
print('\n最近邻(topn=4):')
for w in ['苹果', '手机', '晴天', '下雨']:
    print(f'  {w}: ' + ', '.join(f'{n}({s:.3f})' for n, s in wv.most_similar(w, topn=4)))
【运行结果以及解析】
句子数 = 300  总词数 = 2000
词表大小 = 72

词向量(只打印前 8 维):
  苹果: [ 0.2227 -0.0126  0.1921 -0.033   0.5006  0.1803  0.1778  0.0817]  维度 = (50,)
  手机: [ 0.2174 -0.3765 -0.1486 -0.292  -0.1077 -0.3919  0.1519  0.3328]  维度 = (50,)
  晴天: [-0.084  -0.0315  0.0975  0.2732  0.0067  0.4219 -0.1358 -0.0713]  维度 = (50,)

跨主题的相似度:
  苹果-手机 = 0.1071
  苹果-晴天 = 0.2448
  苹果-西瓜 = 0.9975
  晴天-多云 = 0.9965

最近邻(topn=4):
  苹果: 西瓜(0.997), 葡萄(0.997), 橙子(0.996), 香蕉(0.990)
  手机: 电脑(0.998), 相机(0.997), 耳机(0.996), 平板(0.994)
  晴天: 下雪(0.998), 刮风(0.997), 多云(0.996), 下雨(0.995)
  下雨: 多云(0.998), 下雪(0.998), 刮风(0.998), 晴天(0.995)
解析与理论对照:
| 输出里看到 | 对应哪条理论 |
|---|---|
| 300 句、2000 个 token → 词表 72 | 参数规模来自语料;72 个词里只有 15 个是主题词,其余是"的/了/把"这类功能词 |
| 三个词的向量都是 50 维,且几乎没有 0 | 维度由人指定(vector_size=50),与词表大小 72 无关;每一位都有值,这就是"稠密" |
| "苹果"的 top4 是 西瓜/葡萄/橙子/香蕉,相似度 0.99 以上 | 上下文相同 → 向量趋同。这五个词在语料里占同一个槽位,环境一模一样 |
| "手机"的 top4 是 电脑/相机/耳机/平板,一个水果都没混进来 | 跨话题的上下文不重叠,两个簇被自然分开 |
| "晴天""下雨"的 top4 全是天气词 | 三个话题各自成簇,没有任何一句"苹果像手机" |
| 苹果-手机 = 0.1071,苹果-晴天 = 0.2448 | 跨话题相似度只有 0.1~0.2 量级,与同话题的 0.99 差一个数量级 |
| 上一个模块里"苹果 vs 香蕉 = 0.0000" | 对照着看:离散表示永远是 0,分布式表示是 0.99,这就是换思路换来的东西 |
结论:CBOW 的代码只有两行,真正决定效果的是公共 cell 里那段语料生成。分布式表示的意义可以用一句话概括:向量不再记录"出现过什么词",而是记录"这个词平时出现在什么环境里";环境相近,向量就相近。
常见易错坑
- 用几句话说"Word2Vec 学不到东西"。语料规模是硬约束:token 数不到几千,最近邻基本是噪声。先扩语料,再谈调参。
- 直接对含换行、标点的原文分词,
\n、。会混进词表,还常常因为高频排到前面。本例用词元模板生成语料,从源头避免了这个问题。 - 把
vector_size当成词表大小。它是人为指定的向量维度,与词表规模无关。 - 混淆
sg取值:sg=0是 CBOW(上下文→当前词),sg=1是 Skip-Gram(当前词→上下文)。
CBow和Skip-Gram区别: 👇
- 第一,词表完全相同。词表只由语料和
min_count决定,与sg无关。这一点常被误以为会变。 - 第二,向量空间不同,数值不可通用。两个模型各自独立训练,同一个词的坐标不一样,同一对词的相似度也不一样,2个模型不能混用。
- 第三,训练成本与适用场景不同。Skip-Gram 对窗口内每个上下文词各做一次预测,一个中心词要产生多条训练样本,计算量更大;换来的是低频词能获得更充分的训练信号。CBOW 把上下文平均后预测一个词,速度快,高频词效果好。
所以选择依据很直接:语料大、追求速度、以高频词为主 → CBOW;语料偏小、低频词重要、时间宽裕 → Skip-Gram。
思考题
- 把
vector_size从 50 改成 10,其他不变,观察结果。
参考:最近邻的组成完全不变(西瓜、葡萄、橙子、香蕉),但"苹果-手机"从 0.1071 降到 0.0247。低维把跨话题的残余相关压得更干净,同时也再没有空间容纳更细的语义差别。维度要与语料规模匹配,不是越大越好。 - 给"水果"话题加第 6 个词"榴莲",但只给它 1 条句式(全语料出现 5 次),看它还能不能被拉进水果簇。
参考:能。榴莲的最近邻是 葡萄(0.994)、香蕉(0.991)、苹果(0.990),苹果-榴莲 = 0.9903。决定归簇的是"它出现在什么环境",而不是"出现了多少次"——只出现 5 次但环境纯净,照样归位。
7.文本->向量化(Doc2Vec)
DM模型实现文本向量化
1.NLP知识点
- 理解 Doc2Vec 解决的问题:从"词向量"到"段落/句子向量"。
- 理解 DM(Distributed Memory)的结构:段落向量与上下文词向量共同参与预测。
- 理解 TaggedDocument 的作用:给每篇文档一个唯一标签。
- 理解 infer_vector 的原理,以及固定随机种子对复现的意义。
2.代码实操能力
- 用
TaggedDocument把"词元列表 + 唯一标签"打包成训练样本。 - 用
build_vocab+train两步训练 Doc2Vec。 - 用
model.dv读取训练文档的向量矩阵。 - 用
infer_vector推断新句子向量,并按主题分组取最大相似度。
3.NLP理论知识点
Word2Vec 产出的是词向量,但很多任务需要的是整句或整段的向量——比如判断两句话是否表达同一意思、给新句子找最像的历史工单。最粗暴的做法是把句内所有词向量取平均,但这样会丢掉词序,而且"的""了"这类无实义的词会把向量拉偏。
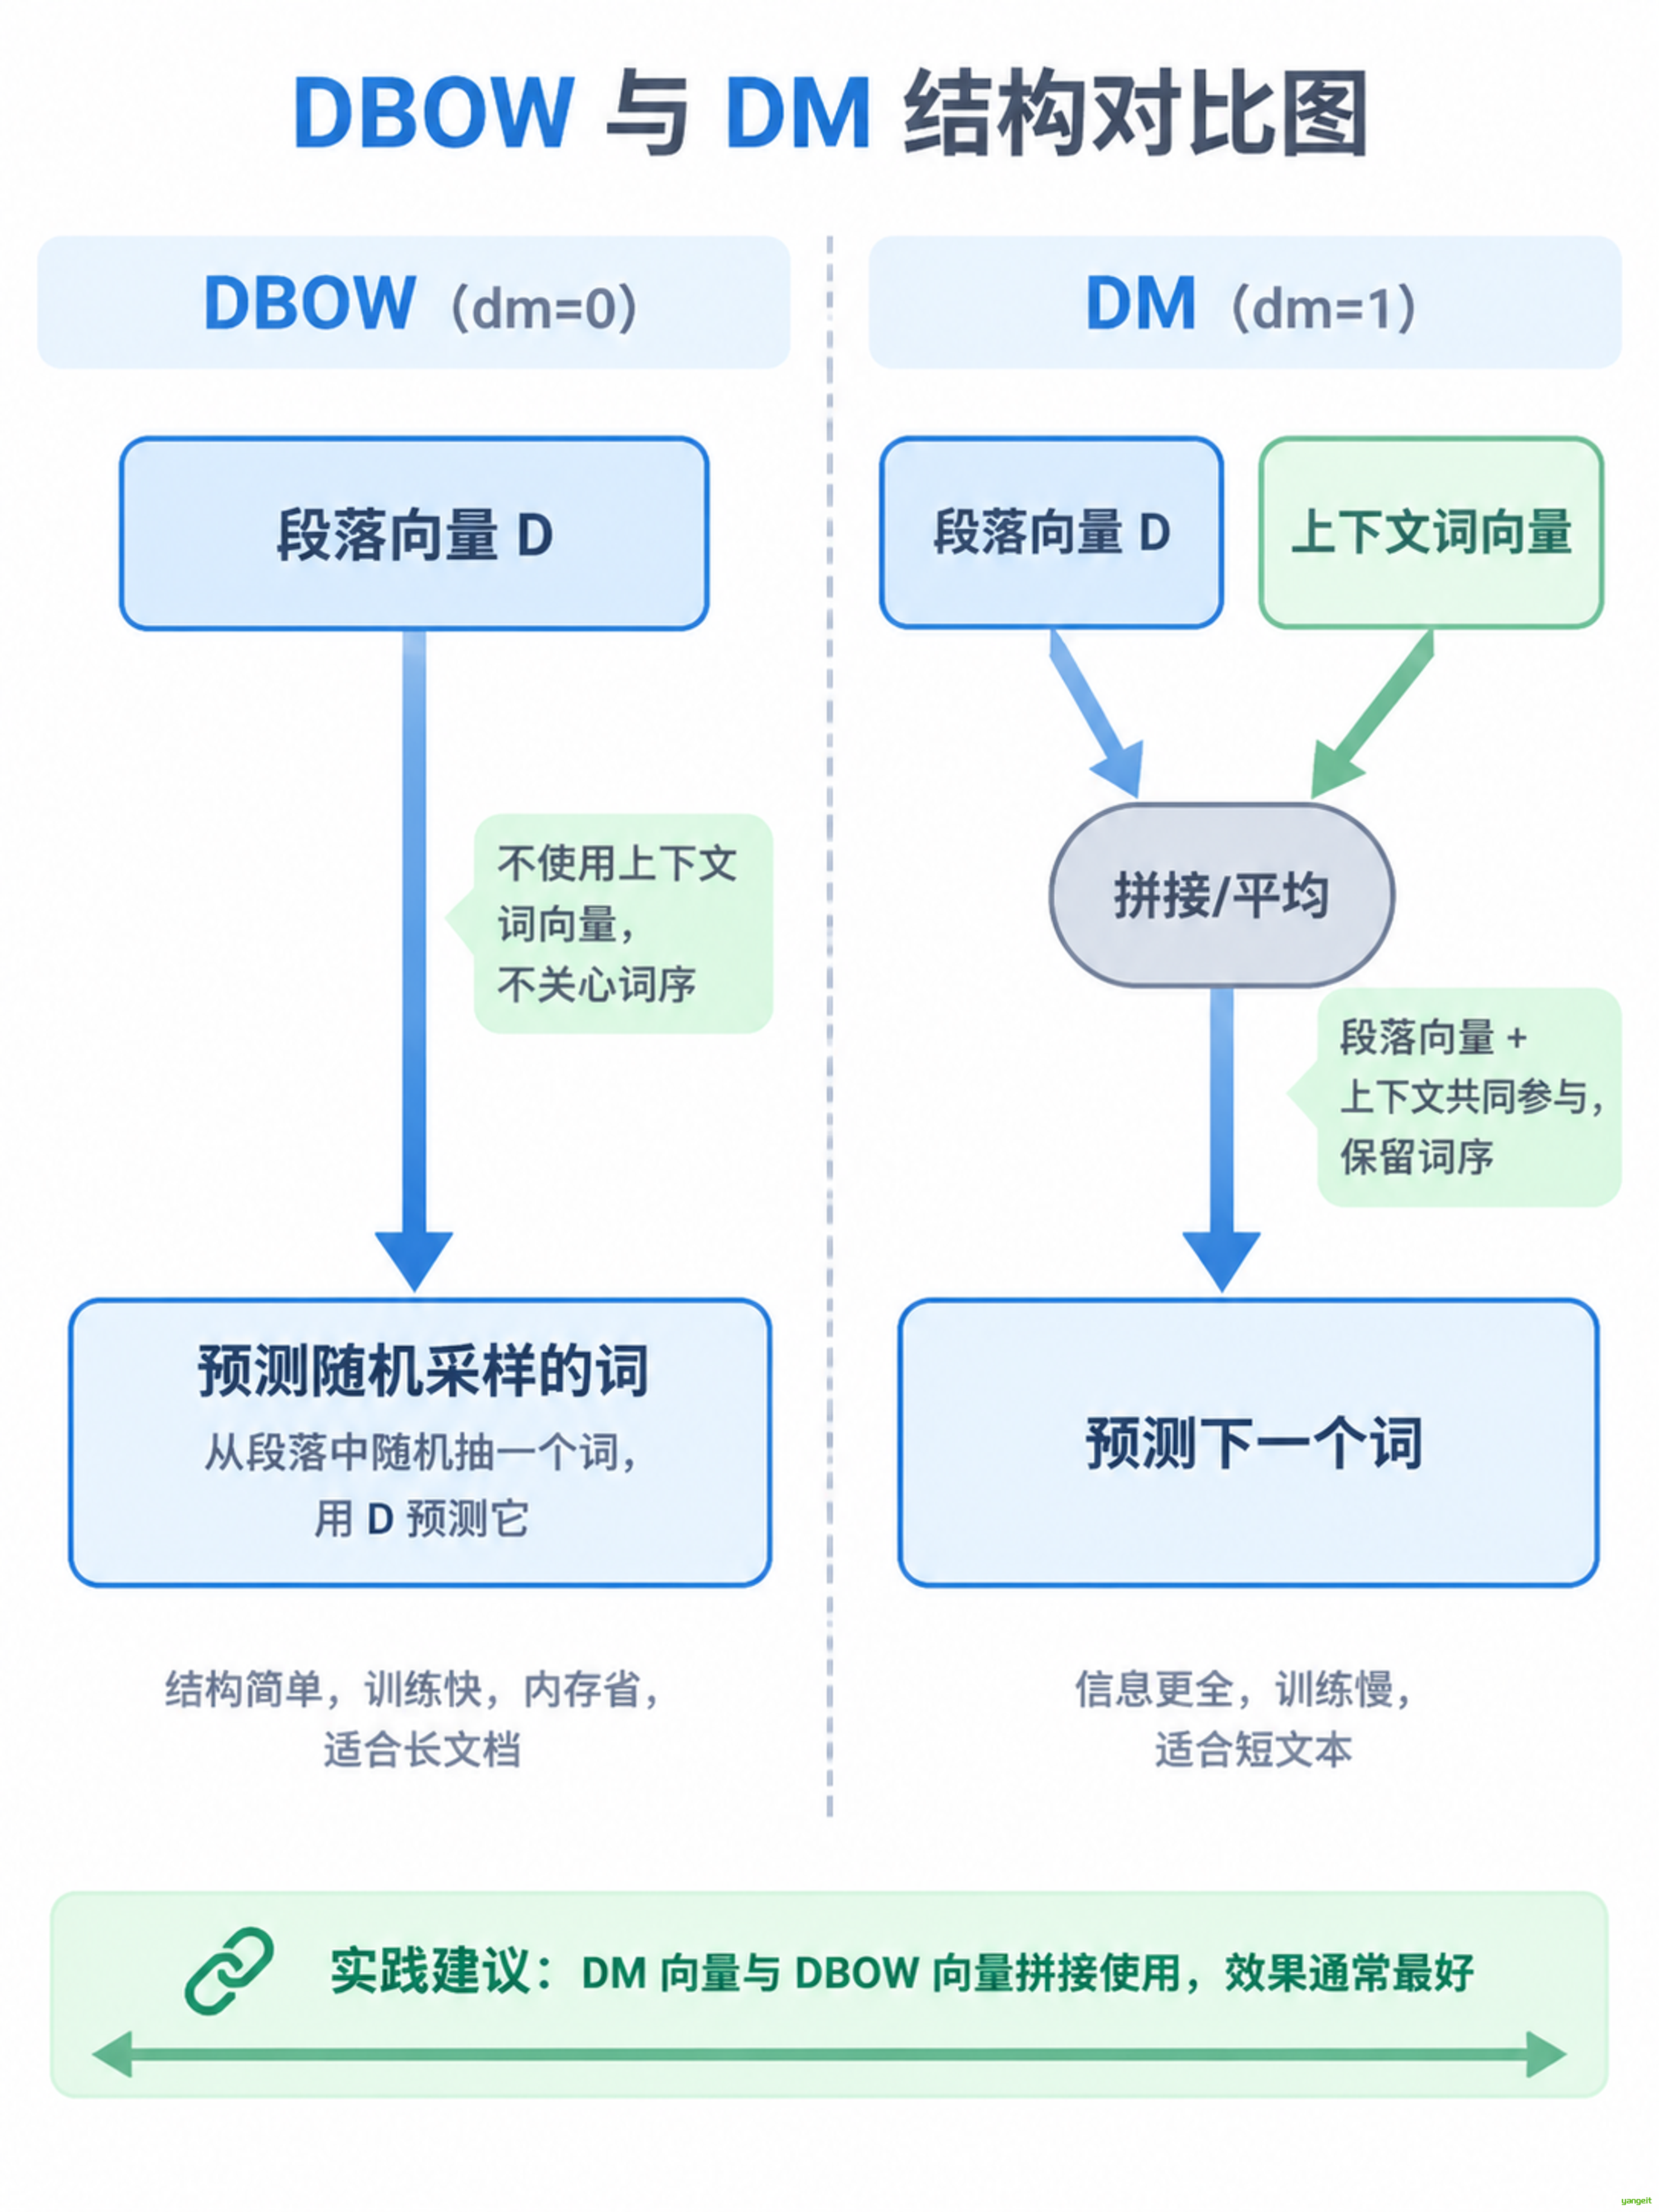
Doc2Vec(Paragraph Vector)直接为每个段落训练一个向量,它有两种结构: 👇👇
DM(Distributed Memory,dm=1):把段落向量和窗口内的词向量拼接或平均,一起去预测下一个词。段落向量像一个"记住这段话在讲什么"的记忆单元,它参与每一次预测,因此在训练中被反复更新。
DBOW(Distributed Bag of Words,dm=0):只用段落向量去预测从该段落随机采样的词,完全不使用上下文词向量。结构更简单、训练更快,但忽略词序。
gensim 里的三步流程: 👇
1. TaggedDocument(words=[...], tags=['0'])  → 给每个文档一个唯一标签
2. model.build_vocab(tagged_documents)      → 建立词表与文档表
3. model.train(...) → 训练,词向量与文档向量同时更新训练完成后,对训练时没见过的新句子用 model.infer_vector(分词结果) 推断向量。做法是:固定住已训练好的模型参数,只把新句子的段落向量当作待优化变量,跑若干轮梯度下降,让它尽可能"预测出"这句话里的词。
这里有个必须知道的事实:infer_vector 的初始向量是随机生成的,所以每次调用结果会有细微差异。本例在调用前用 model.random.seed(42) 固定随机种子,保证讲义里的数字和你本机跑出来的一致;如果发现结果对不上,先检查这一行在不在。
本节的语料与上一节完全相同:还是那 300 句,只是把每一句当作一篇"文档",并且给每篇打上编号标签。新增的 topics 列表记录每句的话题,用来验证"同话题的句向量确实更近"。
4.实操步骤
- 语料直接用公共 cell 里的
corpus和topics,和 CBOW 一节是同一份——词向量与句向量因此能横向对照。 - 用列表推导式把每个词元列表包成
TaggedDocument(words=..., tags=[str(i)]),标签用字符串下标保证唯一。 - 实例化
Doc2Vec:vector_size=50、window=5、min_count=1、dm=1、workers=1、seed=42、epochs=200。Doc2Vec 的轮数通常要比 Word2Vec 多,因为每篇文档只有一个段落向量在学。 - 先
build_vocab建词表与文档表,再train训练;训练完用model.dv[str(i)]取出 300 条文档向量,堆成矩阵。 - 对新句子"我想吃葡萄"用
jieba.lcut分词,model.random.seed(42)后infer_vector得到句向量。 - 调用公共 cell 里的
top_match,一次拿到"各话题最大相似度"和"全局最相似的 3 篇",验证新句是否落在同一个话题里。
对应源码片段
# 前置:先运行「2. 环境与依赖准备 → 公共素材」cell
# 本节用到:corpus、topics、corpus_texts、top_match、np

# 每句话打包成一篇文档:词元列表 + 唯一标签
docs = [TaggedDocument(words=w, tags=[str(i)]) for i, w in enumerate(corpus)]
print('文档数 =', len(docs), ' 总词数 =', sum(len(d.words) for d in docs))

# DM 模型:dm=1。轮数要比 Word2Vec 多,因为每篇文档只有一个段落向量在学
model = Doc2Vec(vector_size=50, window=5, min_count=1, dm=1,
                workers=1, seed=42, epochs=200)
                # vector_size:向量维度,与词表无关,与文档长度无关 window:上下文窗口大小
                # min_count:词频下限,低于此值的词忽略 dm:0=CBOW 1=DM workers:线程数
                # seed:随机种子,固定它才能复现 infer_vector 的结果 epochs:训练轮数200

# 建词表与文档表
model.build_vocab(docs) # 建词表与文档表
model.train(docs, total_examples=model.corpus_count, epochs=model.epochs)# corpus_count:文档数 epochs:训练轮数

# 训练文档的向量:dv 里按标签取,堆成一个 (文档数, vector_size) 的矩阵
doc_vecs = np.array([model.dv[str(i)] for i in range(len(docs))])

# 新句子:分词后推断向量。先固定随机种子,否则每次结果都不同
new_sentence = '我想吃葡萄'
new_tokens = jieba.lcut(new_sentence)
model.random.seed(42)
# infer_vector:固定模型参数,只优化新的段落向量
new_vec = model.infer_vector(new_tokens, epochs=200)

print('\n新句:', new_sentence, ' 分词 =', new_tokens)
print('新句向量:维度 =', new_vec.shape, ' 50 位全部非零 =', np.count_nonzero(new_vec) == 50)

# 按话题取最大相似度 + 打印最相似的 3 篇(函数在第 2 节公共 cell 里定义)
top_match(new_vec, doc_vecs, topics, corpus_texts)
【运行结果以及解析】
文档数 = 300  总词数 = 2000

新句: 我想吃葡萄  分词 = ['我', '想', '吃', '葡萄']
新句向量:维度 = (50,)  50 位全部非零 = True

新句与各话题的最大相似度:
  水果: 0.9496
  数码: 0.3785
  天气: 0.4978

最相似的 3 篇训练文档:
  [水果] 他 喜欢 在 早上 吃 新鲜 的 葡萄  余弦=0.9496
  [水果] 我 喜欢 在 早上 吃 新鲜 的 香蕉  余弦=0.9491
  [水果] 他 喜欢 在 早上 吃 新鲜 的 苹果  余弦=0.9460
解析与理论对照:
| 输出里看到 | 对应哪条理论 |
|---|---|
300 篇文档 → dv 矩阵 (300, 50) | 每篇文档一个段落向量,维度仍由人指定(50),与文档长度无关 |
| 新句只有 4 个词,也能得到 50 维、且 50 位全部非零的向量 | infer_vector 是推断,不是查表:它没有见过这句话,靠已有词向量反推段落向量;每一位都有值,这就是"稠密" |
| 水果 0.9496、天气 0.4978、数码 0.3785 | 三个话题拉开了 2 倍以上的差距,句向量确实区分了话题 |
| 最相似的 3 篇全是水果,第 1 名正是"吃…葡萄"那句,0.9496 | 单句层面也成立:语义越接近,余弦越高,可以直接用来做相似度检索 |
| 第 2、3 名是香蕉、苹果句,而不是其他葡萄句 | 模型抓的是"吃水果"这个整体语义,不只是词面重合(它们与"葡萄"没有一个字相同) |
| 上一节里"苹果-手机 = 0.1071" | 词级和句级量级不同但方向一致:同一套共现统计,词和句都能用 |
结论:DM 把"每篇文档一个向量"这件事做成了。它的训练目标决定了一个性质:段落向量不是词的拼盘,而是"这段话会用到哪些词"的压缩表示。这正是它能做检索、去重、聚类的原因。
思考题
- 把
dm改成 0(DBOW),其它参数不动,对比两组"三个主题的最大相似度"。
参考:DBOW 也能把新句判到水果(约 0.92),只是绝对相似度比 DM(约 0.95)略低。结构差异体现在细节上:DBOW 不看上下文词向量,学的是"这段会出现哪些词"的分布。 - 连续调用两次
infer_vector,第二次前不加model.random.seed(42),比较两个向量。
参考:前几位小数就开始分叉。推断是"随机初始化 + 若干轮梯度下降",初始点不同,落点就不同。这不是模型不稳定,但需要复现时必须在调用前固定种子。 - 把
epochs从 200 降到 20,重新训练,观察三个主题的最大相似度。
参考:三者挤到 0.89~0.93 这一小段区间里,新句"我想吃葡萄"甚至会被判成数码。轮数不足时段落向量还没收敛,相似度整体虚高、区分度消失——这比"相似度都很低"更迷惑人。 - 把新句换成"今天会下雨吗",观察它落到哪个话题。
参考:天气最高,0.98 量级;水果、数码都在 0.44 左右。分词结果是"今天/会/下雨/吗",其中"今天""下雨"在天气语料里反复出现,"吗"是未登录词会被忽略。同一套句向量,换一句新话,最近的话题就换了——这就是句向量能做语义检索的直接证据。 - 思考:DBOW 完全不用词序,为什么在长文档上效果仍然不错?
参考:长文档里词序带来的边际信息有限,"这段会出现哪些词"这个分布本身就足以刻画主题;而 DBOW 的训练目标正是拟合这个分布。同时它不需要加载上下文词向量参与运算,训练更快、内存更省,能处理更长的文档。
结论:DBOW 结构更简单、训练成本更低,用 dm=0 一行切换。它丢掉了词序,但训练目标(用段落向量预测本段出现的词)更直接,在长文档和大规模语料上表现良好;实践中常把 DM 与 DBOW 的向量拼接使用,兼顾词序与效率。读这段代码要抓住的是流程:TaggedDocument → build_vocab → train → dv 取训练向量 / infer_vector 推断新句。
模块小结
本模块覆盖文本向量化的七种方法,它们可以按表示形态分成两个阵营,也可以按"是否需要训练"分成两类。横向对比如下:
| 方法 | 代码 | 维度来源 | 稀疏 | 需训练 | 语义表达 | 一句话定位 |
|---|---|---|---|---|---|---|
| 独热编码 | 代码7-1 | 词表大小 | 是 | 否 | 无 | 最直观的入门表示,只回答"有没有" |
| BOW | 代码7-2 | 词表大小 | 是 | 否 | 无 | 在独热基础上加词频 |
| TF-IDF | 代码7-3 | 词表大小 | 是 | 否 | 无 | 离散表示里最实用,用 IDF 压低常见词 |
| CBOW | 代码7-4 | 人工指定 | 否 | 是 | 有 | 上下文预测当前词,快,高频词友好 |
| Skip-Gram | 代码7-4 | 人工指定 | 否 | 是 | 有 | 当前词预测上下文,慢,低频词友好 |
| DM | 代码7-5 | 人工指定 | 否 | 是 | 有 | 段落向量+词向量,保留词序 |
| DBOW | 代码7-5 | 人工指定 | 否 | 是 | 有 | 只用段落向量,快,适合长文档 |