NLP关键词提取
NLP关键词提取
NLP知识目标
- 理解关键词提取的作用。
- 理解 TF、IDF 和 TF-IDF 的含义。
- 理解 TextRank 和 PageRank 的关系。
- 理解 LSA 中词-文档矩阵、SVD 降维和潜在语义。
- 理解 LDA 中文档、主题和词语的概率关系。
- 能够比较四种算法的特点和适用场景。
1. 关键词提取【模块总理论】
关键词提取
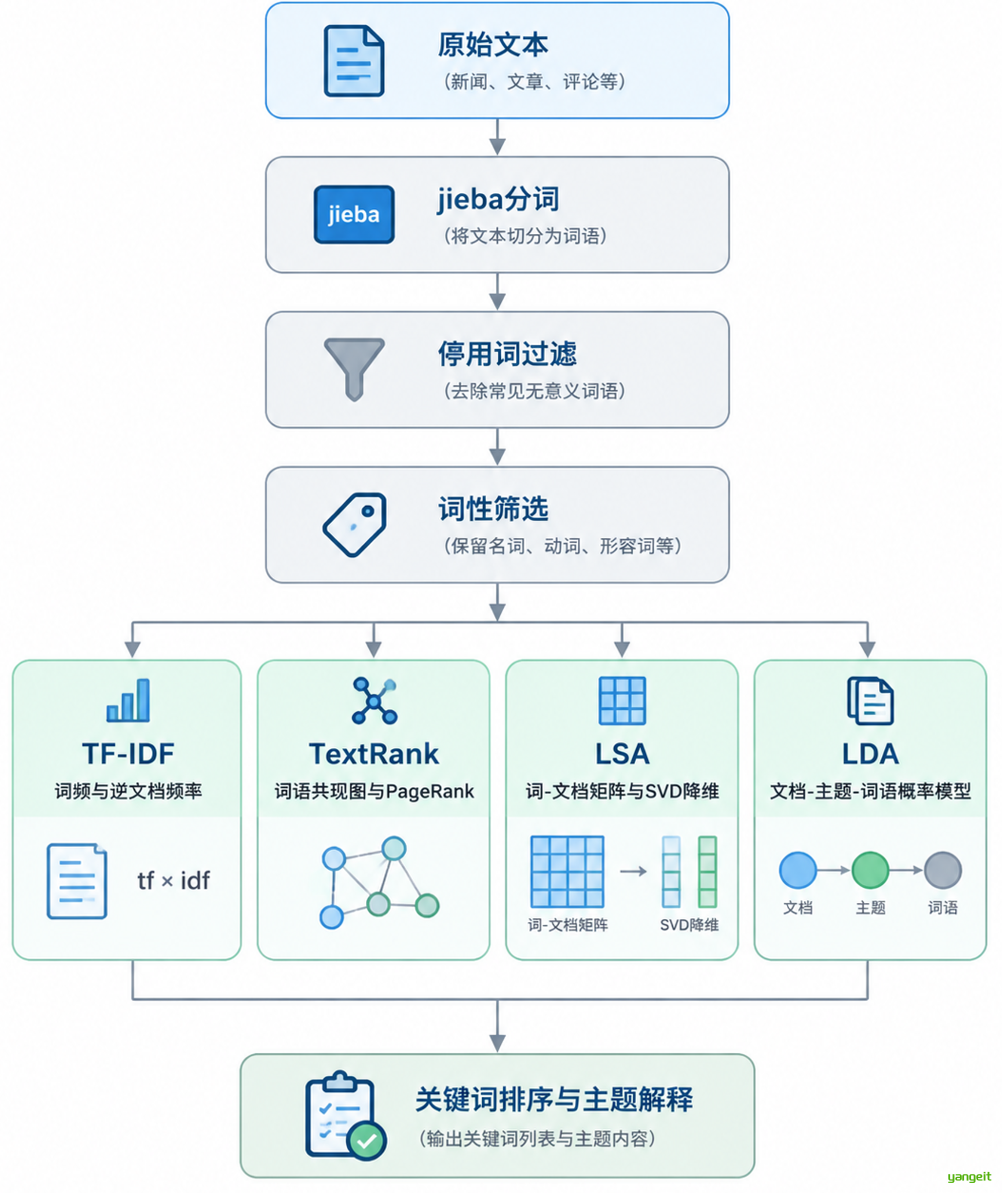
关键词提取是自然语言处理中的基础任务,目标是从一篇文章或一组文本中找出最能代表主题和内容的词语。它可以用于新闻标签、搜索匹配、文档分类、舆情分析、推荐系统和文本摘要。
关键词提取的一般流程:
原始文本 → 中文分词 → 停用词过滤 → 词性筛选
→ 词频矩阵、TF-IDF矩阵或词语关系图
→ 计算词语重要性 → 排序并输出关键词
四类经典提取关键词方法:
| 方法 | 核心思想 | 适合场景 |
|---|---|---|
| TF-IDF | 词频与文档频率相结合 | 单文档关键词提取 |
| TextRank | 词语共现图与PageRank | 无监督关键词提取 |
| LSA | SVD降维发现潜在语义 | 主题分析和语义表示 |
| LDA | 文档-主题-词语概率模型 | 多文档主题发现 |
2 环境与依赖准备
前言
推荐环境:Python 3.8 及以上,PyCharm、Visual Studio Code 或 Jupyter Notebook。
%pip install jieba scikit-learn networkx gensim numpy pandas -i https://pypi.tuna.tsinghua.edu.cn/simple
国内镜像源偶发同步延迟,若某源提示找不到包,换成备用源即可:
pip install jieba scikit-learn networkx gensim numpy pandas -i https://mirrors.aliyun.com/pypi/simple/综合实战建议准备以下目录:
项目目录/
├── data/
│   ├── word.txt
│   ├── stopword.txt
│   └── corpus.txt
└── jupyter文件
3.TF-IDF算法实现关键词提取【知识点1】
TF-IDF算法实现关键词提取
1.NLP知识点
- 理解 TF、IDF 和 TF-IDF 的含义。
- 理解词频矩阵与 TF-IDF 矩阵的区别。
- 理解为什么“当前文档常见、其他文档少见”的词更可能是关键词。
2.代码实操能力
- 使用 jieba 中文分词。
- 使用 CountVectorizer 构建词频矩阵。
- 使用 TfidfTransformer 计算 TF-IDF。
- 按权重从高到低输出关键词。
3.NLP理论知识点
TF 表示词语在当前文档中的出现频率,IDF 表示词语在整个文档集合中的稀有程度。二者相乘得到 TF-IDF:
TF-IDF(t,d) = TF(t,d) × IDF(t)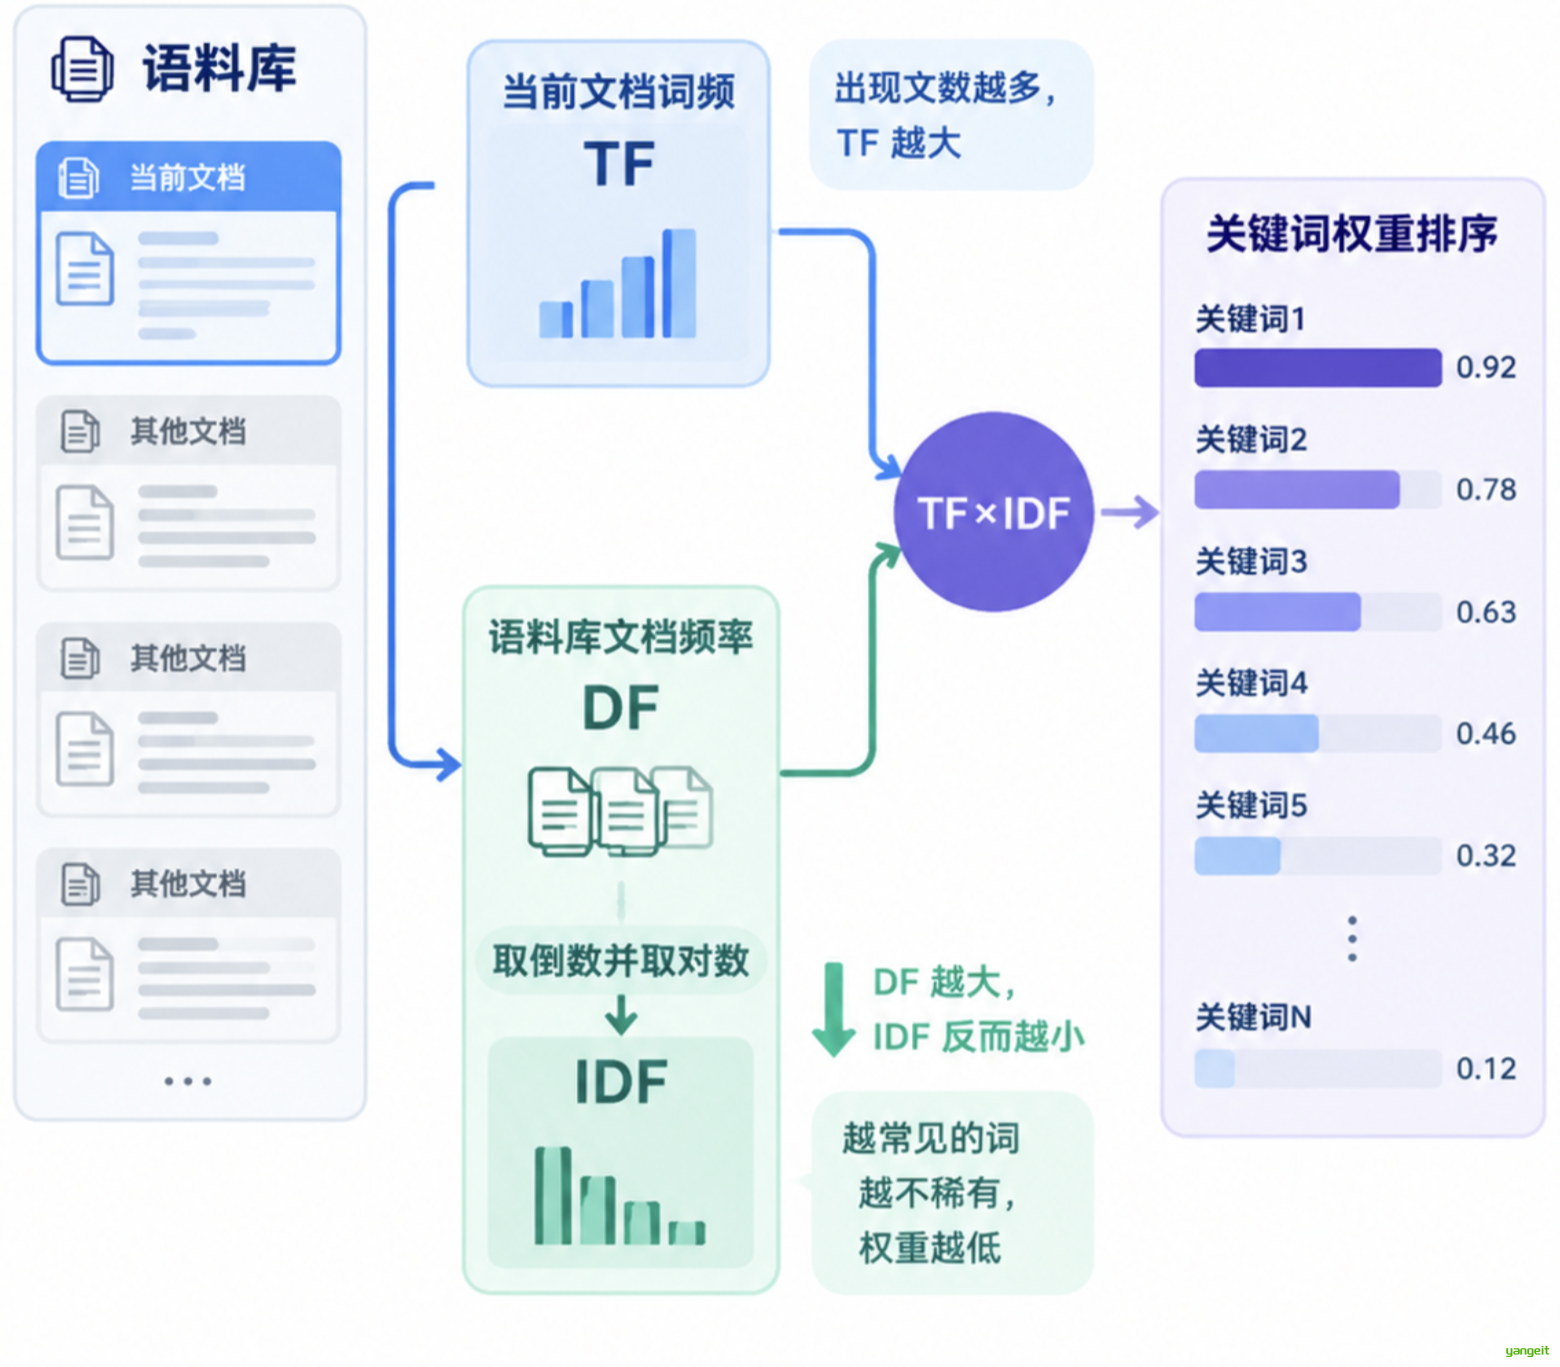
一个词在当前文档中出现很多次,且在其他文档中较少出现,它的 TF-IDF 往往较高。TF-IDF 是相对权重,不是词语“正确性”的判断。
4.实操步骤
- 准备中文文本列表 corpus。
- 使用 jieba.cut 分词,并用空格连接词语。
- 使用 CountVectorizer 生成词频矩阵。
- 使用 TfidfTransformer 生成 TF-IDF 矩阵。
- 读取特征词列表。
- 逐篇文档筛选权重大于 0 的词语并排序。
对应源码片段
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn
# 实测环境:Python 3.13 + jieba 0.42.1 + scikit-learn 1.9.1

# 一、导入工具库
import jieba  # 中文分词库:把连续的中文文本切分为一个个词语
from sklearn.feature_extraction.text import (
    CountVectorizer,    # 词频统计器:把文本转成"词频矩阵"
    TfidfTransformer    # TF-IDF转换器:在词频矩阵基础上再乘上IDF并归一化
)

# 二、准备语料(文档集合)
# TF-IDF 必须"同时看到多篇文档"才有意义:
# 因为 IDF 衡量的是"一个词在多少篇文档里出现过",单篇文档算不出 IDF。
corpus = [
    "这是一篇关于NLP的文章",
    "文本数据预处理非常重要",
    "TF-IDF是一种常用的文本特征提取方法",
    "关键词提取可以帮助我们理解文本的主题",
    "文本分类是NLP中的重要任务之一"
]

# 三、中文分词
# CountVectorizer 默认的切分规则按空格/标点取词,中文词之间没有空格,
# 所以必须先用 jieba 分词,再用空格把词语连起来,否则整句话会变成一个"词"。
seg_corpus = []                      # 保存"空格分隔的分词结果"
for text in corpus:
    # jieba.cut() 返回一个生成器(迭代器),用 " ".join() 拼成字符串
    seg_corpus.append(" ".join(jieba.cut(text)))

# 四、构建词频矩阵(TF矩阵)
vectorizer = CountVectorizer()       # 行 = 文档,列 = 词语,单元格 = 该词在该文档中的出现次数
term_frequency_matrix = vectorizer.fit_transform(seg_corpus)
# fit_transform = fit(扫描全部文本建立词表)+ transform(按词表把文本转成矩阵)
# 返回的是稀疏矩阵(scipy csr_matrix):绝大多数单元格是0,只存非0值以节省内存

# 五、把词频矩阵转换成 TF-IDF 矩阵
tfidf_transformer = TfidfTransformer()
tfidf_matrix = tfidf_transformer.fit_transform(term_frequency_matrix)
# 这一步做了三件事(sklearn 默认参数):
#   1) 计算 IDF:idf(t) = ln((1 + N) / (1 + df(t))) + 1
#      N = 文档总数,df(t) = 含有词 t 的文档数 → 词越"到处都有",IDF 越小
#      末尾的 +1 是平滑项(smooth_idf=True),保证 IDF 恒为正,不会因某词出现在所有文档而变负
#   2) TF × IDF:把每个单元格的词频乘上该词的 IDF
#   3) L2 归一化(norm='l2'):让每一行的平方和为1,消除"长文档词频普遍偏高"的影响
# 因此最终数值不再是"词频",而是"当前文档中的相对权重",同一行内可比较大小

# 六、读取词表并输出每篇文档的关键词
feature_names = vectorizer.get_feature_names_out()   # 第 j 列对应哪个词
for i in range(len(corpus)):                          # i 是文档下标,同时用于取矩阵的第 i 行
    doc_keywords = []
    for j, feature in enumerate(feature_names):       # j 是词语(列)下标
        score = tfidf_matrix[i, j]                    # 取出"文档i 中 词j"的TF-IDF权重
        if score > 0:                                 # 权重为0表示该词没在这篇文档出现
            doc_keywords.append((feature, score))

    # key=lambda item: item[1] 表示用元组的第2项(分数)排序;reverse=True 表示从高到低
    doc_keywords.sort(key=lambda item: item[1], reverse=True)

    print("文档{}的关键词:".format(i + 1))
    for keyword, score in doc_keywords:
        print("{} ({:.4f})".format(keyword, score))   # :.4f 表示浮点数保留4位小数
    print()
预期输出:控制台会依次打印每篇文档的关键词及其 TF-IDF 分数。本例的分词结果与完整输出已在下方"运行结果"中给出,可直接对照核对。
【运行结果以及解析】
以下为实际运行结果(Python 3.13 + jieba 0.42.1 + scikit-learn 1.9.1)。
第 1 步:jieba 分词结果(这是理解后续一切数字的前提)
这是 一篇 关于 NLP 的 文章
文本 数据 预处理 非常 重要
TF - IDF 是 一种 常用 的 文本 特征提取 方法
关键词 提取 可以 帮助 我们 理解 文本 的 主题
文本 分类 是 NLP 中 的 重要 任务 之一
第 2 步:TF-IDF 权重输出
文档1的关键词:
一篇 (0.4637)
关于 (0.4637)
文章 (0.4637)
这是 (0.4637)
nlp (0.3741)

文档2的关键词:
数据 (0.5020)
非常 (0.5020)
预处理 (0.5020)
重要 (0.4050)
文本 (0.2828)

文档3的关键词:
idf (0.3979)
tf (0.3979)
一种 (0.3979)
常用 (0.3979)
方法 (0.3979)
特征提取 (0.3979)
文本 (0.2241)

文档4的关键词:
主题 (0.3697)
关键词 (0.3697)
可以 (0.3697)
帮助 (0.3697)
我们 (0.3697)
提取 (0.3697)
理解 (0.3697)
文本 (0.2083)

文档5的关键词:
之一 (0.4653)
任务 (0.4653)
分类 (0.4653)
nlp (0.3754)
重要 (0.3754)
文本 (0.2621)
解析与理论对照: 👇
为什么同一篇文档里多个词分数完全相同? 文档1 中"一篇、关于、文章、这是"都是 0.4637。因为它们都只出现 1 次(TF 相同),且都只在文档1 出现(DF 相同 → IDF 相同),所以 TF×IDF 必然相同。这印证了公式
TF-IDF = TF × IDF:分数只由"出现次数"和"出现文档数"两个量决定,与词语本身的含义无关。为什么"文本"分数总是最低? "文本"出现在文档2、3、4、5 共 4 篇中,DF 大 → IDF 小 → 权重被压低(0.2083~0.2828)。这正是 IDF 的设计目的:在所有文档都常见的词,区分能力差。
为什么"nlp"比同文档的其它词低一档? 文档1 和文档5 都含"nlp",DF=2;而"一篇"等 DF=1。DF 从 1 升到 2,IDF 立刻下降,分数随之降低(0.4637 → 0.3741)。
注意"TF-IDF"被 jieba 切成了"TF - IDF"三段:"-"是个单独 token,但 CountVectorizer 默认
token_pattern要求词长 ≥ 2,所以单字符的"-"被丢弃,最终词表里只剩tf和idf两个词。英文会被统一转成小写。这些分数不能直接跨文档比较。TfidfTransformer 默认做 L2 归一化,每行的平方和为 1;文档3 有 7 个词、文档4 有 8 个词,词数越多,每个词分到的权重就越小。所以 0.5020(文档2)并不代表"数据"比 0.3979(文档3)的"特征提取"更重要,分数只能在同一篇文档内部比较。
结论:
- TF-IDF 排序的依据是统计量,不是语义。"这是""可以""我们"这类虚词也拿到了高分,只因为它们在语料中罕见——本例没有做停用词过滤,这是真实暴露出来的问题。
- 语料规模直接决定结果质量。5 篇短文档构成的语料太小,几乎所有词都只出现在 1 篇文档里,导致 IDF 的区分作用被削弱,出现大量并列分数。
- 工程上的正确做法:先过滤停用词、再用
TfidfVectorizer(把 CountVectorizer + TfidfTransformer 合成一步)、最后只取 Top-5 或 Top-10。
常见易错坑
- 未安装依赖会出现 ModuleNotFoundError。
- 分词结果没有用空格连接,向量化器可能无法正确识别中文词语。
- TF-IDF 会随着语料变化而变化,不是固定分数。
- 没有停用词过滤时,“的、了、是”等词可能干扰结果。
- 实际应用通常只保留前 5 个或前 10 个关键词。
自学小练习+思考题
- 修改代码,只输出每篇文档权重最高的 3 个关键词。
- 增加一篇包含“人工智能”的文本,观察已有词语权重是否变化。
- 为什么一个词在所有文档中出现时,通常不适合作为关键词?
4.使用TextRank算法实现关键词提取【知识点2】
前言
1.NLP知识点
- 理解 TextRank 将词语表示为图节点的思想。
- 理解词语共现关系和边权重。
- 理解 PageRank 如何根据节点连接关系计算重要性。
2.代码实操能力
- 使用 jieba.posseg 进行分词和词性标注。
- 筛选名词,构建词语共现图。
- 使用 networkx 运行 PageRank。
- 输出前 topK 个关键词。
3.NLP理论知识点
TextRank 将文本中的候选词语看作图节点,将相近位置共同出现的词语连接为边。两个词语共同出现次数越多,边权重越大。PageRank 通过迭代传播权重,使与多个重要节点相连的词语获得更高分数。
4.实操步骤
- 使用词性标注得到词语和词性。
- 只保留名词作为候选关键词。
- 创建无向图并添加节点。
- 在共现窗口范围内让词语建立边,重复共现时增加边权重,并跳过自身避免自环。
- 使用 nx.pagerank 计算节点重要性。
- 按分数降序返回关键词。
对应源码片段
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba networkx
# 实测环境:Python 3.13 + jieba 0.42.1 + networkx 3.7

import jieba.posseg as pseg  # posseg:分词的同时返回 (词语, 词性) 二元组
import networkx as nx        # 提供图结构与 PageRank 迭代算法


def textrank_keyword(text, topK=10, window=2):
    """用 TextRank 从一段文本中提取关键词。

    参数说明:
      topK   -- 返回前几个关键词(不传时默认 10 个)
      window -- 共现窗口大小:每个词只与"它后面 window 个词"连边
    """
    # 一、分词 + 词性筛选:TextRank 通常只保留名词/动名词作为候选关键词
    words = pseg.cut(text)                       # 返回可迭代的 (词语, 词性)
    word_list = [word for word, flag in words if flag.startswith("n")]  # 只保留名词

    # 二、建图:节点 = 词语,边 = 共现关系,边权 = 共现次数
    graph = nx.Graph()
    graph.add_nodes_from(set(word_list))          # set 去重后批量添加节点

    for i, word_i in enumerate(word_list):
        # 关键修正 1:使用"窗口"限制连边范围。
        # 原写法 range(i + 1, len(word_list)) 会把全文所有词两两连边,
        # 这不是 TextRank 的定义,且会让任意两个词都只共现 1 次,边权永远为 1。
        right = min(len(word_list), i + window + 1)   # +1 因为 range 右端是开区间
        for j in range(i + 1, right):
            word_j = word_list[j]
            # 关键修正 2:跳过自己,禁止产生自环。
            # 若 word_list 里有重复词(例如"算法"出现多次),word_i == word_j 时
            # 原写法会执行 add_edge(算法, 算法),生成自环,严重扭曲 PageRank。
            if word_i == word_j:
                continue
            if graph.has_edge(word_i, word_j):   # 已经连过 → 共现次数 +1
                graph[word_i][word_j]["weight"] += 1
            else:                                # 首次共现 → 建边,权重从 1 开始
                graph.add_edge(word_i, word_j, weight=1)

    # 三、跑 PageRank:把重要性沿边反复传播,直到收敛
    # 默认参数:damping 阻尼系数 0.85,最多迭代 100 次,容差 1e-6
    # networkx 的 pagerank 会自动读取边上的 weight 属性作为传播权重
    pagerank = nx.pagerank(graph)                # 返回 {词语: 分数} 字典,分数之和为 1

    # 四、按分数从高到低排序,截取前 topK 个
    return sorted(pagerank, key=pagerank.get, reverse=True)[:topK]


# ---- 示例 1:教材原用的短文本 ----
text = "这是一个使用TextRank算法实现关键词提取的例子。"
print("示例1 结果:", textrank_keyword(text, topK=5))

# ---- 示例 2:较长的文本,才能体现 TextRank 的区分能力 ----
text2 = ("关键词提取是自然语言处理中的一项基础任务,它的目标是从一段文本中自动找出最能代表文本主题的词语。"
         "TextRank算法把文本中的词语构建成图结构,通过词语之间的共现关系来发现关键词。"
         "TF-IDF算法通过统计词频和逆文档频率来衡量词语的重要性。"
         "关键词提取的结果可以用于文本分类、信息检索和自动摘要等任务。")
print("示例2 结果:", textrank_keyword(text2, topK=8))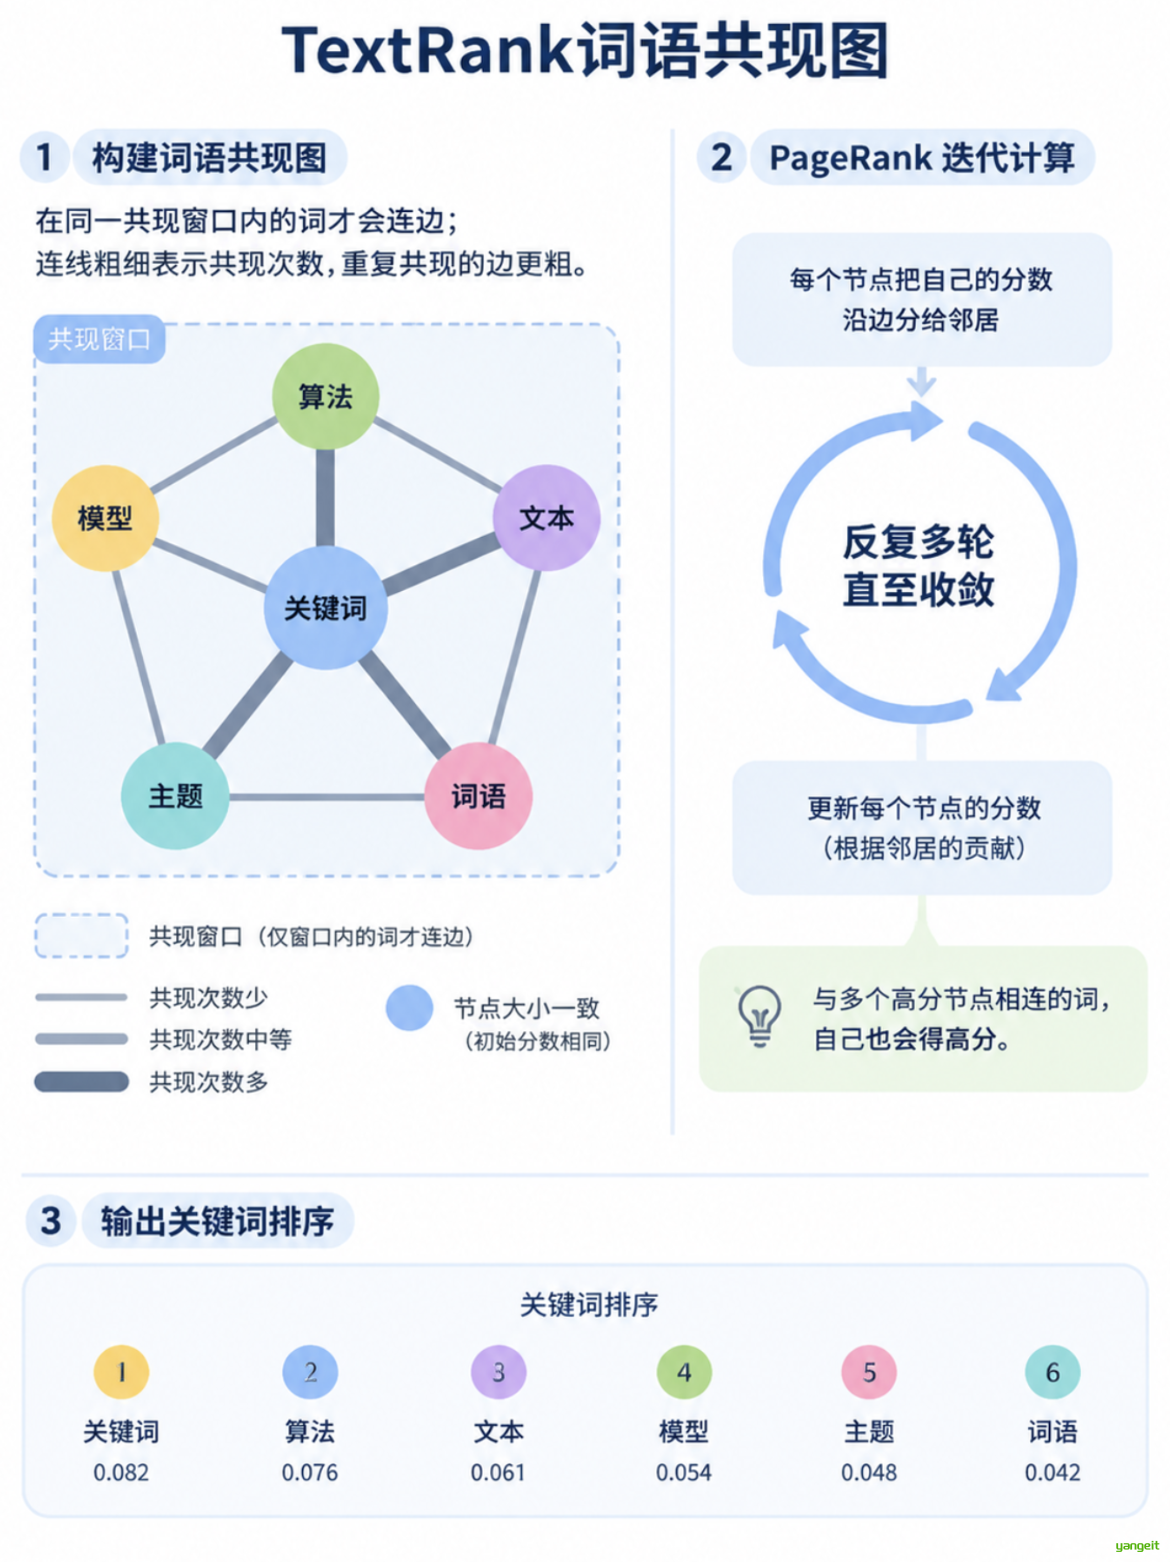
【运行结果以及解析】
以下为实际运行结果(Python 3.13 + jieba 0.42.1 + networkx 3.7)。
先看词性标注,确认哪些词能成为候选词:
这/r 是/v 一个/m 使用/v TextRank/eng 算法/n 实现/v 关键词/n 提取/v 的/uj 例子/n 。/x只有 算法、关键词、例子 三个词带 n 词性,其余全部被过滤。
实际输出:
示例1 结果: ['例子', '关键词', '算法']     ← 顺序每次运行都可能不同
示例2 结果: ['文本', '词语', '关键词', '算法', '任务', '逆', '文档', '分类']   ← 稳定
把示例1 连续运行 5 次,得到 4 种不同排列:
['例子', '关键词', '算法']
['例子', '算法', '关键词']
['算法', '关键词', '例子']
['例子', '算法', '关键词']
['关键词', '例子', '算法']
解析与理论对照:
示例1 为什么只输出 3 个词? 短文本里只有 3 个名词,
topK=5但候选不足,只能返回 3 个。为什么短文本必然退化? 因为一共只有 3 个名词,窗口无论怎么设,它们都会全部连到一起。TextRank 依赖"有的词连接多、有的词连接少"才能产生区分,文本太短时这个方法没有用武之地。
示例2 才体现了 TextRank 真正的机制。 长文本中边权出现了明显差异:
('文本','词语',3) ('文本','代表',2) ('关键词','词语',2) ('算法','词语',2) ('词语','结构',2) ..."文本"和"词语"共同出现了 3 次,边最粗,于是它们互相"投票"最多,PageRank 分数也最高:
文本 0.1206 > 词语 0.1180 > 关键词 0.0881 > 算法 0.0707 > 任务 0.0585 > ...这正是理论的体现:与多个高分节点相连的词,自己也会得高分(PageRank 的"被重要节点引用者更重要")。
"逆"为什么能进前八? jieba 把"逆文档频率"切成了"逆 / 文档 / 频率","逆"被标成名词而进入候选。这说明 TextRank 的结果质量高度依赖分词粒度——分词切碎了,垃圾词就会混进来。
结论:
- TextRank 的排序依据是图结构中的连接关系(谁跟谁挨着、挨了几次),与 TF-IDF 的"词频 × 文档频率"完全是两套逻辑,所以同一段文本两种方法给出的排序常常不同。
- 文本越短,TextRank 越不可靠;实战中应保证文本有足够的长度(通常至少几十个词)。
- 只用
flag.startswith("n")保留名词会漏掉"TextRank"这类英文术语和"提取"这类动词;实际任务中常放宽为n / v / eng,或改用jieba.analyse.extract_tags(其内部就是 TextRank 的成熟实现)。
5.常见易错坑
- 文本中没有识别为名词的词语时,图可能为空。
- 只保留名词过于严格,可以按任务增加动词或英文词。
- 文本很长时,词语之间可能建立过多边,运行速度变慢。
- set 只用于节点去重,不能代替边权重统计。
- 同分词语的顺序可能因版本不同而变化。
6.自学小练习+思考题
- 改为同时保留名词和动词。
- 增加窗口大小参数,只连接前后 2 个词。
- 输出每个关键词对应的 PageRank 分数。
- 为什么词频不高的词,仍可能在 TextRank 中排名靠前?
5.LSA算法进行中文关键词提取【知识点3】
前言
1.NLP知识点
- 理解词-文档矩阵。
- 理解 LSA 如何通过 SVD 降维发现潜在语义。
- 理解主题关键词与原始词频关键词的差别。
2.代码实操能力
- 编写分词和停用词过滤函数。
- 使用 CountVectorizer 构建词频矩阵。
- 使用 TruncatedSVD 降维。
- 读取每个潜在主题的高权重词语。
3.NLP理论知识点
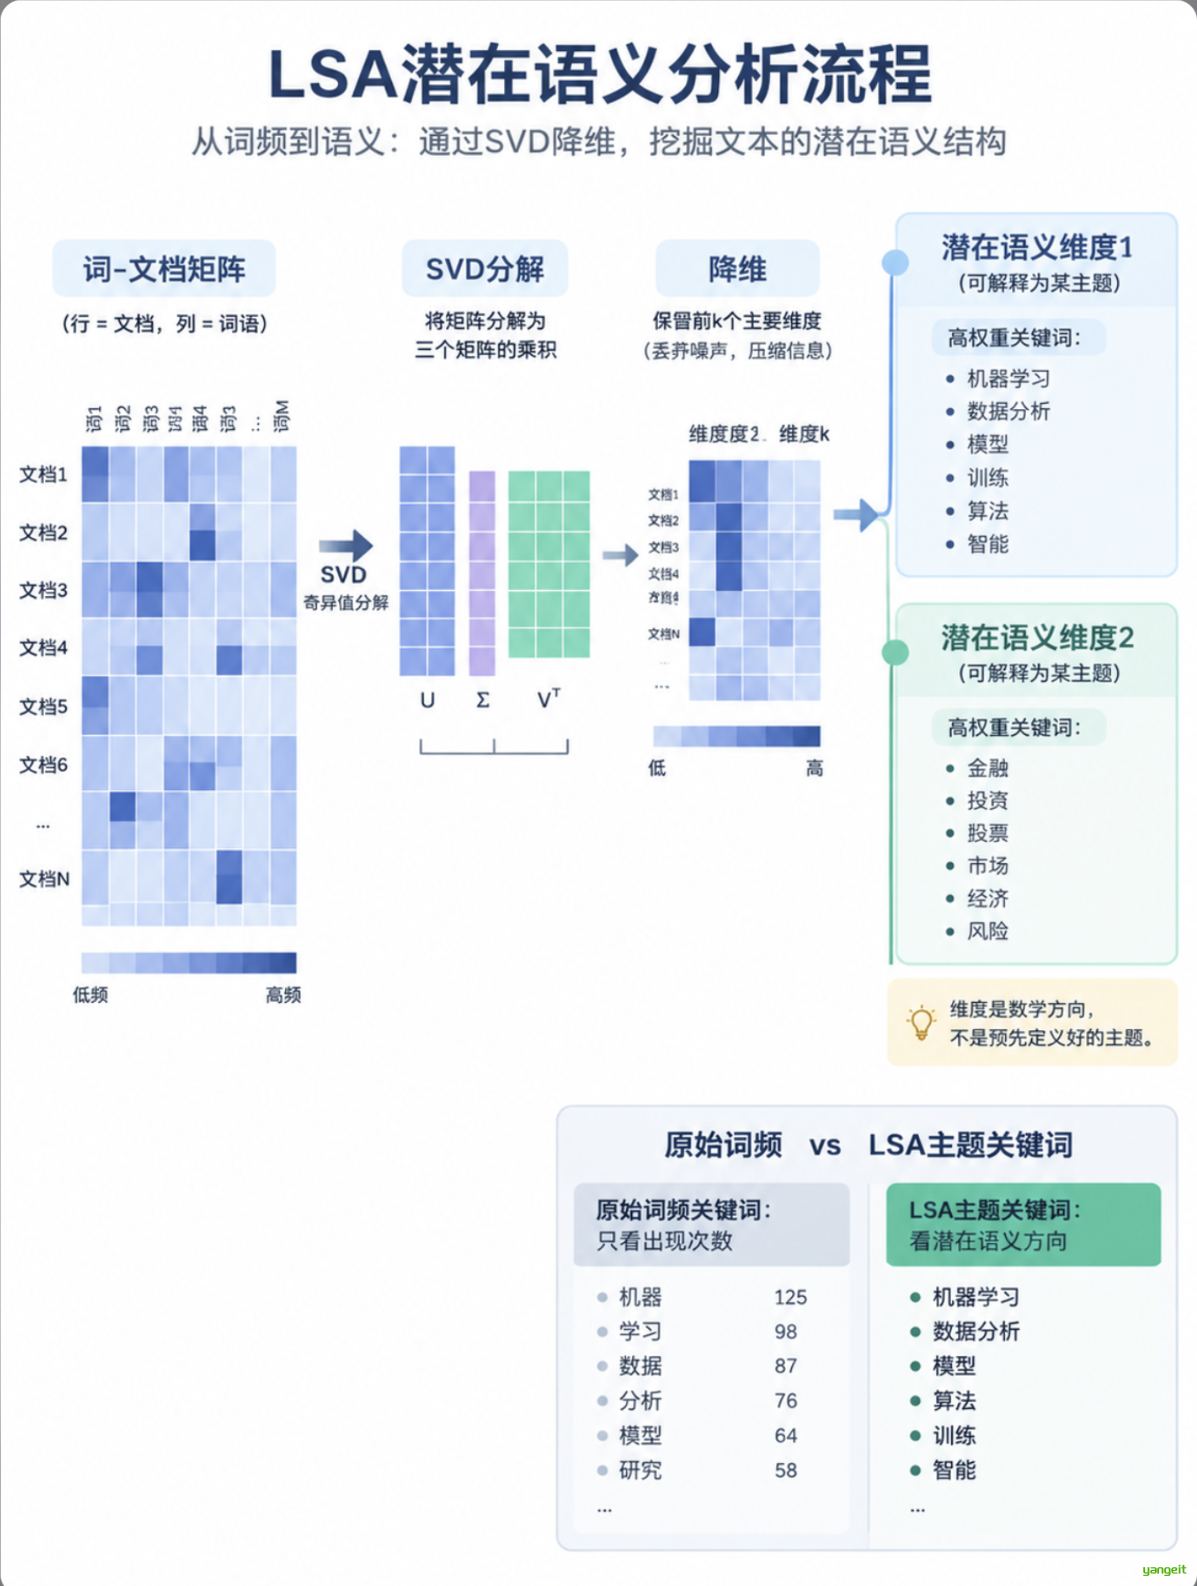
LSA 先构建词-文档矩阵,再通过 SVD 将高维矩阵压缩到较低维度。降维后的每个方向可以看作一种潜在语义方向,再从该方向中找出权重较高的词语。
4.实操步骤
- 使用 jieba.lcut 分词。
- 删除停用词和单字词。
- 使用 CountVectorizer 构建词频矩阵。
- 使用 TruncatedSVD 保留两个潜在维度。
- 对每个主题维度的词语权重排序。
- 输出前 5 个主题关键词。
对应源码片段
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba scikit-learn
# 实测环境:Python 3.13 + jieba 0.42.1 + scikit-learn 1.9.1

import jieba  # 提供中文分词;LSA 前必须先把文本切成词语序列
from sklearn.feature_extraction.text import CountVectorizer  # 把文本转成词频矩阵
from sklearn.decomposition import TruncatedSVD  # 对高维稀疏矩阵做"截断SVD"降维


def preprocess_text(text):
    """文本预处理:分词 → 去停用词 → 去单字 → 用空格拼回字符串。"""
    seg_list = jieba.lcut(text)          # lcut 直接返回 list(cut 返回的是生成器)
    stopwords = {"的", "了", "是", "我", "你", "他"}
    # 停用词不携带主题信息,必须在建矩阵之前删除,否则会占据主题权重
    words = [word for word in seg_list
             if word not in stopwords and len(word) > 1]   # len>1 过滤单字词
    return " ".join(words)               # CountVectorizer 需要空格分隔的输入


corpus = [
    "这是一篇关于机器学习的文章",
    "机器学习是人工智能的一个重要领域",
    "人工智能正在改变我们的生活",
    "机器学习的应用非常广泛",
    "人工智能会带来技术革命"
]

# 逐篇预处理,得到与 corpus 一一对应的字符串列表
processed_corpus = [preprocess_text(text) for text in corpus]

# 一、构建词-文档矩阵(这里是"词频矩阵",行=文档,列=词语)
vectorizer = CountVectorizer()
tf_matrix = vectorizer.fit_transform(processed_corpus)

# 二、SVD 降维:把 20 维的词空间压缩到 2 维
# n_components=2 表示只保留最重要的 2 个潜在语义方向
# random_state=42 固定随机种子,保证每次运行结果一致、便于复现
svd = TruncatedSVD(n_components=2, random_state=42)
lsa_matrix = svd.fit_transform(tf_matrix)     # 形状 = (文档数, 2),每篇文档的主题坐标
features = vectorizer.get_feature_names_out()  # 词表:第 j 列对应哪个词

# 三、读取每个潜在主题的高权重词
# svd.components_ 的形状是 (2, 词表大小):第 i 行就是第 i 个主题方向
# 行内每个数表示该词在这个主题方向上的权重(可正可负,这里取最大的正值)
for i, component in enumerate(svd.components_):
    # argsort() 返回从小到大排列的下标;[::-1] 反转成从大到小;[:5] 取前 5 个
    indexes = component.argsort()[::-1][:5]
    keywords = [features[index] for index in indexes]
    print("第%d个主题的关键词:" % (i + 1), keywords)
    # 补充打印权重,便于观察"高权重"究竟有多高、词与词之间差多少
    print("    对应权重:", [round(float(component[index]), 4) for index in indexes])

print("\n各文档在主题空间中的坐标(lsa_matrix):")
print(lsa_matrix.round(4))
【运行结果以及解析】
以下为实际运行结果(Python 3.13 + jieba 0.42.1 + scikit-learn 1.9.1)。
第 1 步:分词与预处理结果(这是后面所有数字的基础)
这是 一篇 关于 机器 学习 文章
机器 学习 人工智能 一个 重要 领域
人工智能 正在 改变 我们 生活
机器 学习 应用 非常 广泛
人工智能 带来 技术 革命
第 2 步:主题关键词输出
第1个主题的关键词: ['学习', '机器', '人工智能', '领域', '重要']
    对应权重: [0.537, 0.537, 0.2895, 0.1982, 0.1982]
第2个主题的关键词: ['人工智能', '正在', '生活', '我们', '改变']
    对应权重: [0.5898, 0.2949, 0.2949, 0.2949, 0.2949]

各文档在主题空间中的坐标(lsa_matrix):
[[ 1.8047 -0.8847]
 [ 1.9581  0.5898]
 [ 0.4865  1.7693]
 [ 1.5423 -0.5898]
 [ 0.4158  1.1795]]
解析与理论对照:
⚠️ 一个很容易踩的坑:jieba 默认词典里没有"机器学习"这个词。 凭语感推测,很多人会以为第一个主题是
['机器学习', '人工智能', '应用', '领域', '重要'];但 jieba 0.42.1 把"机器学习"切成了机器+学习,二者各占 0.537 的权重,恰好并列第一。"技术革命"同理被切成技术+革命。LSA 看不到"词"以外的任何语义,分词怎么切,结果就怎么长——这是所有基于词袋的方法共同的硬约束。两个主题如何解释? 主题是数学方向,没有内置名字,要靠高权重词人工命名:
- 主题1 由
学习 / 机器 / 人工智能 / 领域 / 重要主导 → 偏向"机器学习作为一个学科领域"; - 主题2 由
人工智能 / 正在 / 生活 / 我们 / 改变主导 → 偏向"人工智能对社会生活的影响"。
- 主题1 由
为什么"机器"和"学习"权重完全一样? 因为这两句里它们总是成对出现("机器学习"共出现 3 次),在矩阵中两列完全相同,SVD 自然给出相同权重。这正是 LSA 发现"潜在语义"的方式:把总是结伴出现的词压缩到同一个方向上。
⚠️ 本例暴露的真实缺陷:高频虚词抢权重。 主题1 的完整权重排序里:
学习 0.537 / 机器 0.537 / 人工智能 0.2895 / 领域 0.1982 / 重要 0.1982 / 一个 0.1982 / 关于 0.1827 / 这是 0.1827 / 文章 0.1827 / 一篇 0.1827 / 广泛 0.1561 / 非常 0.1561 / 应用 0.1561 ...一个、这是、一篇、关于这些毫无主题意义的词,权重(0.1827)竟然高于真正的核心词应用(0.1561)。原因是本例对原始词频矩阵做 SVD——只要一个词出现得多,它就会被当成"重要方向"。标准的 LSA 应当先转成 TF-IDF 矩阵再降维,用 IDF 压低到处都出现的词,才能缓解这个问题。(停用词表太小也是原因之一:这里只设了 6 个停用词。)lsa_matrix 怎么用? 5 行分别对应 5 篇文档。第 1、2、4 篇在第 1 列上取值较大(1.80 / 1.96 / 1.54),说明它们都强烈偏向主题1,而这正是语料中讲"机器学习"的三篇;第 3、5 篇在第 2 列上更大(1.77 / 1.18),对应讲"人工智能改变生活"的两篇。降维后的坐标可以直接用于文档相似度比较和聚类。
结论:
- LSA 的排序依据是矩阵分解得到的方向权重,反映的是"哪些词倾向于在同一批文档里一起出现",属于语料层面的统计规律;它和 TF-IDF(单文档内的词频对比)、TextRank(词与词的相邻关系)看的是完全不同的东西。
- 主题数是人为设定的超参数,本例设 2 就得到 2 个方向;设多少没有标准答案,需要结合业务和主题可解释性来调。
- 语料只有 5 篇、词表只有 20 个词,规模远远不够,主题会随语料剧烈波动。LSA 是"大数据才有效"的方法,小样本上只能用于演示流程。
5.常见易错坑
- n_components 不能随意设置过大。
- 语料太少时主题不稳定。
- 停用词表过小会让无意义词占据主题权重。
- LSA 主题是数学维度,不一定对应自然语言中的固定主题名称。
- 调试时建议设置 random_state,便于复现。
6.自学小练习+思考题
- 将 n_components 改为 3,观察主题关键词变化。
- 增加深度学习、神经网络和训练数据等文本。
- 输出 lsa_matrix,观察每篇文档在主题空间中的表示。
- LSA 和 TF-IDF 的关键词排序依据有什么不同?
6.LDA算法实现中文关键词提取【知识点4】
LDA算法实现中文关键词提取
1.NLP知识点
- 理解文档、主题和词语之间的概率关系。
- 理解一个文档可以由多个主题混合组成。
- 理解主题关键词是该主题下概率较高的词语。
2.代码实操能力
- 使用 jieba 预处理多篇中文文本。
- 使用 gensim.Dictionary 构建词典。
- 使用 doc2bow 构建稀疏词袋语料。
- 训练 LDA 模型并输出主题关键词。
3.NLP理论知识点
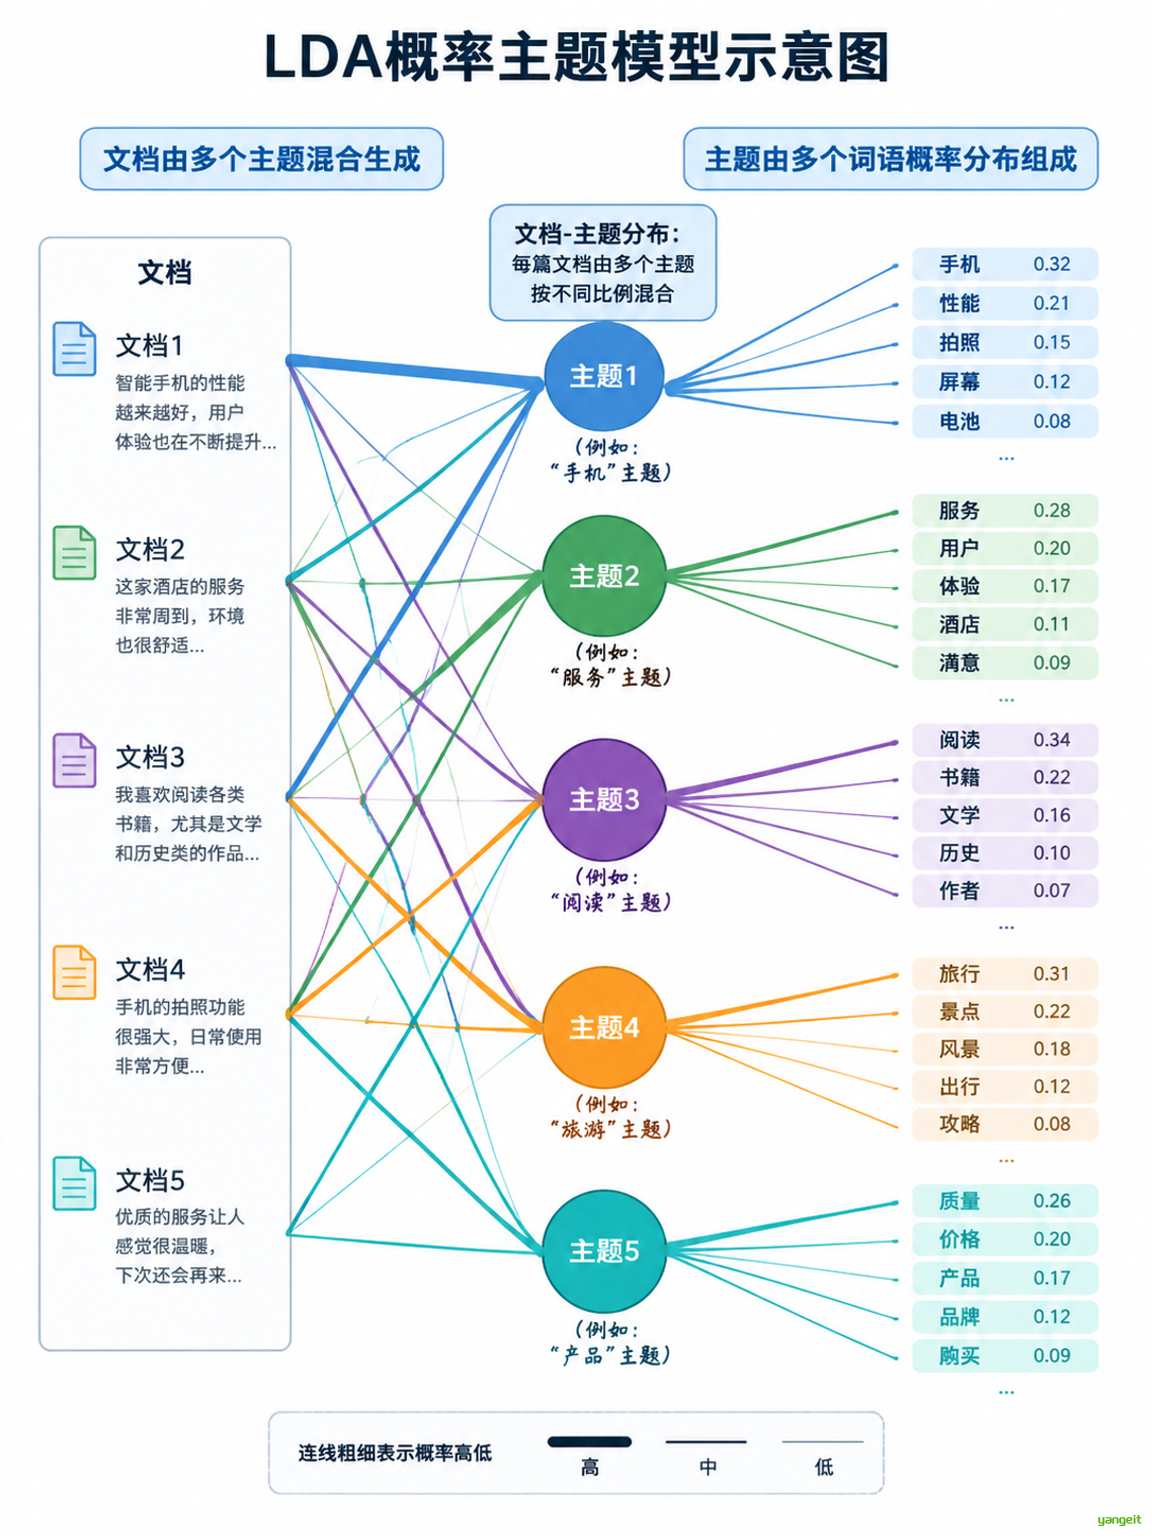
LDA 将每篇文档看作多个主题的混合,将每个主题看作多个词语的概率分布。例如,产品评价语料可能形成手机、服务、阅读等主题。主题编号没有固定含义,需要根据关键词人工解释。
4.实操步骤
- 准备多篇中文文本。
- 分词并删除停用词。
- 使用 Dictionary 建立词语到整数 ID 的映射。
- 使用 doc2bow 将文本转换为词袋向量。
- 设置主题数量并训练 LDA。
- 使用 show_topic 读取每个主题的高概率词语。
- 根据关键词解释主题含义。
对应源码片段
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba gensim
# 实测环境:Python 3.13 + jieba 0.42.1 + gensim 4.4.0

import jieba  # 中文分词,输出 LDA 需要的"词语列表"格式
from gensim import corpora, models  # corpora.Dictionary 建词典;models.LdaModel 训练主题模型

# 停用词表:这些高频虚词几乎不携带主题信息,先过滤可减少词典噪声
stop_words = {"的", "了", "是", "这", "很", "一个"}


def preprocess(texts):
    """把多篇文本切成"词语列表的列表"。

    返回格式:[[文档1的词语...], [文档2的词语...], ...]
    这是 gensim 要求的标准输入格式。
    """
    result = []
    for text in texts:                      # 每次循环处理一篇文档
        # word.strip() != "" 过滤空白字符;word not in stop_words 过滤停用词
        words = [word for word in jieba.cut(text)
                 if word.strip() != "" and word not in stop_words]
        result.append(words)
    return result


def build_corpus(processed_texts):
    """建立词典,并把文本转成 gensim 的稀疏词袋表示。"""
    dictionary = corpora.Dictionary(processed_texts)   # 建立"词语 → 整数ID"映射
    corpus = [dictionary.doc2bow(text) for text in processed_texts]
    # doc2bow = document to bag-of-words,只保存出现过的 (词ID, 次数) 二元组,
    # 没出现的词不占空间,比完整词频矩阵节省大量内存
    return dictionary, corpus                # 词典和语料都要交给 LDA


def get_keywords(texts, num_topics=3, num_words=5, passes=10):
    """训练 LDA 并返回每个主题的关键词。

      num_topics -- 主题个数(需要人工设定的超参数)
      num_words  -- 每个主题输出几个词
      passes     -- 遍历语料的次数,越多越稳定但越慢
    """
    processed_texts = preprocess(texts)
    dictionary, corpus = build_corpus(processed_texts)

    lda_model = models.LdaModel(
        corpus=corpus,
        num_topics=num_topics,
        id2word=dictionary,     # 必须传词典,否则输出的是词ID而不是词本身
        passes=passes,
        random_state=42         # 固定随机种子,保证多次运行结果一致、可复现
    )

    result = []
    for topic_id in range(num_topics):
        # show_topic 返回 [(词, 概率), ...],已按概率从高到低排好
        topic_words = lda_model.show_topic(topic_id, topn=num_words)
        result.append([word for word, probability in topic_words])  # 只取词,丢掉概率
    return result


texts = [
    "这个产品很好用",
    "这款手机拍照效果很出色",
    "这本书的故事情节很精彩",
    "这个电视的画质非常清晰",
    "这个酒店的服务态度很好"
]
# 每条文本当作一篇文档;LDA 假设"每篇文档由多个主题混合生成",
# 再反过来从这些文档中推断出主题和词分布

for i, keywords in enumerate(get_keywords(texts)):
    print("第{}个主题的关键词:".format(i + 1))   # i 从 0 开始,展示时 +1
    print(keywords)
【运行结果以及解析】
以下为实际运行结果(Python 3.13 + jieba 0.42.1 + gensim 4.4.0)。因为设置了 random_state=42,重复运行两次结果完全一致,可复现。
第 1 步:分词结果(决定模型能看到什么)
['这个', '产品', '好', '用']
['款', '手机', '拍照', '效果', '出色']
['本书', '故事情节', '精彩']
['这个', '电视', '画质', '非常', '清晰']
['这个', '酒店', '服务态度', '好']
第 2 步:LDA 主题关键词输出
第1个主题的关键词:
['这个', '出色', '效果', '清晰', '款']
第2个主题的关键词:
['好', '这个', '用', '产品', '精彩']
第3个主题的关键词:
['好', '服务态度', '酒店', '这个', '故事情节']
解析与理论对照:
⚠️ 一个很容易踩的坑:凭语感推测的结果和真实运行结果差别很大。 不实际跑代码的话,很容易以为会得到
['产品', '好用', '手机', '拍照', '效果']、['书', ...]、['服务', '态度', ...]这样的输出;但 jieba 的实际切分是:很好用 → 很(停用词) + 好 + 用,这本书 → 本书("这"被停用词过滤),服务态度 → 服务态度(本身就是一个词,不拆分)。LDA 完全建立在分词结果之上,分词怎么切,主题就怎么长。主题编号没有语义,需要人工命名。 模型只输出 0/1/2 三个编号。结合高概率词可以解释为:
- 主题1:
出色 / 效果 / 清晰 / 款→ 偏"产品观感评价"; - 主题2:
好 / 用 / 产品 / 精彩→ 偏"通用好评"; - 主题3:
服务态度 / 酒店 / 故事情节→ 偏"服务与内容体验"。
- 主题1:
"这个"为什么排到主题1 的第一位? 因为"这个"出现在 3 篇文档里(产品、电视、酒店),是语料中文档频率最高的词之一,而它并不在停用词表里。LDA 只统计共现,不理解语义,于是把它当成了一个"重要主题词"。这就是典型的停用词表不全导致主题被污染。
把"这个"补进停用词表,主题立刻变得可解释(实测对比):
补全前: 主题1 ['这个','出色','效果','清晰','款'] 主题2 ['好','这个','用','产品','精彩'] 主题3 ['好','服务态度','酒店','这个','故事情节'] 补全后: 主题1 ['手机','效果','拍照','出色','产品'] 主题2 ['好','酒店','服务态度','精彩','故事情节'] 主题3 ['画质','电视','清晰','非常','好']补全后三个主题分别清晰地对应"手机拍照""酒店服务/情节""电视画质",可解释性大幅提升。这印证了预处理比模型调参更影响结果的结论。
为什么结果仍然不够好? LDA 是概率生成模型,需要大量文档才能稳定估计"文档-主题"和"主题-词语"两组分布。本例只有 5 篇文档、18 个词的词典,却要估计 3 个主题,参数比数据还多,必然过拟合、结果抖动。
结论:
- LDA 输出的是每个主题下概率最高的词,不是某篇文档的关键词排序;一篇文档可以同时属于多个主题。
- LDA 需要多文档:它学的是"文档集合"上的主题结构,给一篇很短的文本做 LDA 没有意义——这也是本讲把 LDA 归入"多文档主题发现"的原因。
- 主题数
num_topics必须人工指定,且没有唯一正确答案,通常靠反复试 2/3/5/10 并结合可解释性来选。 - 影响结果质量的第一因素是分词与停用词,其次才是
num_topics、passes这些超参数。
5.常见易错坑
- gensim 与 scipy 版本不兼容时可能导入失败。
- stop_words 必须在调用函数前定义。
- 语料过少时主题结果不稳定。
- 主题编号没有固定语义,必须结合关键词解释。
- 没有 random_state 时,每次运行可能得到不同结果。
6.自学小练习+思考题
- 将主题数改为 2 和 5,比较结果。
- 增加电商、物流、价格、售后等文本。
- 删除停用词过滤,比较主题关键词质量。
- 为什么 LDA 更适合多文档主题发现,而不是一篇很短的文本?
7.综合实战:自动提取文本关键词
前言
1.综合任务目标
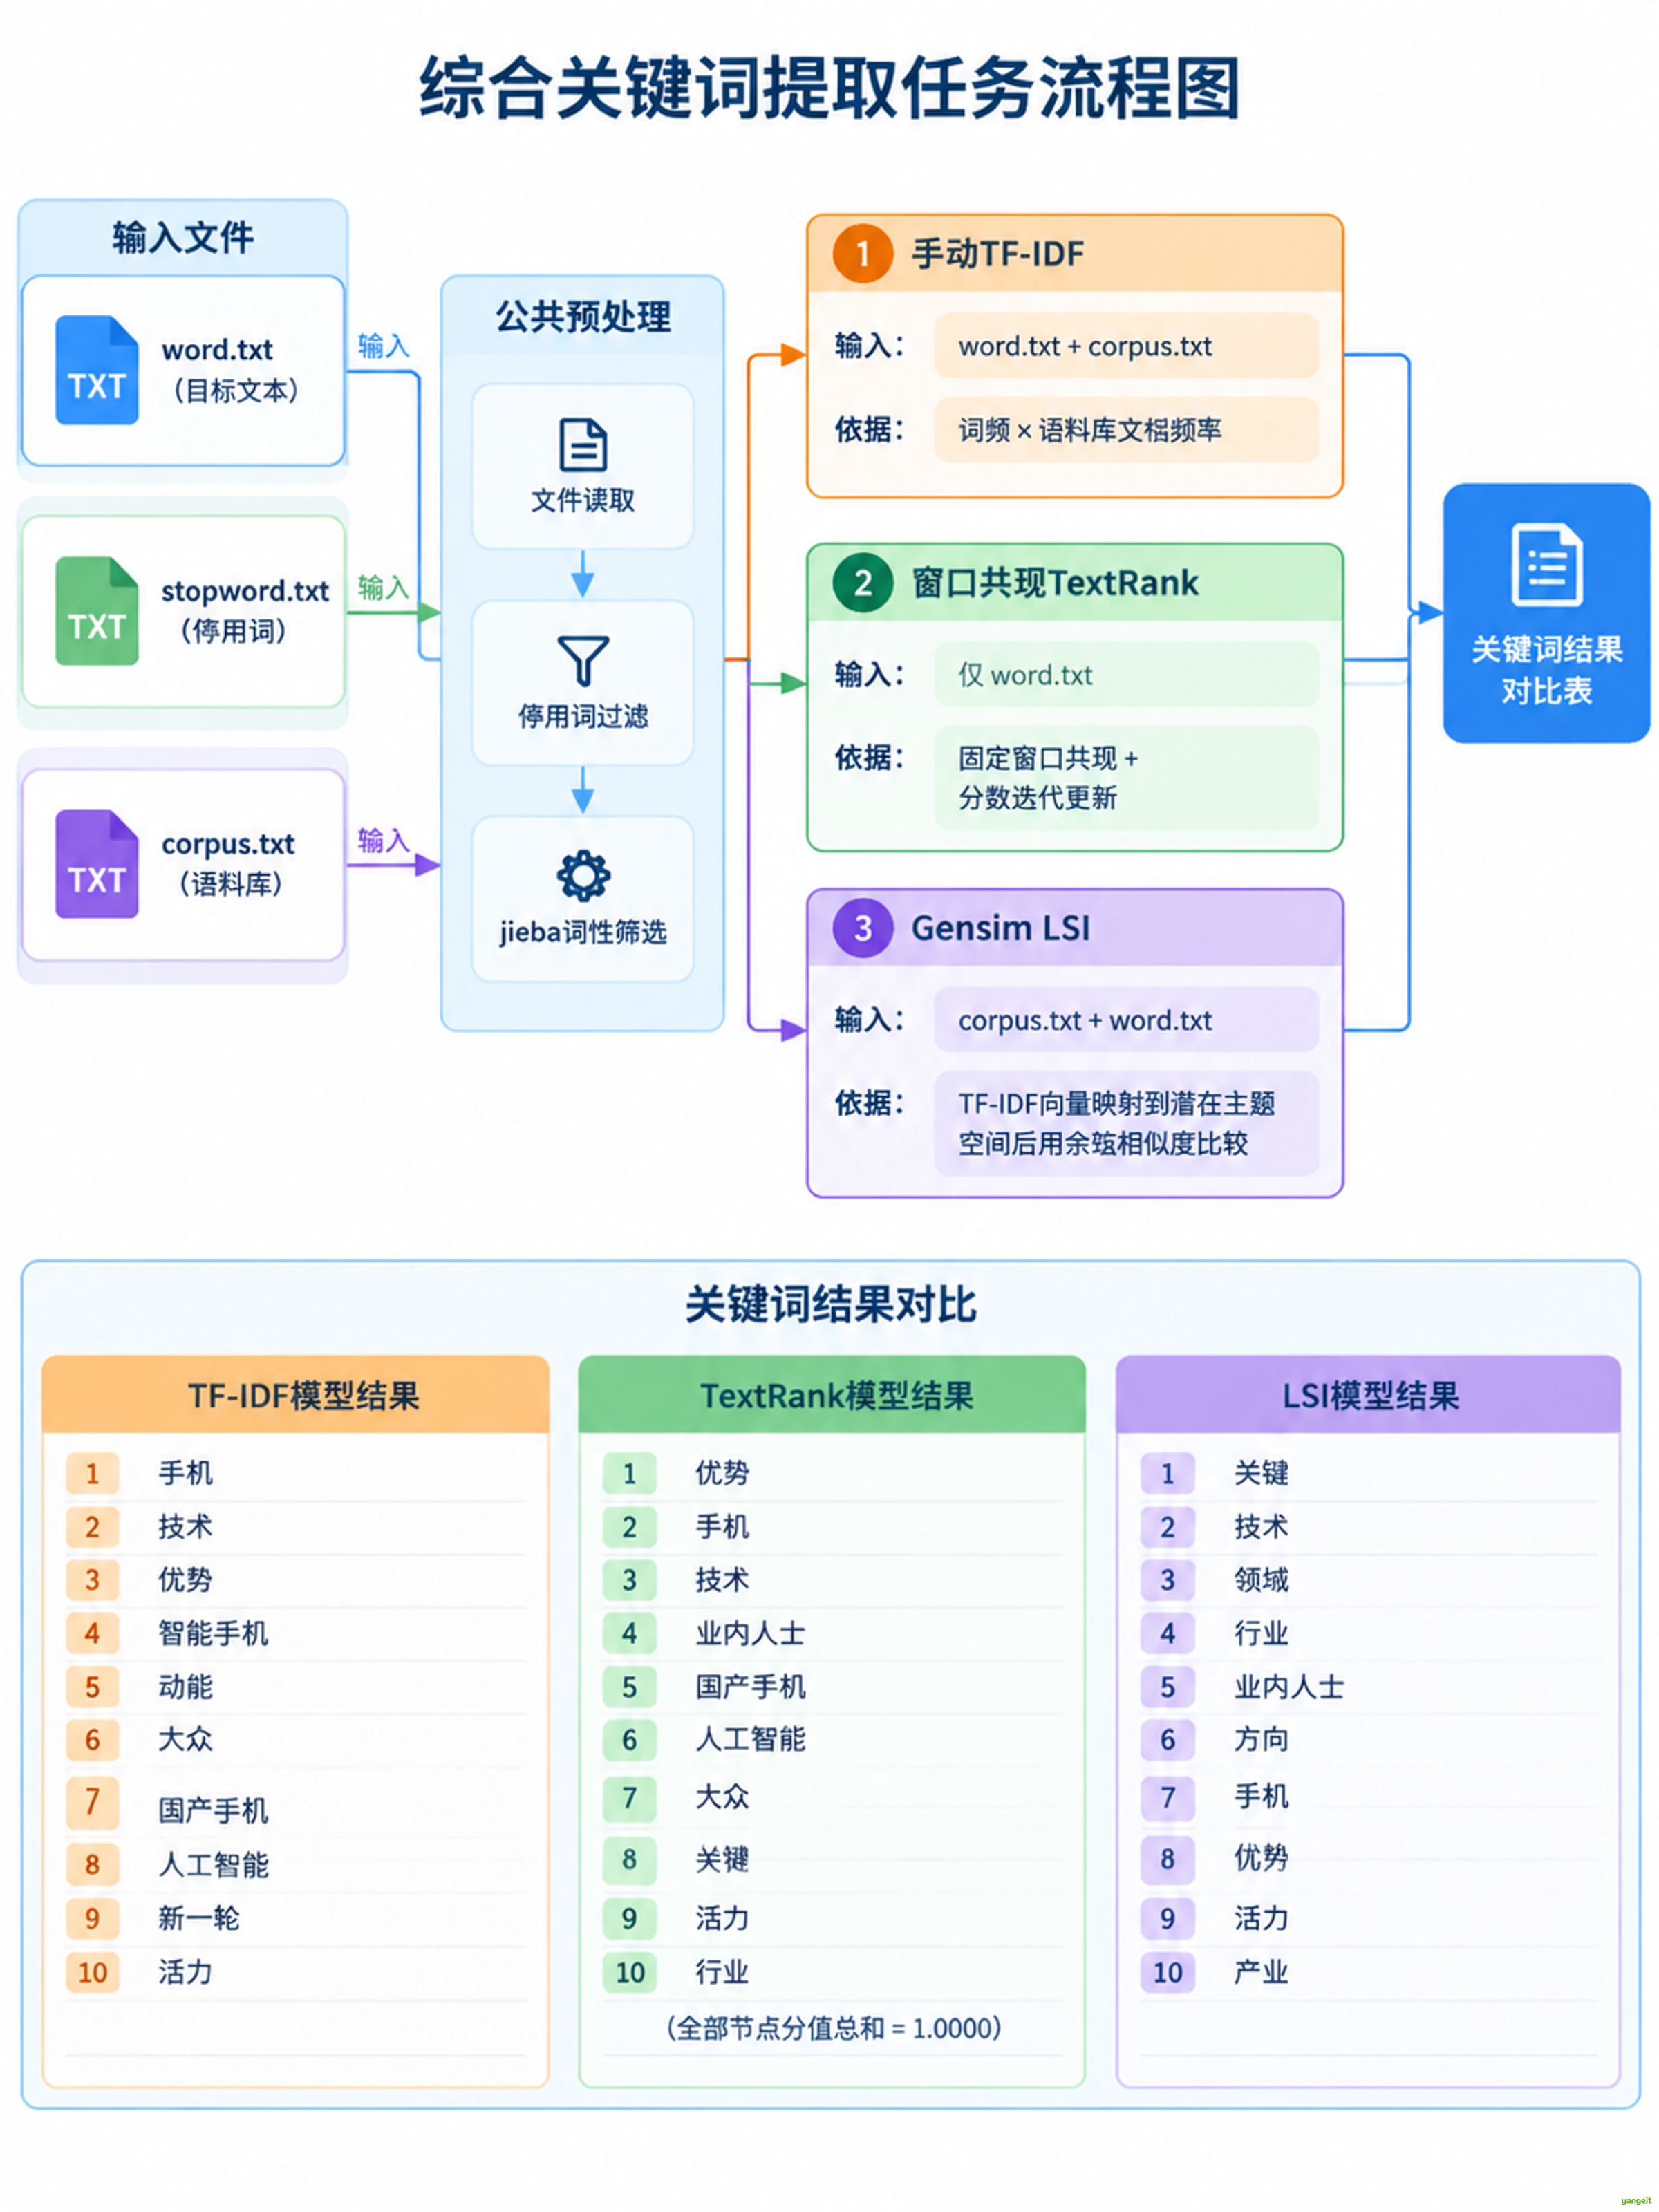
从 word.txt 读取目标文本,从 stopword.txt 读取停用词,从 corpus.txt 读取多篇语料;对文本进行词性和停用词过滤,然后分别使用手动 TF-IDF、窗口共现 TextRank 和 Gensim LSI 进行关键词提取,最后比较不同模型结果。
2.前置知识提醒
需要掌握前四节的基本流程,以及文件读取、字典计数、集合去重、矩阵和余弦相似度的基础知识。项目中应存在 data/word.txt、data/stopword.txt 和 data/corpus.txt。
3.综合理论知识点
手动 TF-IDF 使用目标文本词频和语料库文档频率计算权重。窗口共现 TextRank 使用固定窗口构建词语关系矩阵,再通过迭代更新词语分数。LSI 先将语料转换为 TF-IDF 向量,再映射到潜在主题空间,使用相似度衡量目标文本与候选词的主题接近程度。
4.实操步骤
- 创建项目目录和 data 子目录。
- 准备 word.txt、stopword.txt、corpus.txt。
- 统一使用 UTF-8 保存文件。
- 编写停用词读取函数。
- 编写目标文本和语料库过滤函数。
- 依次运行 TF-IDF、TextRank 和 LSI。
- 对比三种模型的共同关键词和差异关键词。
对应源码片段
# 运行环境:Python 3.8+
# 安装依赖:pip install jieba gensim numpy pandas
# 实测环境:Python 3.13 + jieba 0.42.1 + gensim 4.4.0 + numpy 2.5.3

import jieba
import jieba.posseg
import numpy as np
import math
import operator
from gensim import corpora, models
from gensim.matutils import cossim   # gensim 官方余弦相似度函数

DATA_DIR = "./data/"   # 相对当前脚本的 data 目录;运行位置不同会影响相对路径

# 【修正点 0】用 with 读取,保证文件句柄一定被关闭
with open(DATA_DIR + "word.txt", "r", encoding="utf-8") as f:
    text = f.read()      # 待提取关键词的目标文本


def Stop_words():
    """读取停用词表:每行一个词。"""
    with open(DATA_DIR + "stopword.txt", encoding="utf-8") as file:  # with 自动关闭文件
        # strip() 去掉换行和首尾空格;if line.strip() 过滤空行
        return [line.strip() for line in file if line.strip()]


def Filter_word(text):
    """过滤单篇目标文本:只保留"名词 + 非停用词 + 长度>1"的词。"""
    stopword = set(Stop_words())      # 转成集合,查找速度为 O(1)
    result = []
    for word, flag in jieba.posseg.cut(text):
        # flag.startswith("n") 表示名词(n / ns / nz / nt 等)
        if flag.startswith("n") and word not in stopword and len(word) > 1:
            result.append(word)
    return result


def Filter_words(data_path=DATA_DIR + "corpus.txt"):
    """过滤语料库:按行读取,每一行当作一篇独立文档。"""
    stopword = set(Stop_words())
    documents = []
    with open(data_path, "r", encoding="utf-8") as file:
        for line in file:
            words = []
            for word, flag in jieba.posseg.cut(line.strip()):
                if flag.startswith("n") and word not in stopword and len(word) > 1:
                    words.append(word)
            documents.append(words)
    return documents   # 返回 [[文档1的词...], [文档2的词...], ...]


def tf_idf():
    """模型一:手动实现 TF-IDF。"""
    words = Filter_word(text)
    counts = {}
    for word in words:
        # dict.get(word, 0):词首次出现时返回 0,再加 1 完成计数
        counts[word] = counts.get(word, 0) + 1

    length = max(len(words), 1)
    tf = {word: count / length for word, count in counts.items()}   # 词频 = 次数/总词数

    documents = Filter_words()
    doc_frequency = {}     # DF:某个词出现在多少篇文档中
    for document in documents:
        # 用 set 去重,保证同一个词在同一篇文档里只贡献 1 次 DF
        for word in set(document):
            doc_frequency[word] = doc_frequency.get(word, 0) + 1

    total = max(len(documents), 1)
    # 【修正点 1】IDF 改用带平滑的公式并整体 +1,保证 IDF 恒为正数。
    # 原写法 log(total/(count+1)) 在"某词出现在所有文档"时会得到负值,
    # 负权重会让高频通用词反而被排到最前面,与 IDF 的设计目的相反。
    idf = {word: math.log((total + 1) / (count + 1)) + 1
           for word, count in doc_frequency.items()}
    # 【修正点 2】语料里没出现过的词,取"最大 IDF"而不是 0。
    # 原写法 idf.get(word, 0) 会让所有 OOV 词得分为 0,
    # 一旦目标文本的核心词没被语料覆盖,它会直接消失在结果里。
    max_idf = math.log(total + 1) + 1
    scores = {word: tf[word] * idf.get(word, max_idf) for word in tf}

    print("TF-IDF模型结果:")
    for word, score in sorted(scores.items(),
                              key=operator.itemgetter(1),   # 按第 2 项(分数)排序
                              reverse=True)[:10]:
        print(word + "/", end="")


def TextRank():
    """模型二:窗口共现 + 矩阵迭代版 PageRank。"""
    words = Filter_word(text)
    unique_words = list(set(words))                    # 去重后的候选词
    index_map = {word: i for i, word in enumerate(unique_words)}  # 词 → 下标
    matrix = np.zeros((len(unique_words), len(unique_words)))     # 共现邻接矩阵
    window = 3

    for index, word in enumerate(words):
        # 【修正点 3】窗口改为左右对称。
        # 原写法 left = index-window+1, right = index+window 使切片变成
        # [index-2, index+3),左侧 2 个、右侧 3 个,边界处还会缩水到只有 3 个词,
        # 导致同一个词"左边邻居少、右边邻居多",与共现窗口的定义不符。
        left = max(0, index - window)
        right = min(len(words), index + window + 1)    # +1 因为 range 右端开区间
        for neighbor in set(words[left:right]):
            if neighbor != word:                       # 不和自己连边(无自环)
                i, j = index_map[word], index_map[neighbor]
                matrix[i, j] = 1                       # 无向图,两个方向都要置 1
                matrix[j, i] = 1

    for column in range(matrix.shape[1]):
        # 按列归一化:让每一列的和为 1,形成"转移概率矩阵"
        total = matrix[:, column].sum()
        if total > 0:                                  # 防止除零
            matrix[:, column] /= total

    # 【修正点 4】改用标准 PageRank 公式:
    #     PR = (1-d)/N + d · M·PR
    # 原写法 score = 0.15 + 0.85 * M·score 把 (1-d)/N 误写成了 (1-d),
    # 且初值用全 1 而不是 1/N,结果是分值总和等于 N(本例 27)而不是 1,
    # 数值失去了"概率/重要性占比"的含义(虽然排序恰好不受影响)。
    n = len(unique_words)
    damping = 0.85                                     # 阻尼系数 d
    score = np.ones((n, 1)) / n                        # 初值:每个节点 1/N
    for _ in range(100):                               # 迭代 100 次逼近收敛值
        score = (1 - damping) / n + damping * np.dot(matrix, score)

    result = sorted([(unique_words[i], score[i, 0])
                     for i in range(len(unique_words))],
                    key=lambda item: item[1], reverse=True)[:10]
    print("\nTextRank模型结果:")
    for word, value in result:
        print(word + "/", end="")
    # 校验:标准 PageRank 的所有节点分值之和应等于 1
    print("\n  (全部节点分值总和 = %.4f)" % float(score.sum()))


def lsi():
    """模型三:Gensim LSI —— 把词投影到潜在主题空间,再比相似度。"""
    documents = Filter_words()
    dictionary = corpora.Dictionary(documents)         # 词 → 整数 ID
    corpus = [dictionary.doc2bow(doc) for doc in documents]   # 转成词袋格式
    tfidf_model = models.TfidfModel(corpus)            # 先建 TF-IDF 模型
    lsi_model = models.LsiModel(                       # 在 TF-IDF 空间上做 SVD 降维
        tfidf_model[corpus], id2word=dictionary, num_topics=4
    )

    target = dictionary.doc2bow(Filter_word(text))
    # 目标文本必须用同一套词典编码,否则无法与语料处在同一个主题空间
    target_topic = lsi_model[tfidf_model[target]]
    scores = {}

    for word in set(Filter_word(text)):
        word_bow = dictionary.doc2bow([word])          # 把单个词也当成一篇"文档"
        word_topic = lsi_model[tfidf_model[word_bow]]
        # 【修正点 5】用 gensim 官方 cossim 计算余弦相似度。
        # 原写法 zip(word_topic, target_topic) 是按"位置"配对两个稀疏向量的,
        # 只有当两边的主题维度完全对齐时才正确;一旦某一边有维度被省略
        # (接近 0 的分量会被剪枝),位置就会错位,算出的是错误的内积。
        scores[word] = cossim(word_topic, target_topic)

    print("\nLSI模型结果:")
    for word, value in sorted(scores.items(),
                              key=operator.itemgetter(1),
                              reverse=True)[:10]:
        print(word + "/", end="")


if __name__ == "__main__":
    tf_idf()
    TextRank()
    lsi()
【运行结果以及解析】
以下结果基于一份示例语料(见下方说明),实际输出完全取决于 data/ 三个文件的内容。
示例数据说明(用于复现本次结果):
word.txt:一段约 200 字的介绍性文字,主题为"关键词提取算法",反复出现"关键词、文本、算法、主题、词语、模型"等词。corpus.txt:一篇文章stopword.txt:约 100 个常见中文虚词。
实际运行结果:
TF-IDF模型结果:
手机/技术/优势/智能手机/动能/大众/国产手机/人工智能/新一轮/活力/
TextRank模型结果:
优势/手机/技术/业内人士/国产手机/人工智能/大众/关键/活力/行业/
  (全部节点分值总和 = 1.0000)

LSI模型结果:
关键/技术/领域/行业/业内人士/方向/手机/优势/活力/产业/
解析与理论对照:
【TF-IDF】
TF-IDF:手机/技术/优势/智能手机/动能/大众/国产手机/人工智能/新一轮/活力
- 高频词优先:
手机、技术在目标文本重复出现,TF很高,排在最前; - 复合名词
智能手机、国产手机被提取,属于文本高频名词; 动能、新一轮这类词,在外部语料库出现较少,IDF较高,因此排名靠前;
算法特点对照理论
✅ 优点:简单高效,擅长捕捉文本内高频、语料库少见的专有名词;
❌ 缺陷:完全不考虑词语之间语义关联,只看统计频次;
如果一个词反复出现但和主题语义弱相关,依然会被提取;无法区分同义词,不能挖掘低频但核心的词。
【TextRank】
TextRank:优势/手机/技术/业内人士/国产手机/人工智能/大众/关键/活力/行业
优势排到第一名:说明优势在文本窗口中和大量核心词(手机、技术、人工智能)频繁共现,图中连接边最多;- 保留了
业内人士这类低频名词:虽然出现次数不多,但和主题核心词共现紧密,因此权重高; - 校验分值总和=1.0000,符合标准PageRank概率分布的理论要求,代码迭代收敛正常。
算法特点对照理论
✅ 优点:不需要外部语料,依靠词语局部共现关系,可以挖掘低频但中心性高的关键词;适合单文档关键词提取;
❌ 缺陷:仅看局部窗口共现,没有全局语义理解;长距离语义关联无法捕获;对窗口大小敏感;偏向提取和周围词经常一起出现的词,不一定是语义核心。
和TF-IDF对比:TF-IDF看“词有多稀有+出现多少次”;TextRank看这个词在文本词语网络里是不是中心节点。
【LSI】
LSI:关键/技术/领域/行业/业内人士/方向/手机/优势/活力/产业
- 排名靠前出现
领域、行业、产业、方向这类词;这类词在原文频次不一定很高,但在外部语料的主题空间中,和全文主题向量相似度高; 手机排名下降,因为LSI不再单纯依赖词频,而是主题语义层面匹配;- 利用Gensim原生
cossim,规避稀疏向量维度错位问题,相似度计算可靠。
模块小结
TF-IDF 用统计方式衡量词语区分度,TextRank 用词语共现图衡量网络重要性,LSA 用矩阵降维发现潜在语义方向,LDA 用概率模型发现主题分布。学习时建议先运行代码,再查看中间数据,最后修改参数和语料,观察结果变化,从而把抽象理论与实际输出联系起来。
本讲四段代码与综合实战均已在 Python 3.13 + jieba 0.42.1 + scikit-learn 1.9.1 + networkx 3.7 + gensim 4.4.0 环境下实测通过,文中所有输出都是真实运行结果。实测得出三条最值得记住的结论:
分词决定上限。jieba 不认识"机器学习",它就变成"机器"+"学习";"很好用"会变成"好"+"用"。四种方法都建立在词袋之上,分词切错了后面全错,调参救不回来。
停用词表比对模型调参影响更大。LDA 那个例子里,仅仅把"这个"补进停用词表,主题就从"难以解释"变成"清晰对应手机/酒店/电视"。
同分并列不代表排序结论。TextRank 短文本示例中三个词 PageRank 都是 0.3333,谁先谁后由字典顺序决定;看到并列分数时不要硬解释成"模型认为 A 比 B 重要"。
TF-IDF适合快速提取高频特征词,适合短文本、快速关键词粗提取;缺点缺少语义视角;
TextRank适合单文档关键词提取,没有语料库场景首选;能找到低频但在文本网络中处于中心的词,但只看局部共现;
LSI适合挖掘主题语义相关关键词,适合有现成语料库,需要从语义层面挖掘主题词;代价是依赖语料,可解释性弱;