第5章 词性标注与命名实体识别
第5章 词性标注与命名实体识别
学完本讲,你应该能够:
知识目标
- 了解词性标注(POS Tagging)和命名实体识别(NER)的定义、价值与标签体系。
- 理解序列标注任务的统一形式:输入等长序列,输出等长标签序列。
- 掌握 HMM + Viterbi 在序列标注中的作用,理解马尔可夫假设的局限。
- 理解 CRF 的特征工程与全局解码机制,以及它相对 HMM 的改进。
- 了解 BiLSTM 等深度学习方法,以及本任务向预训练模型演进的脉络。
能力目标
- 能用 jieba 快速完成中文分词 + 词性标注,并解释常见词性标签含义。
- 能用 HMM + Viterbi 实现一个可运行的词性标注器。
- 能独立编写词级与字符级的 BIO 特征提取函数。
- 能完成"语料读取 → 标签转换 → 特征工程 → 模型训练 → 实体级评估 → 模型保存与预测"的完整 NER 流程。
- 能说清字符级指标与实体级指标的区别,避免误判模型效果。
先修知识:分词基础(第4讲)、条件概率与马尔可夫链、PyTorch 基础。
1:序列标注任务与词性标注
前言
1 概念与难点
同一句"我不喜欢这部电影",如果系统知道"我"是代词、"喜欢"是动词、"这部"是量词、"电影"是名词,就能判断出这是否定评价;
如果还知道"这部电影"是一个作品实体,就能把它和数据库中 5 万部电影对上号。
词性标注和命名实体识别做的就是这件事。
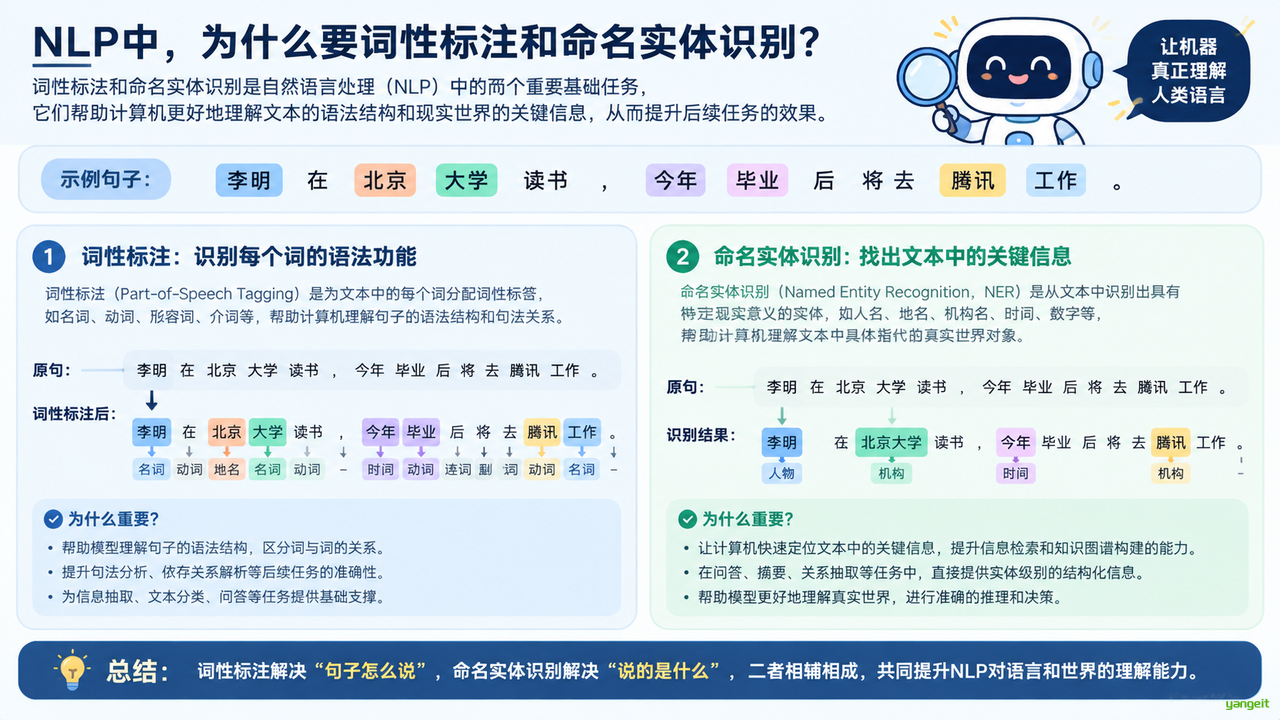
定义:
- 词性标注(Part-of-Speech Tagging, POS):给句子中每个词标注语法类别(名词/动词/形容词...)。
- 命名实体识别(Named Entity Recognition, NER):识别文本中的专名实体(人名/地名/机构名/时间...)并标注其类别与边界。
二者的共同本质:都是序列标注任务 —— 输入是一串词(或字),输出是与之等长的一串标签。
序列标注:输入序列与输出序列一一对应的分类问题。
["我","喜欢","这","电影"]→["r","v","r","n"]。
理解这一点,本章所有方法就统一起来了。
词性标签集(ICTCLAS体系,jieba 采用):
| 标签 | 全称 | 例词 |
|---|---|---|
n | 名词 noun | 电影、餐厅 |
v | 动词 verb | 喜欢、看 |
a | 形容词 adjective | 精彩、好吃 |
ad | 副词 adverb | 很、非常 |
d | 副词 adverb | 非常、十分 |
r | 代词 pronoun | 我、你 |
p | 介词 preposition | 在、从 |
c | 连词 conjunction | 和、但是 |
uj / u | 助词 particle | 的、了、着 |
m | 数词 numeral | 三、5 |
q | 量词 classifier | 部、个 |
t | 时间词 time | 今天、明年 |
f | 方位词 | 上、下、内 |
x | 非语素字 | 标点符号、空格 |
ns | 地名词 place name | 北京、杭州 |
nr | 人名词 person name | 张三、李四 |
nt | 机构名词 organization | 清华大学 |
nz | 其他专名 | 楚留香 |
注意最后四个带
n的:它们既是词性,也是 NER 的标签来源(Named Entity Recognition(命名实体识别))。
为什么词性标签集里会有人名地名? 因为 ICTCLAS 语料库当年就是为"中国人名地名机构名识别"建的(哈工大/中科院),jieba 的 dict.txt 继承了这份词表。这是历史遗留,不是巧合。
词性标注的核心难点:词性具有强上下文依赖性。"研究"既可能是名词(这项研究)也可能是动词(研究问题),不能只靠词典决定,必须看它在句子中的位置。
NER 的标签体系(BIO):
| 标签 | 含义 |
|---|---|
B-TYPE | 实体起始(Begin) |
I-TYPE | 实体内部(Inside) |
O | 非实体(Outside) |
S-TYPE | 单字实体(Single,可选) |
例如: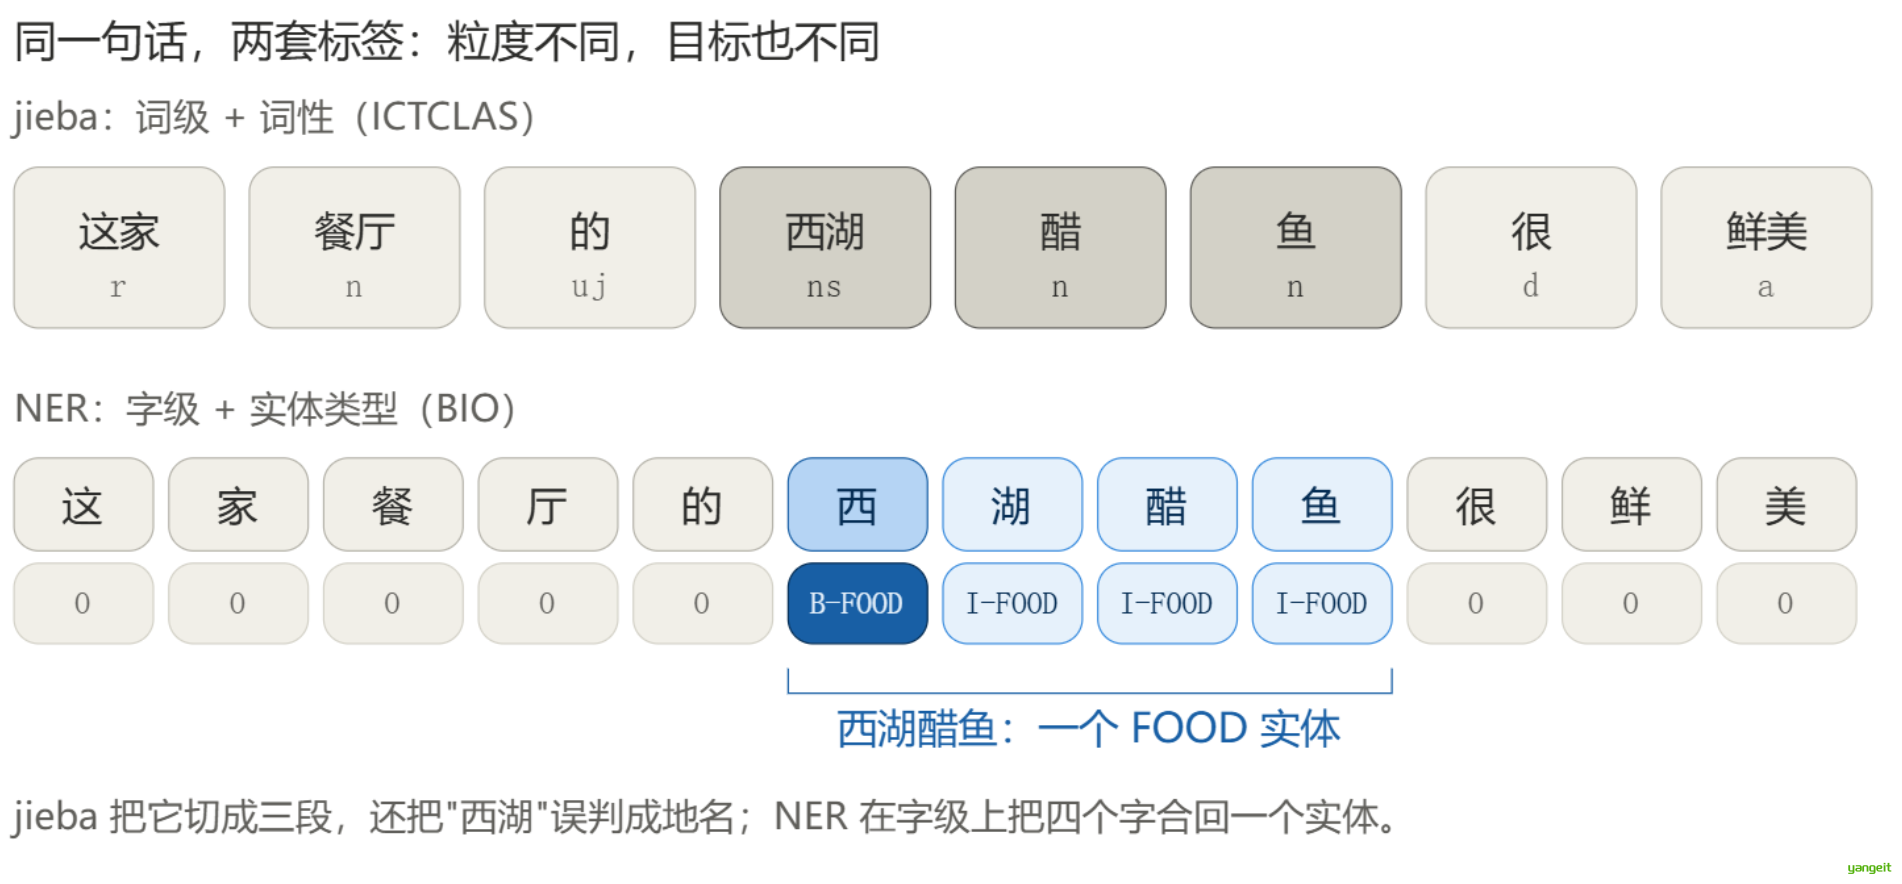
中文 NER 的四个主要难点:
- 边界不明确:"南京市长江大桥"里"南京"是否算地名?
- 嵌套实体:"中国银行北京分行"里同时有 ORG("中国银行北京分行") 和嵌套的 LOC("北京")。传统 BIO 无法表达。
- 类型依赖上下文:"小米"是公司还是粮食?看上下文。
- 领域迁移:在医疗文本里训练的模型,直接用于法律文本效果会大幅下降。
2 代码实操
业务场景:用 jieba 对"我爱北京天安门"做词性标注,并统计高频词性分布。
# ========== jieba 词性标注 ==========
import jieba.posseg as pseg
from collections import Counter

text = "我爱北京天安门"

# pseg.cut 一次完成分词 + 词性标注,返回 (词语, 词性) 对
print("=== 逐词标注 ===")
for word, flag in pseg.cut(text):
    print(f"{word}\t{flag}")

# 统计词性分布,看文本以什么成分为主
print("\n=== 词性分布 ===")
flags = [flag for _, flag in pseg.cut(text)]
for flag, cnt in Counter(flags).most_common():
print(f"{flag}\t{cnt}")运行结果:
=== 逐词标注 ===
我	r
爱	v
北京	ns
天安门	ns

=== 词性分布 ===
ns	2
r	1
v 1结果分析:
- "北京"和"天安门"都被标为
ns(地名词)—— 这正是 NER 的原料:把ns连续片段抽出来,就是地名实体。 - 词性标注的输出天然包含 NER 所需的信息。
- ⚠️ 但注意:"天安门"是建筑物,严格标注应是
nt(机构名词)或专名,不该是ns。这说明词典标注不可能 100% 准确,真实项目必须抽样评估。
易错点小结:
- jieba 词性结果依赖词典和版本:换 jieba 版本后结果可能变化,评估结果时必须记录版本号。
- 自定义词典只改分词不改词性:
jieba.load_userdict()能让"西湖醋鱼"不被切碎,但它的词性仍由内置词典决定。 - 专业领域必须抽样评估:医疗、法律、金融文本的专有名词,jieba 词性错得很离谱,必须准备领域词典。
过渡
jieba 给了现成结果,但如果标签集要自己定、要控制模型行为,就得自己训模型。最直观的做法是把序列标注当成"求一条概率最大的标签路径",这正是 HMM 的解法。
2:HMM + Viterbi 词性标注
HMM 与维特比算法
1 概念与原理
引入:HMM 词性标注把词性当作隐藏状态,把词语当作观测。给定一句话的词语序列,问"哪条词性路径的概率最大"。
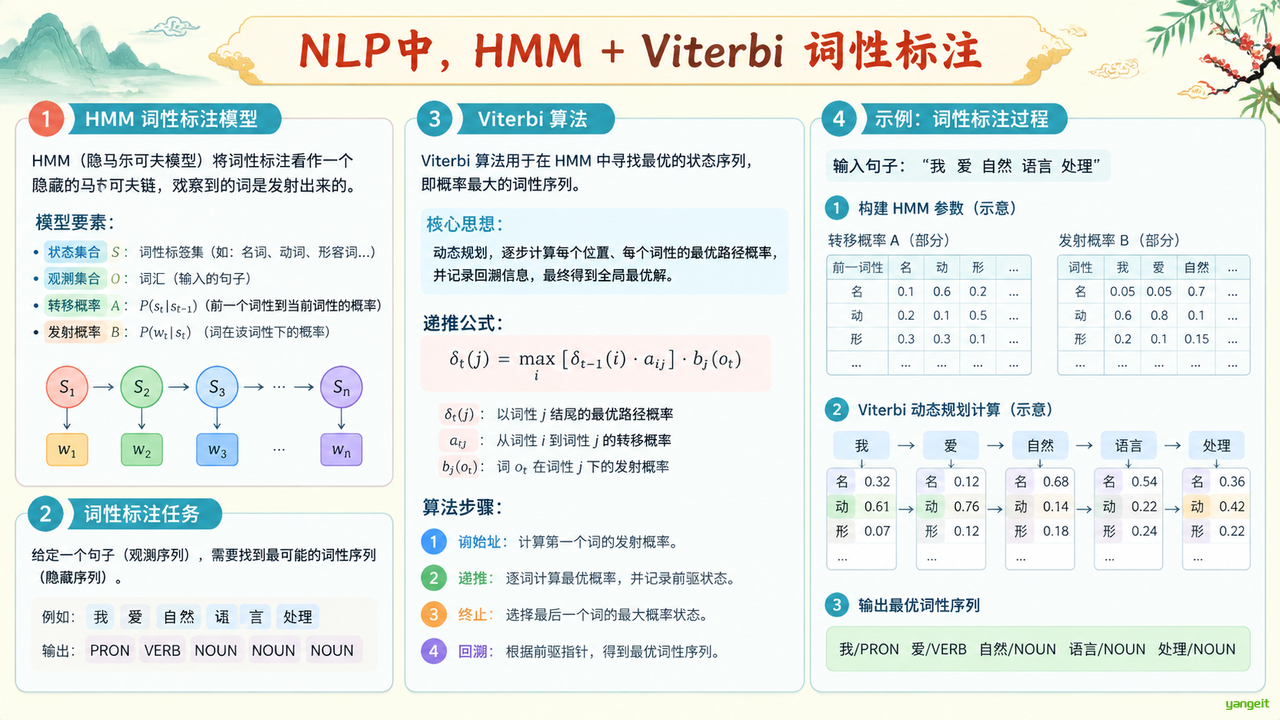
模型三要素:
| 要素 | 符号 | 在词性标注中的含义 |
|---|---|---|
| 初始概率 | 句首词是各词性的概率 | |
| 转移概率 | ,前一个词是名词时,当前词是动词的概率 | |
| 发射概率 | ,给定词性下出现某个词的概率 |
求解:
用 Viterbi 在 的 DP 表上求最大值,并记录前驱回溯路径。
生活类比:👇
像"根据菜名猜食材清单"。已知今天有几道菜(观测),每道菜由荤/素/汤分类(隐藏状态)。你要找出最合理的分类方案 —— 荤菜不会连着来三道,但"汤"后面接"汤"就有点怪。转移概率描述这种搭配的合理性,发射概率描述某道菜属于某类的可能性。
特点与局限:
| 优点 | 局限 |
|---|---|
| 只需极少量数据就能工作 | 一阶马尔可夫假设只能用前一个词 |
| 概率可列出,完全可解释 | 发射概率对未登录词为 0,整条路径概率归零 |
| 训练与推理都极快 | 词性之间的长程约束无法建模 |
2026 年的定位:HMM 分词/词性标注在生产中已经基本淘汰。但它没有死透 —— 在极低资源、需完全可解释的场景(如法律文书词性校验),仍有人用。教学价值 >> 实用价值。
2 代码实操
业务场景:给定手工构造的概率矩阵,用 Viterbi 标注"我 / 很 / 好"。
# ========== 代码 5-2 HMM 词性标注 ==========
import numpy as np

# ---- 词性集合:必须用有序列表,不能用 set ----
POS_LIST = ['n', 'v', 'a', 'd']    # 名词/动词/形容词/副词

# ---- 初始概率:句首词性的分布 ----
init_prob = {'n': 0.4, 'v': 0.3, 'a': 0.2, 'd': 0.1}

# ---- 转移概率:trans_prob[s1][s2] = P(s2|s1),每行和为 1 ----
# 如 'n' 后跟 'v' 概率 0.5("研究问题"这种名词+动词搭配常见)
trans_prob = {
    'n': {'n': 0.2, 'v': 0.5, 'a': 0.2, 'd': 0.1},
    'v': {'n': 0.3, 'v': 0.1, 'a': 0.3, 'd': 0.3},
    'a': {'n': 0.3, 'v': 0.4, 'a': 0.1, 'd': 0.2},
    'd': {'n': 0.1, 'v': 0.1, 'a': 0.4, 'd': 0.4},
}

# ---- 发射概率:emit_prob[s][w] = P(w|s) ----
# ⚠️ 每行只列了部分词的和,所以不等于 1;这是简化演示
emit_prob = {
    'n': {'我': 0.4, '你': 0.3, '他': 0.3},
    'v': {'吃': 0.4, '喝': 0.3, '走': 0.3},
    'a': {'好': 0.5, '高': 0.4, '快': 0.1},
    'd': {'很': 0.7, '非常': 0.2, '太': 0.1},
}

def viterbi(obs_seq, pos_list, init_prob, trans_prob, emit_prob):
    """
    维特比算法:给定观测序列,求最可能的词性路径
    obs_seq   : 词序列,如 ['我','很','好']
    pos_list  : 词性列表(有序!索引与 DP 表的行一一对应)
    返回      : 与 obs_seq 等长的词性索引列表
    """
    n_tag = len(pos_list)
    T = len(obs_seq)
    # dp[i][t]:到时刻 t、词性为 pos_list[i] 时的最大概率
    dp = np.zeros((n_tag, T))
    # path[i][t]:最优路径上,时刻 t 处于 pos_list[i] 时的前驱词性索引
    path = np.zeros((n_tag, T), dtype=int)

    # 初始化 t=0
    for i, tag in enumerate(pos_list):
        dp[i][0] = init_prob[tag] * emit_prob[tag].get(obs_seq[0], 0.0)

    # 递推 t=1..T-1
    for t in range(1, T):
        for i, cur in enumerate(pos_list):
            best_prob, best_prev = -1.0, 0
            for j, prev in enumerate(pos_list):
                prob = (dp[j][t - 1]
                        * trans_prob[prev].get(cur, 0.0)
                        * emit_prob[cur].get(obs_seq[t], 0.0))
                if prob > best_prob:
                    best_prob, best_prev = prob, j
            dp[i][t] = best_prob
            path[i][t] = best_prev

    # 回溯:从概率最大的末步状态出发,沿 path 倒推
    last = int(np.argmax(dp[:, -1]))
    best_path = [last]
    for t in range(T - 1, 0, -1):
        last = path[last][t]
        best_path.append(last)
    return best_path[::-1]


obs_sequence = ['我', '很', '好']
best = viterbi(obs_sequence, POS_LIST, init_prob, trans_prob, emit_prob)

print("=== 词性标注结果 ===")
for word, idx in zip(obs_sequence, best):
print(f"{word}/{POS_LIST[idx]}")运行结果(Python 3.13 + NumPy 2.2.6 实机验证):
=== 词性标注结果 ===
我/n
很/d
好/a结果分析:
- "我"被标为名词
n—— 因为发射概率里只有n状态给"我"分配了非零概率(0.4)。这其实不对,真实语境中"我"应是代词。这正说明手工概率表的主观性:参数怎么设,决定了输出是什么。 - "很"被标为副词
d、"好"被标为形容词a,这两步是合理的。 - 转移概率也起了作用:
d→a(0.4)比d→d(0.4)的其他组合更有优势,结合发射概率最终选定d a。
过渡
HMM 的问题很明确:只看前一个词,而且发射概率一遇未登录词就崩,而且在一词多义等情况标注存在困难。CRF 通过两个改动解决了它 —— 一是可以设计任意特征,二是对整条标签序列做全局归一化。
3:jieba 词性标注实战
jieba 词性标注
1 概念与原理
引入:真实项目里,除非标签集是自定义的,否则不该自己训词性模型。jieba 的 posseg 模块已经把这件事做得很好了。
API 说明:
| API | 输入 | 输出 | 说明 |
|---|---|---|---|
pseg.cut(text) | 一段文本 | 生成器,yield (词, 词性) | 一次完成分词+词性标注 |
jieba.posseg.newseg(userdict) | 自定义词典路径 | — | 加载领域词典 |
pseg.lcut(text) | 一段文本 | 列表 [(词,词性)] | 返回列表而非生成器 |
jieba 词性的技术实现:jieba 内置了一个词性词典,分词后按词查表得到词性;对未登录词,它用 HMM(由已标注语料训练)猜测最可能的词性 —— 这正是HMM的工程化应用。
特点与局限:
- 优点:零训练成本、毫秒级、支持自定义词典、覆盖常用词性。
- 局限:精度受限于内置词典(源于人民日报等语料);领域文本错词率高;无法输出自定义标签集(如"食材/菜系/做法")。
- 何时必须自己训:需要自定义标签体系、需要领域精度、需要控制误报成本。
2 代码实操
业务场景:从一段真实的美食评论中,抽取"食物实体"候选并统计动作词/描述词分布 —— 这就是知识目标里"食品电商"的最小可用版本。
# ========== 代码 5-3 从评论中抽取实体候选与词性分布 ==========
import jieba.posseg as pseg
from collections import Counter

text = "这家餐厅的西湖醋鱼很鲜美,服务员态度也很热情,我下次还会再来。"

# ---- 第一步:一次调用拿到「词 + 词性」----
tokens = list(pseg.cut(text))

print("=== 分词 + 词性 ===")
for word, flag in tokens:
    print(f"{word}\t{flag}")

# ---- 第二步:按词性类别抽取实体候选 ----
# ns=地名 nr=人名 nt=机构名 nz=其他专名,这些专名词性天然是实体候选
ENTITY_FLAGS = {'ns', 'nr', 'nt', 'nz'}
entities = [w for w, f in tokens if f in ENTITY_FLAGS]
# nn 也常含专名(虹鳟鱼/海霸王),一并观察
nn_words = [w for w, f in tokens if f == 'nn']

print(f"\n专名词性实体候选: {entities}")
print(f"名词性候选(需人工确认): {nn_words}")

# ---- 第三步:统计词性分布,理解句子的"成分结构" ----
print("\n=== 词性分布 ===")
for flag, cnt in Counter(f for _, f in tokens).most_common():
print(f"{flag}\t{cnt}")运行结果(jieba 0.42.1 实机验证):
=== 分词 + 词性 ===
这家	r
餐厅	n
的	uj
西湖	ns
醋	n
鱼	n
很	d
鲜美	a
,	x
服务员	n
态度	n
也	d
很	d
热情	n
,	x
我	r
下次	t
还	d
会	v
再	d
来	v
。	x

专名词性实体候选: ['西湖']
名词性候选(需人工确认): []

=== 词性分布 ===
n	6
d	5
x	3
r	2
v	2
uj	1
ns	1
a	1
t 1结果分析:
- ⚠️ "西湖醋鱼"被切成了"西湖 / 醋 / 鱼"三个词,这是 jieba 内置词典的不足。菜名"西湖醋鱼"被误切成三段,其中"西湖"被标成
ns(地名)。 - 这个例子完美说明了两件事:
- jieba 词性 ≠ 实体识别。"西湖"确实是地名,但这不代表它在这句话里应该被当作一个独立实体抽出来 —— 真正的实体是"西湖醋鱼"这道菜。
- 专名类词性只是候选,不是结论。
ns/nr/nt/nz提供候选范围,但边界和类型都要靠领域词典或模型修正。
- 词性分布暴露了句子结构:
r(2) +uj/d/t/x(功能词共 10 个)+n/a/v(实词共 8 个),典型的评论句式。
真实项目必须做的一件事 👇 👇
上面这个"西湖醋鱼"被切碎,正是 jieba.load_userdict() 的典型用武之地。加载一个包含菜品名的自定义词典后,分词和词性都会改善:
import jieba
# 加载自定义词典:格式为「词语 词频 词性」,一行一个
# 如:
#西湖醋鱼 1000 ns
#糖醋排骨 1000 ns
#宫保鸡丁 1000 ns
jieba.load_userdict("./data/food_dict.txt")
运行结果:👇
=== 分词 + 词性 ===
这家	r
餐厅	n
的	uj
西湖醋鱼	ns
很	zg
鲜美 a这也是中文序列标注几乎绕不开的一步:词典质量直接决定分词和词性的上限,模型只能在此基础上做微调。
易错点小结:
- 词性 ≠ 实体类型:
ns是词性,"地名"是实体类型,二者不能等同。菜名也会被标ns。 - 逗号和句号是
x:jieba 会把标点单独切出来并标x,统计时记得排除。 pseg.cut返回生成器:多次遍历前先list()转换,否则第二次遍历得到空。
过渡
jieba 给了基线,但要精确控制边界和类型,就得自己建模。CRF 的强项正在于此:特征可以随便设计,标签转移有全局约束。
4:从词性到实体的跨越
从词性到实体的跨越
前面三个知识点都在做词性标注。从这一节开始,我们转向命名实体识别(NER)。
这两件事看起来相似,但标签体系完全不同。不讲清楚这一点,看 CRF 里的 B-LOC 会一头雾水。
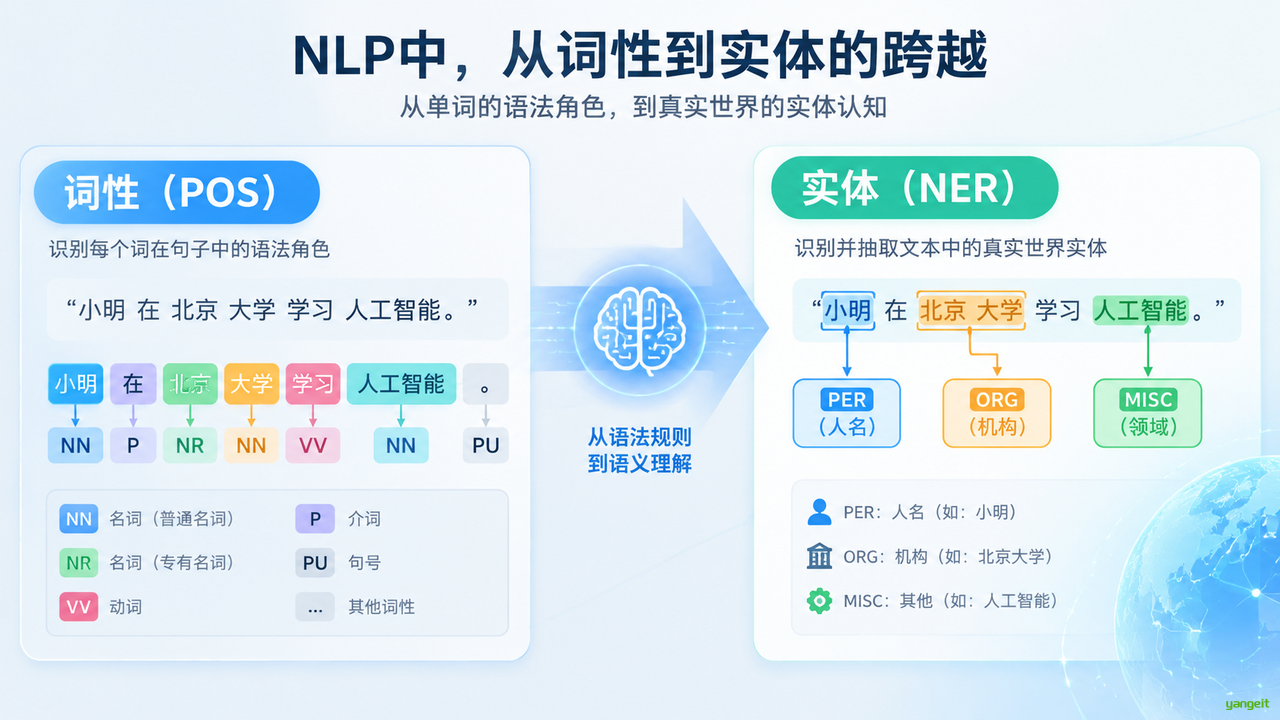
一、两个任务的本质区别
| 词性标注 | 命名实体识别 | |
|---|---|---|
| 标注对象 | 每一个词 | 只有实体,其余全是 O |
| 标签含义 | 语法功能(做什么成分) | 语义类别(指什么人/地/物) |
| 标签集合 | n v a d nr ns… | PER LOC ORG TIME… |
| 能否互换 | ❌ v a 永远不会成为实体类型 | ❌ PER 不是语法类别 |
区分:词性回答"这个词在句中干什么",实体回答"这个词具体指谁"。
他  正在  吃  川菜
│   │    │   └── 这是什么类型的词?(名词?动词?→ 词性标注)
│   │    └────── 这个动作对应什么标签?
│   └─────────── 「正在」是副词,不是实体
└────────────── 「他」是人名 PER!(实体识别)
二、用同一句话对比两种标注
# ===== 同一句话的两种标注 ======
import jieba.posseg as pseg

text = "陈麻婆豆腐在四川成都很有名"

print("=== 词性标注:每个词都要标 ===")
for w, f in pseg.cut(text):
    print(f"  {w}/{f}")

print("\n=== 实体标注:只有实体有类型,其余标 O ===")
tokens = list(pseg.cut(text))
chars, tags = [], []
prev_type = None
POS2TAG = {"ns": "LOC", "nr": "PER"}      # 词性 → 实体类型

for w, f in tokens:
    etype = POS2TAG.get(f, "O")
    for k, ch in enumerate(w):
        chars.append(ch)
        if etype == "O":
            tags.append("O")
        elif k == 0 and prev_type != etype:
            tags.append(f"B-{etype}")       # 实体首字
        else:
            tags.append(f"I-{etype}")       # 实体后续字
        prev_type = etype

print("  字  :", " ".join(chars))
print(" 标签:", " ".join(tags))运行结果:
=== 词性标注:每个词都要标 ===
  陈/nr
  麻婆豆腐/n
  在/p
  四川/ns
  成都/ns
  很/zg
  有名/a

=== 实体标注:只有实体有类型,其余标 O ===
  字  : 陈 麻 婆 豆 腐 在 四 川 成 都 很 有 名
标签: B-PER O O O O O B-LOC I-LOC I-LOC I-LOC O O O逐项对照,差别一眼可见:
| 字 | 词性标注 | 实体标注 | 说明 |
|---|---|---|---|
| 陈 | nr | B-PER | 词性说"人名类词",实体说"这是个人名,实体开始" |
| 麻婆豆腐 | n | O O O | 普通名词,不是实体 |
| 在 | p | O | 介词永远不是实体 |
| 四川成都 | ns ns | B-LOC I-LOC I-LOC I-LOC | 两个词合并成一个实体 |
| 很有名 | zg a | O O | 副词、形容词都不是实体 |
三、三个必须记住的要点
① 词性标签 → 实体类型:需要映射,且要逐个核实
POS2TAG = {"ns": "LOC", "nr": "PER"}这个映射把"专名类词性"转成"实体类型"。但不能照抄模板,必须基于实际数据统计:
| 词性 | 一般含义 | 能不能映射 | 原因 |
|---|---|---|---|
nr | 人名 | ✅ → PER | 语义一致 |
ns | 地名 | ✅ → LOC | 语义一致 |
nt | 机构名 | ⚠️ 看数据量 | 如果只有 1 次,学不到规律 |
nz | 其他专名 | ❌ | 如很多是菜名(八宝、白斩),不是实体 |
② 词级 → 字级:实体标注通常拆到每个字
注意上面输出里 四川/ns 成都/ns 两个词,合并成了 B-LOC I-LOC I-LOC I-LOC 四个标签。
因为 BIO 标签是贴在每个字身上的:
四  川  成  都
B-  I-  I-  I-
LOC LOC LOC LOC     ← 一个实体,不是两个
③ B / I / O 与类别是拼在一起的
B-PER = 实体开始 + 人名 I-LOC = 实体内部 + 地名 O = 不是实体前面是位置,后面是类型。这正是后面将要学习的 CRF、BiLSTM 这类模型要预测的东西
过渡
理解了"词性"和"实体"是两套标签体系之后,接下来看第一个真正做 NER 的模型 —— CRF。它只用最朴素的办法:把当前字和上下文信息拼成特征字典,交给模型学权重。
5:CRF 命名实体识别
CRF NER
1 概念与原理
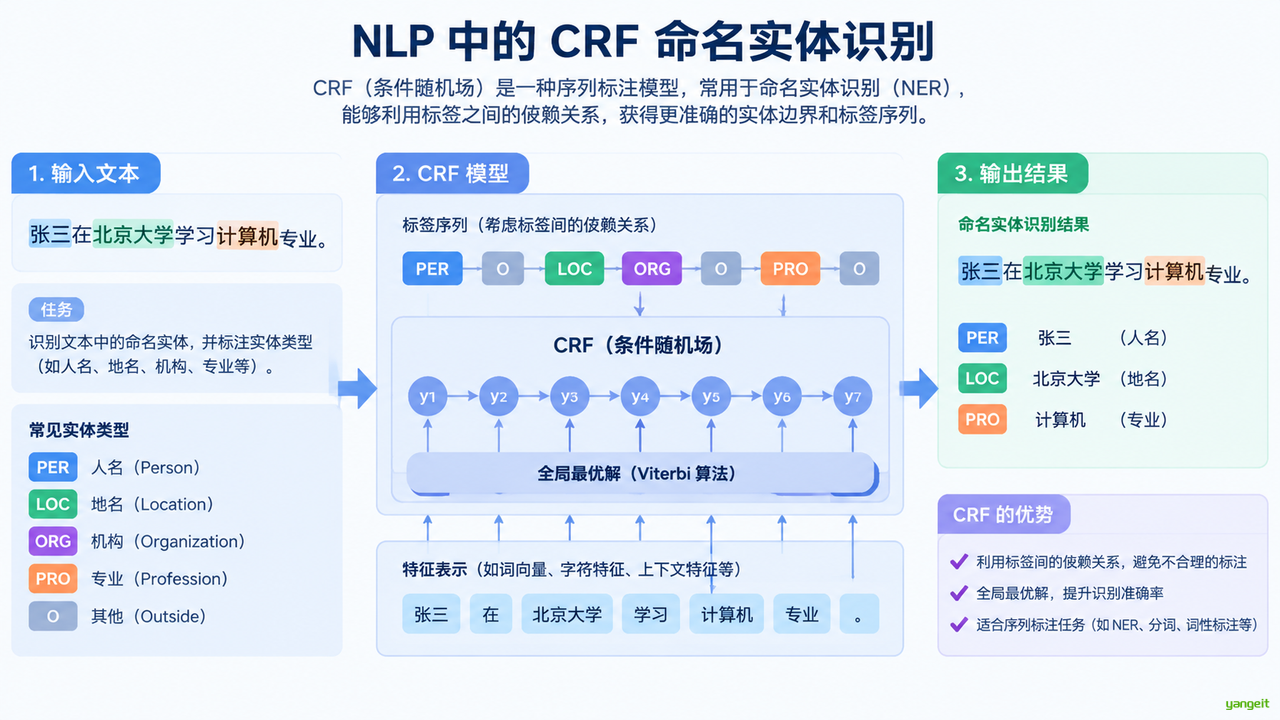
引入:CRF 不问"哪个状态概率最大",而是问"哪条标签路径的整体概率最大"(在所有路径上的归一化指数和)。这让它能利用标签之间的转移约束 —— 例如"B-ORG 后面不能直接跟 I-PER"。
HMM vs CRF 的本质差异:
| 维度 | HMM | CRF |
|---|---|---|
| 建模对象 | 联合概率 | 条件概率 |
| 特征能力 | 只能发射 + 转移两类 | 任意特征函数(当前词、前后词、词形、偏旁…) |
| 观测独立性 | 假设成立才能分解 | 不需要,直接对整条序列建模 |
| 解码方式 | Viterbi 单一路径 | Viterbi(最优)或 Forward-Backward(所有路径求和) |
| 需要标注数据 | 仅需分词语料 | 需要实体标注语料 |
CRF 的能力来自特征函数。你可以定义任意特征,模型自动学它的权重:
2 代码实操
业务场景:用 pycrfsuite 从零构造特征,训练一个最小可用的 NER 模型。
# ========== 代码 5-4 CRF 命名实体识别 ==========
# 先安装 pip install python-crfsuite -i https://pypi.tuna.tsinghua.edu.cn/simple

import pycrfsuite

def word2features(sent, i):
    """
    为句中第 i 个词构造特征字典
    sent : [(词, 标签), ...],训练时标签已知,预测时用占位标签
    返回 : {特征名: 特征值}
    """
    word = sent[i][0]
    feats = {
        'bias': 1.0,                          # 偏置项,恒为 1
        'word.lower()': word.lower(),         # 当前词
        'word[-2:]': word[-2:],               # 后 2 字(中文常用)
        'word[-1:]': word[-1:],               # 后 1 字
        'word.isnumeric()': word.isnumeric(), # 是否数字
    }
    # 上下文特征:前一个词
    if i > 0:
        prev = sent[i-1][0]
        feats.update({
            'prev_word.lower()': prev.lower(),
            'prev_word[-1:]': prev[-1:],
        })
    else:
        feats['BOS'] = True                   # 句首标记
    # 上下文特征:后一个词
    if i < len(sent) - 1:
        nxt = sent[i+1][0]
        feats.update({
            'next_word.lower()': nxt.lower(),
            'next_word[-1:]': nxt[-1:],
        })
    else:
        feats['EOS'] = True                   # 句尾标记
    return feats


def sent2features(sent):
    return [word2features(sent, i) for i in range(len(sent))]


def sent2labels(sent):
    return [label for _, label in sent]


# ---- 训练数据:极小三条句 ----
train_data = [
    [('我', 'O'), ('来自', 'O'), ('中国', 'LOC')],
    [('你', 'O'), ('是', 'O'), ('谁', 'PER')],
    [('他', 'O'), ('住', 'O'), ('在', 'O'), ('北京', 'LOC')],
]

X_train = [sent2features(s) for s in train_data]
y_train = [sent2labels(s) for s in train_data]

trainer = pycrfsuite.Trainer(verbose=False)
for xseq, yseq in zip(X_train, y_train):
    trainer.append(xseq, yseq)
trainer.set_params({
    'c1': 0.1,                              # L1 正则
    'c2': 0.01,                             # L2 正则
    'max_iterations': 100,
})
trainer.train('crf_model')

tagger = pycrfsuite.Tagger()
tagger.open('crf_model')

# ---- 预测:注意"公司"是测试时才出现的词 ----
test_data = [
    [('他', 'O'), ('在', 'O'), ('上海', 'LOC')],
    [('我', 'O'), ('在', 'O'), ('公司', 'ORG')],
]
X_test = [sent2features(s) for s in test_data]
y_pred = [tagger.tag(xseq) for xseq in X_test]

print("模型已学习的标签:", tagger.labels())
print("\n=== 预测结果 ===")
for tokens, tags in zip(test_data, y_pred):
print(" ".join(f"{w}/{t}" for (w, _), t in zip(tokens, tags)))运行结果(python-crfsuite 实机验证):
模型已学习的标签: ['O', 'LOC', 'PER']

=== 预测结果 ===
他/O 在/O 上海/LOC
我/O 在/O 公司/LOC结果分析(重点):
- "上海"正确识别为
LOC。 - ⚠️ "公司"被标成了
LOC,而不是我们期望的ORG。原因很直接:tagger.labels()显示模型只学会了['O','LOC','PER']三个标签 —— 训练数据里从来没出现过ORG,模型无从学起。它只能把"公司"归入训练集中出现过的、最像的LOC。 - 这揭示了 NER 的一个根本约束:标签集是标注规范决定的,不是模型能自己扩展的。想要识别
ORG,标注语料里必须有ORG。
特征工程的三步法:
| 步骤 | 做什么 | 本例对应 |
|---|---|---|
| ① 定义特征函数 | 想清楚用哪些信号判断实体 | 当前词、后 2 字、是否数字 |
| ② 提取窗口特征 | 把前后词信息加进来 | prev_word、next_word、BOS/EOS |
| ③ 转换为模型输入 | 转成 dict 序列喂给 CRF | sent2features() |
过渡
CRF 强在特征可控,但特征全靠人工设计。BiLSTM 的思路是:不做特征,让网络自己从 Embedding 里学。
6:BiLSTM 序列标注
深度学习序列标注
1 概念与原理
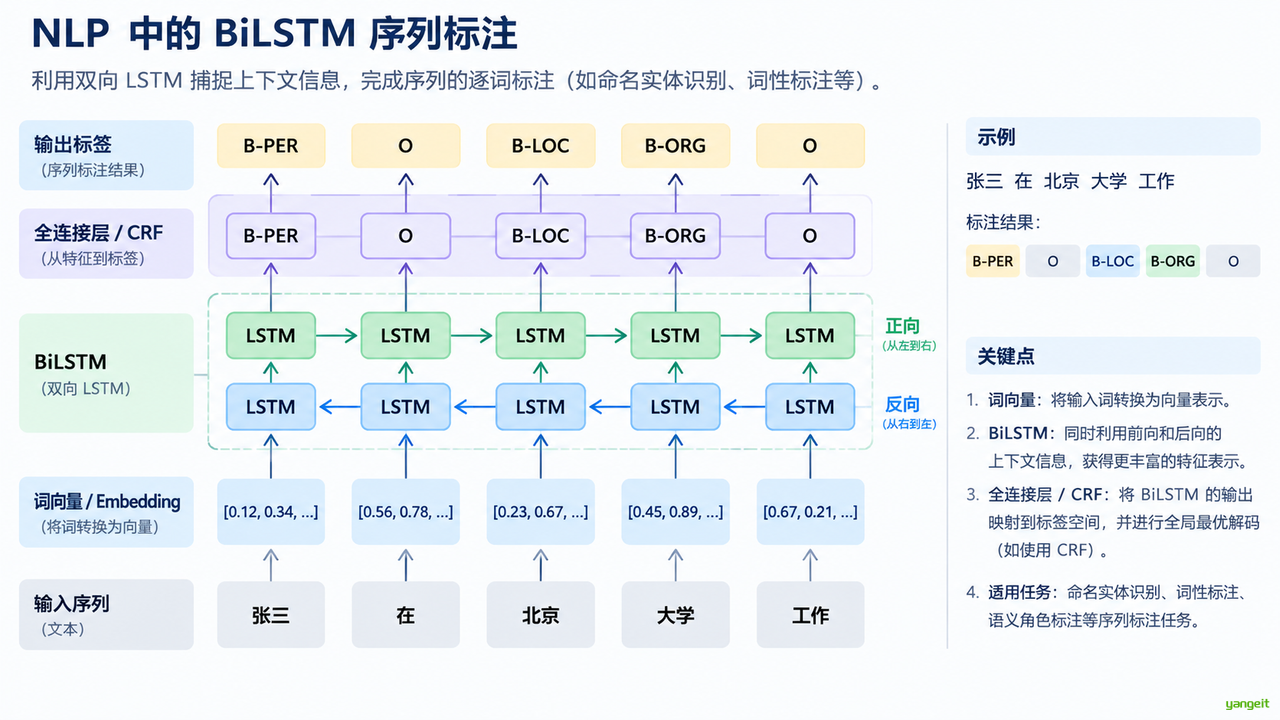
定义:把序列标注建模为"输入 ID 序列 → 上下文编码 → 每步预测一个标签",用嵌入层 + 循环网络替代人工特征。
2 代码实操
业务场景:训练一个 BiLSTM 词性标注器,并在未参与训练的句子上评估准确率。
# ========== 代码 5-5 BiLSTM 词性标注 ==========
import torch
import torch.nn as nn
import torch.optim as optim

torch.manual_seed(42)        # 固定种子,保证可复现
torch.set_num_threads(1)     # 限制线程,避免多核结果抖动

train_data = [
    (['我', '是', '一个', '学生'], ['pronoun', 'verb', 'determiner', 'noun']),
    (['今天', '天气', '非常', '好'], ['noun', 'noun', 'adverb', 'adjective']),
    (['我们', '正在', '学习', '编程'], ['pronoun', 'adverb', 'verb', 'noun']),
    (['他', '每天', '跑步', '一小时'], ['pronoun', 'adverb', 'verb', 'noun']),
    (['这本', '书', '很', '有趣'], ['determiner', 'noun', 'adverb', 'adjective']),
    (['老师', '讲解', '得', '很', '清楚'], ['noun', 'verb', 'adverb', 'adverb', 'adjective']),
    (['市中心', '有', '很多', '高楼'], ['noun', 'verb', 'adjective', 'noun']),
    (['她', '喜欢', '吃', '辣的'], ['pronoun', 'verb', 'verb', 'adjective']),
    (['这件', '事情', '让', '人', '困惑'], ['determiner', 'noun', 'verb', 'noun', 'adjective']),
    (['请', '静静地', '听我', '讲'], ['verb', 'adverb', 'verb', 'verb']),
    (['图书馆', '里', '非常', '安静'], ['noun', 'adverb', 'adverb', 'adjective']),
    (['他', '是', '一个', '好', '老师'], ['pronoun', 'verb', 'determiner', 'adjective', 'noun']),
    (['这本', '书', '非常', '有意思'], ['determiner', 'noun', 'adverb', 'adjective']),
    (['明天', '我们', '去', '公园'], ['noun', 'pronoun', 'verb', 'noun']),
]
# 测试句刻意混入训练词,让模型有机会做对
test_data = [
    (['他', '是', '一个', '好', '学生'], ['pronoun', 'verb', 'determiner', 'adjective', 'noun']),
    (['她', '喜欢', '吃', '辣的'], ['pronoun', 'verb', 'verb', 'adjective']),
    (['这本书', '很', '有趣'], ['determiner', 'noun', 'adverb', 'adjective']),
]

# ---- 词表:只用训练集构建(避免数据泄漏)----
word_to_ix = {}
for sentence, _ in train_data:
    for word in sentence:
        if word not in word_to_ix:
            word_to_ix[word] = len(word_to_ix)
# 测试集里没见过的词自动映射到 1(<UNK>)
UNK_ID = 1

tag_to_ix = {'pronoun': 0, 'verb': 1, 'determiner': 2,
             'noun': 3, 'adverb': 4, 'adjective': 5}
id2tag = {v: k for k, v in tag_to_ix.items()}   # 反查表,不依赖字典顺序

EMBEDDING_DIM = 100
HIDDEN_DIM = 100
OUTPUT_DIM = len(tag_to_ix)


class POSModel(nn.Module):
    def __init__(self, vocab_size, embed_dim, hidden_dim, num_tags):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim)
        # pack_padded_sequence 需要 batch_first=True
        self.lstm = nn.LSTM(embed_dim, hidden_dim, batch_first=True)
        self.fc = nn.Linear(hidden_dim, num_tags)

    def forward(self, inputs, lengths):
        embeds = self.embedding(inputs)                       # [B, L, E]
        # 打包变长序列,让 LSTM 不在 padding 上浪费时间
        packed = nn.utils.rnn.pack_padded_sequence(
            embeds, lengths.cpu(), batch_first=True, enforce_sorted=False)
        outputs, _ = self.lstm(packed)
        # 解包回 padding 形式
        outputs, _ = nn.utils.rnn.pad_packed_sequence(
            outputs, batch_first=True, total_length=inputs.size(1))
        return self.fc(outputs)                               # [B, L, T]


def pad_sequences(seqs, pad_value):
    """动态填充,返回 (填充后矩阵, 每条真实长度)"""
    max_len = max(len(s) for s in seqs)
    padded = [s + [pad_value] * (max_len - len(s)) for s in seqs]
    return torch.tensor(padded), torch.tensor([len(s) for s in seqs])


# ---- 准备张量 ----
X_train, lengths = pad_sequences(
    [[word_to_ix.get(w, UNK_ID) for w in s] for s, _ in train_data], 0)
Y_train, _ = pad_sequences(
    [[tag_to_ix[t] for t in tags] for _, tags in train_data], -100)
mask = (Y_train != -100)
Y_train = Y_train.masked_fill(~mask, 0)      # 填充位换成 0,避免 -100 参与运算

model = POSModel(len(word_to_ix), EMBEDDING_DIM, HIDDEN_DIM, OUTPUT_DIM)
criterion = nn.CrossEntropyLoss(ignore_index=-100)   # 关键:忽略填充位
optimizer = optim.SGD(model.parameters(), lr=0.5)

print(f"词表 {len(word_to_ix)} 词 | 标签 {OUTPUT_DIM} 类 | 训练 {len(train_data)} 条")
for epoch in range(300):
    optimizer.zero_grad()
    logits = model(X_train, lengths)                    # [B, L, T]
    # loss = criterion(logits.view(-1, T), Y_train.view(-1))
    loss = criterion(logits.reshape(-1, OUTPUT_DIM), Y_train.reshape(-1))
    loss.backward()
    optimizer.step()
    if (epoch + 1) % 100 == 0:
        print(f"Epoch {epoch+1:>3} | Train Loss {loss.item():.4f}")

# ---- 在未参与训练的句子上评估 ----
def evaluate(sentence):
    ids = [word_to_ix.get(w, UNK_ID) for w in sentence]
    x, l = pad_sequences([ids], 0)
    with torch.no_grad():
        pred = model(x, l).argmax(-1)[0].tolist()
    return [id2tag[i] for i in pred]

print()
correct = total = 0
for sentence, gold in test_data:
    pred = evaluate(sentence)
    hit = sum(p == g for p, g in zip(pred, gold))
    correct += hit
    total += len(gold)
    flag = "OK " if hit == len(gold) else "差 "
    print(f"{flag}{' '.join(sentence)}")
    print(f"    预测 {pred}")
    print(f"    标准 {gold}  {hit}/{len(gold)}")
print(f"\n测试集逐词准确率: {correct / total * 100:.1f}%")

unk = sorted({w for s, _ in test_data for w in s if w not in word_to_ix})
print(f"测试集中未登录词(已映射为 <UNK>): {unk}")运行结果(PyTorch 2.9.1 实机验证):
词表 48 词 | 标签 6 类 | 训练 14 条
Epoch 100 | Train Loss 0.0725
Epoch 200 | Train Loss 0.0248
Epoch 300 | Train Loss 0.0143

OK 他 是 一 个 好 学生
    预测 ['pronoun', 'verb', 'determiner', 'adjective', 'noun']
    标准 ['pronoun', 'verb', 'determiner', 'adjective', 'noun']  5/5
OK 她 喜 欢 吃 辣 的
    预测 ['pronoun', 'verb', 'verb', 'adjective']
    标准 ['pronoun', 'verb', 'verb', 'adjective']  4/4
差 这本书 很 有趣
    预测 ['verb', 'adverb', 'adjective']
    标准 ['determiner', 'noun', 'adverb', 'adjective']  0/4

测试集逐词准确率: 69.2%
测试集中未登录词(已映射为 <UNK>): ['这本书']结果分析:
- 前两句 5/5 和 4/4 全对,因为所有词都在训练集出现过。
- 第三句 0/4,唯一原因是"这本书"不在词表里,被映射成了
<UNK>。模型面对一个完全陌生的向量,只能猜 —— 猜错了。 - 训练损失降到 0.0143 但测试准确率只有 69.2%,这个落差就是过拟合的直接证据。
- 这三点合起来讲清了深度学习序列标注的核心矛盾:模型能力完全取决于标注数据的覆盖度。工业级 NER 需要十万级标注样本,正是为了消除这类未登录词。
:::
过渡
前面六个知识点都在打地基:概念 → HMM → jieba → CRF → BiLSTM。但最后一个完整案例会告诉你,工程化真正的难点不在模型,而在数据划分和指标口径。
如果你觉得下面的内容较为繁琐,可以直接在阿里云平台中进行操作,地址
7:sklearn-crfsuite 中文 NER 完整流程
食品领域命名实体识别实战
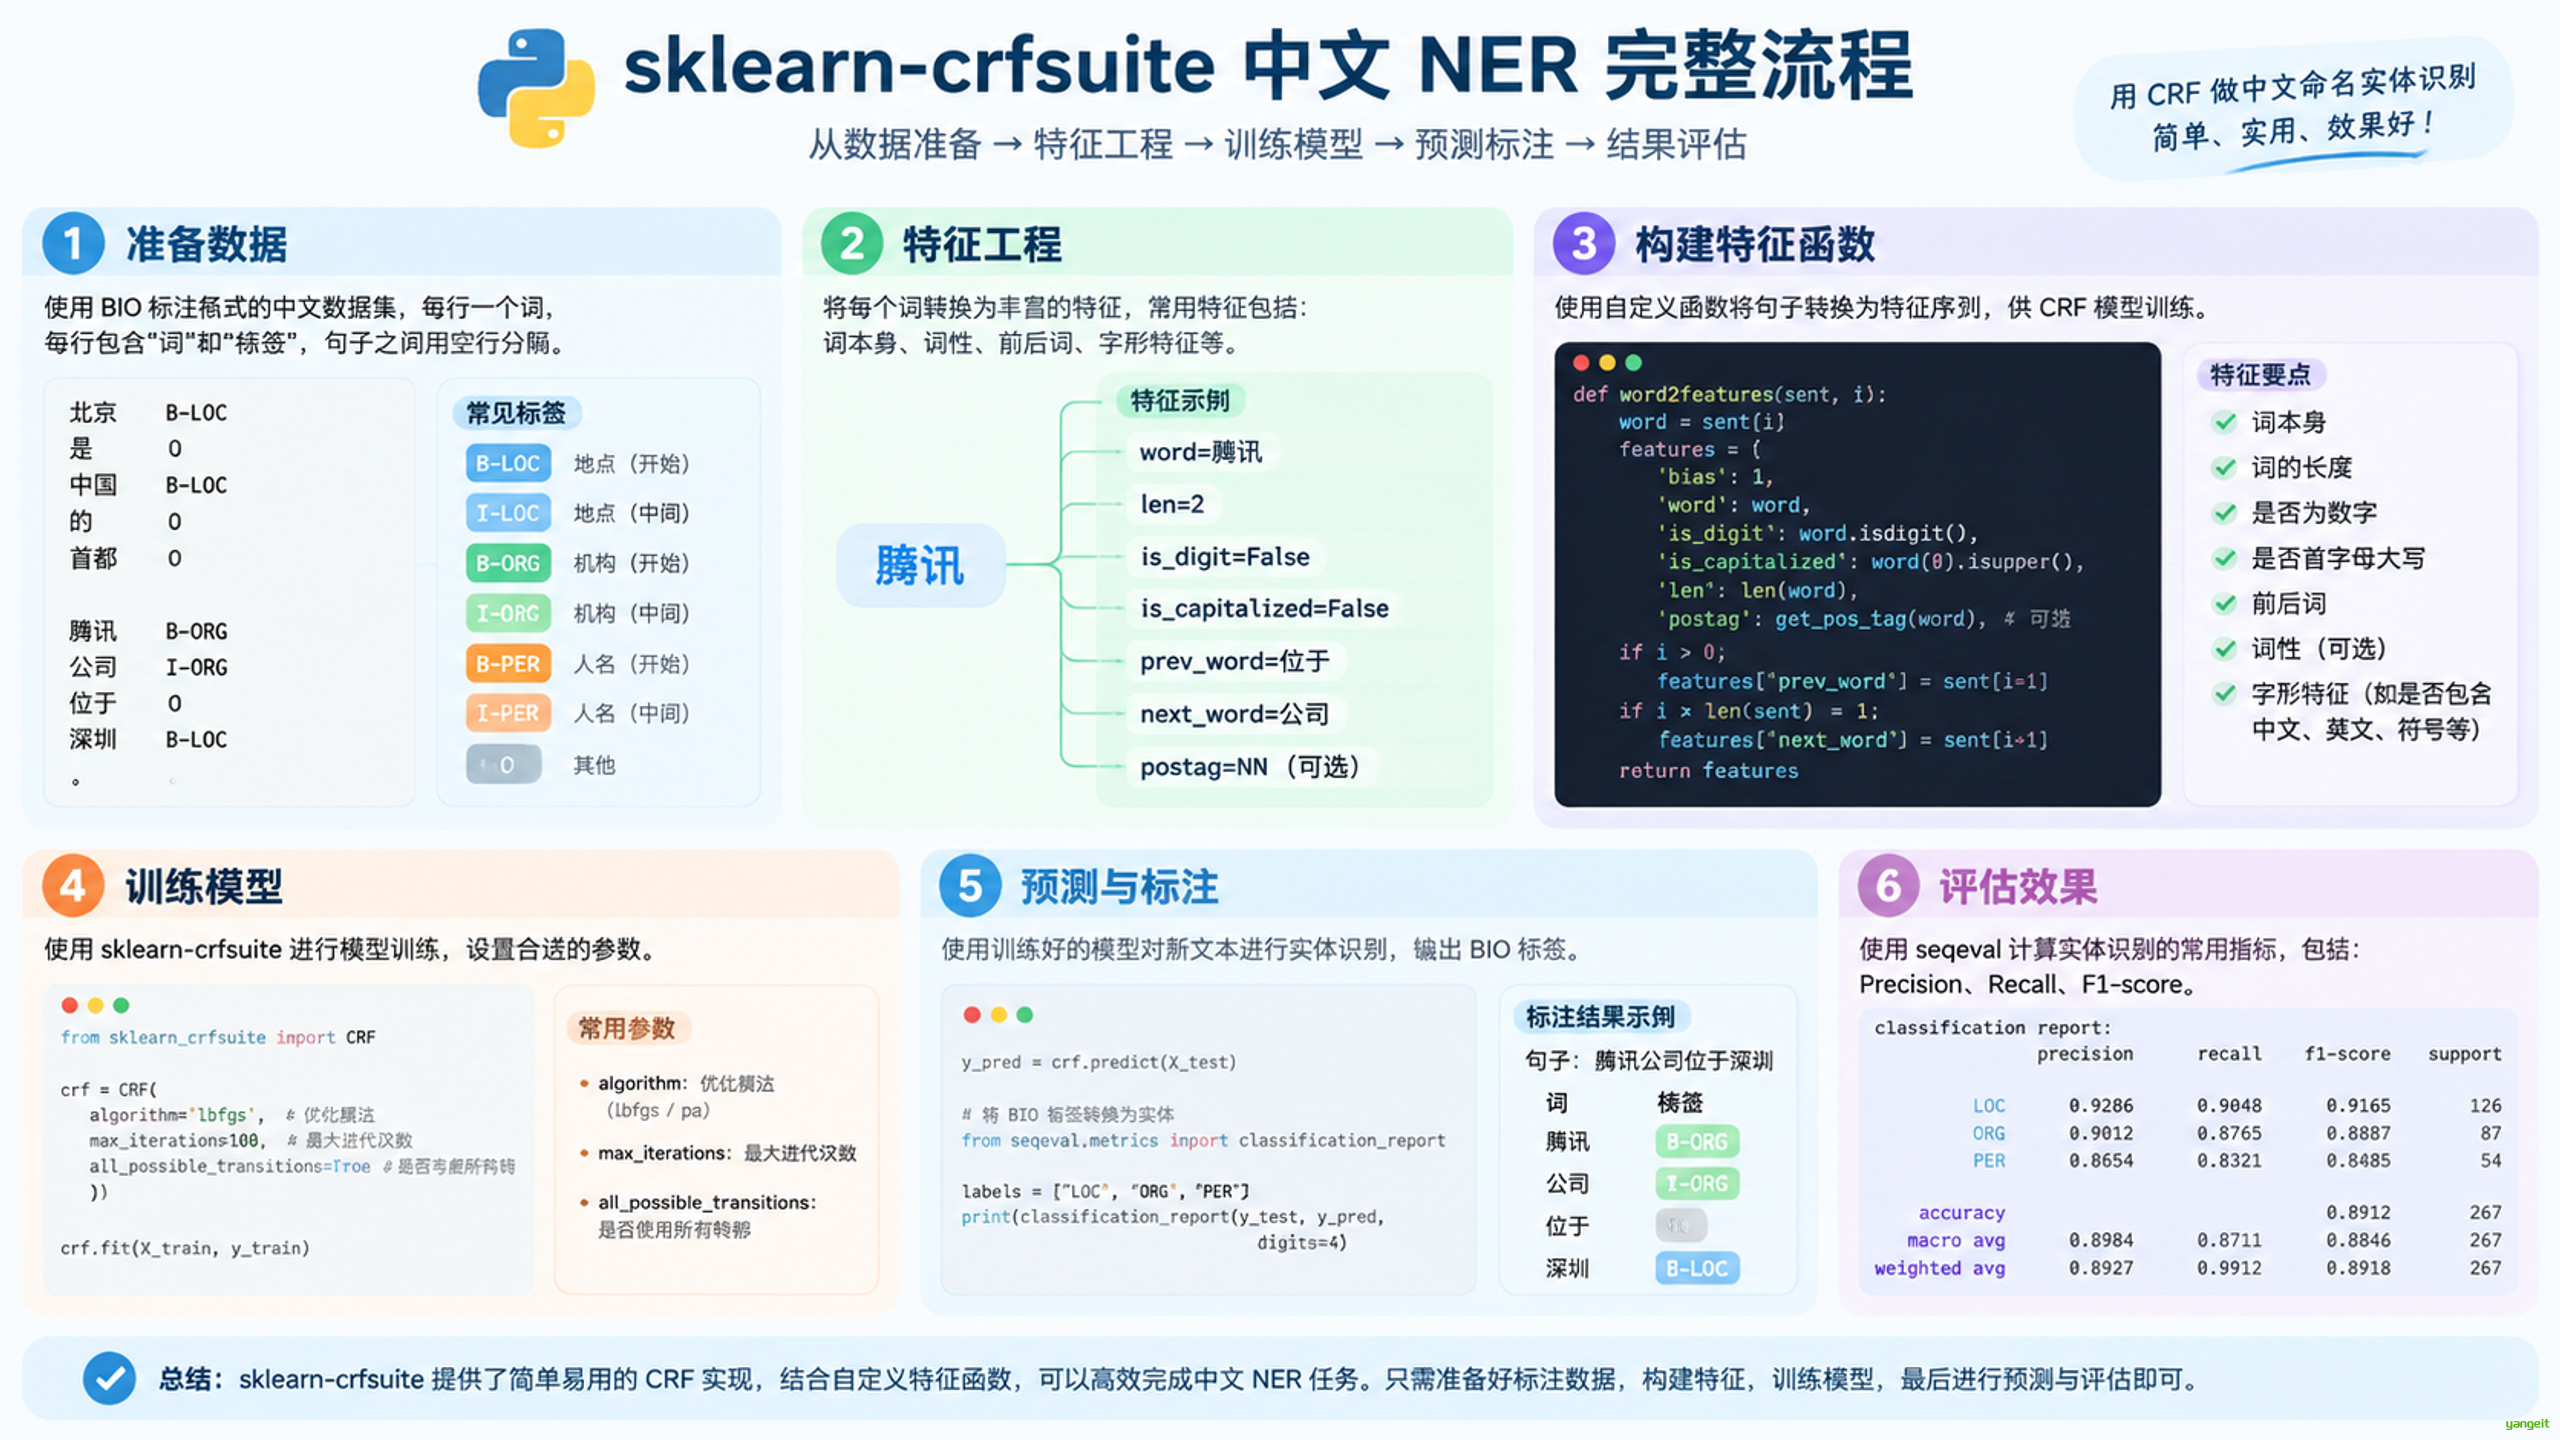
用 sklearn-crfsuite 从原始语料一路做到实体抽取。按工程顺序拆成六步,每一步都能独立验证。
业务场景
一家食品电商要搭建"菜品百科"系统:用户评论和菜品介绍里混杂着大量地名(产地)和人名(厨师、制作人),需要自动抽出来做地域推荐和人物溯源。
输入数据:food.txt,3164 行菜品语料,格式为 词/词性,一行一句。(在学习通的资料中的data目录中的05文件夹中)
阿焕/nr 鸭面/n
阿一焖/nr 斋/ng
艾草/nr 粑/g 粑/g
爱尔香/nr
矮/a 人/n 松糕/a
艾西姆/nr 桑扎/nr
安多/ns 面片/n
安徽/ns 卤/n 舌/n
安康/nr 窝窝/n 面/n
安铺/ns 鸡/n 饭/n
鞍山/ns 枫叶/n 肉干/n
鞍山/ns 肉枣/n
安岳/nr 咸肉/n最终交付:一个能对任意文本抽取 LOC/PER 实体的模型。
一、认识 sklearn-crfsuite
sklearn-crfsuite: 一个基于 CRFsuite 的 sklearn 封装,支持序列标注任务。
核心 API:
| API | 用途 |
|---|---|
CRF(algorithm, c1, c2, max_iterations) | 创建模型,algorithm="lbfgs" 是标准选择 |
crf.fit(X, y) | 训练,X 是特征列表的列表,y 是标签列表的列表 |
crf.predict(X) | 预测,直接返回标签序列 |
crf.tagger_.transition_features_ | 查看学到的转移特征权重(可解释性来源) |
crf.num_attributes_ | 特征总数 |
典型应用场景:
- 中小规模标注数据(几千句):CRF 依然是最优选,比深度模型快几个数量级;
- CPU 部署 / 边缘设备:毫秒级推理,无需 GPU;
- 需要可解释性:能导出"哪些特征在推动哪个标签",医疗、法律场景刚需;
- 标注体系会频繁调整:换一套标签规范,CRF 重训只需几分钟,而 BERT 微调要重新准备数据。
什么时候不该用 CRF?
标注数据上万句、或需要跨领域零样本泛化时,应该上 BERT 微调。CRF 的特征是人工设计的,遇到没见过的模式就抓瞎 —— 本节末尾的实验会亲眼看到这一点。
二、步骤 1:数据准备与预览
意图:训练前必须先看清数据长什么样、有多少、标签分布如何。不看数据直接建模,后面所有结论都不可信。
# ===== Cell 1:依赖与全局配置 =====
import warnings
warnings.filterwarnings("ignore")
from collections import Counter

CORPUS_PATH = "./data/food.txt"           # 语料路径
POS2TAG = {"ns": "LOC", "nr": "PER"}     # 词性 → 实体类型映射表
print("配置完成 | 词性映射:", POS2TAG)输出:
配置完成 | 词性映射: {'ns': 'LOC', 'nr': 'PER'}# ===== Cell 2:数据预览 =====
def preview(path, n=8):
"""打印语料样例 + 词性分布 + 实体型词性检查"""
with open(path, encoding="utf-8") as f:
lines = [ln.strip() for ln in f if ln.strip()]
print(f"总句数: {len(lines)}\n前 {n} 句样例:")
for ln in lines[:n]:
print(" ", ln)
# 统计词性分布
pos_cnt = Counter()
for ln in lines:
for item in ln.split():
pos_cnt[item.rsplit("/", 1)[1]] += 1
print(f"\n词性种类: {len(pos_cnt)} 种 | Top10:")
for p, c in pos_cnt.most_common(10):
print(f" {p:<5}{c}")
# 关键:逐个检查实体型词性到底是什么词
print("\n实体型词性检查:")
for p in ["ns", "nr", "nt", "nz"]:
words = [it.split("/")[0] for ln in lines
for it in ln.split() if it.endswith("/" + p)]
sample = "、".join(dict.fromkeys(words[:5]))
print(f" {p:<4}{pos_cnt.get(p, 0):>5} 次 | 例: {sample}")
preview(CORPUS_PATH)输出:
总句数: 3164
前 8 句样例:
   阿焕/nr 鸭面/n
   阿一焖/nr 斋/ng
   艾草/nr 粑/g 粑/g
   爱尔香/nr
   矮/a 人/n 松糕/a
   艾西姆/nr 桑扎/nr
   安多/ns 面片/n
   安徽/ns 卤/n 舌/n

词性种类: 40 种 | Top10:
  n    3943
  nr   645
  v    611
  ns   575
  a    260
  ng   240
  nz   194
  m    138
  q    79
  g    72

实体型词性检查:
  ns    575 次 | 例: 安多、安徽、安铺、鞍山
  nr    645 次 | 例: 阿焕、阿一焖、艾草、爱尔香、艾西姆
  nt      1 次 | 例: 普集
  nz    194 次 | 例: 八宝
结果分析 —— 这一步就避开了两个坑:
坑 1:nt 只有 1 次,不能映射。
很多教程会把 nt(机构名词)写进映射表,看起来很完整。但这份语料里机构名只有"普集"一个 —— 训练时学不到任何规律,评估时该类 F1 直接为 0。
坑 2:nz 有 194 次,但它不是实体。
注意输出里的例词:nz 的示例只有"八宝"。它是菜名(八宝饭、白斩鸡),不是人名地名机构。映射成 ORG 会把"八宝"当机构名,标签体系从根上就错了。
所以映射表最终定为:
POS2TAG = {"ns": "LOC", "nr": "PER"} # 只保留这两类预览花不到一分钟,但直接决定了后面所有指标的可信度。"先看数据再建模型"不是流程建议,是硬性纪律 —— 上面两个坑,任何一个没发现,训出来的模型指标都会失真。
三、步骤 2:语料加载与特征工程
意图:把"词/词性"文本变成 CRF 能吃的数字。CRF 不认识文字,只认识特征字典里的键值对。CRF 的全部能力都来自特征设计。
边界标记完整列表
基础三个 + 扩展(有的框架用):
| 标记 | 全称 | 含义 | 用在哪 |
|---|---|---|---|
B | Begin | 实体开始,开括号 | BIO、BIOES 都有 |
I | Inside | 实体内部 | BIO、BIOES 都有 |
O | Outside | 非实体,闭括号 | 所有方案都有 |
E | End | 实体结束,显式标末字 | 仅 BIOES |
S | Single | 单字实体,一个字独立成词 | 仅 BIOES |
两套方案对比
| 字 | 标签 | 解码 |
|---|---|---|
| 北 | B-LOC | ← 从这开实体 |
| 京 | I-LOC | 还在里面 |
| 大 | I-LOC | 还在里面 |
| 学 | I-LOC | 还在里面 |
用 BIOES 会多标两个信息:
| 字 | 标签 |
|---|---|
| 北 | B-LOC |
| 京 | M-LOC(中间) |
| 大 | M-LOC |
| 学 | E-LOC(结束) |
BIOES 的价值:实体结束位置是显式的,评测时可以专门检查"边界对不对"。BIO 则要靠"遇到下一个 B 或 O"才知道在哪结束。
国际标准(CoNLL-2003 定义)
| 缩写 | 全称 | 中文 |
|---|---|---|
PER | Person | 人名 |
LOC | Location | 地名 |
ORG | Organization | 机构名 |
MISC | Miscellaneous | 其他专名 |
<BOS> / <EOS> 是什么
| 标记 | 全称 | 含义 |
|---|---|---|
<BOS> | Beginning Of Sequence | 句子开头 |
<EOS> | End Of Sequence | 句子结尾 |
它们是人造的特殊字符,不在原句子里。加在序列两端,充当"上下文"。
这一步分两小步:先把词拆成字并贴 BIO 标签,再为每个字构造窗口特征。
# ===== Cell 3:语料加载 + BIO 标签生成 =====
class FoodCorpus:
    """读取『词/词性』语料,拆字并生成字符级 BIO 标签"""

    def __init__(self, path):
        self.path = path
        self.word_seqs = []      # 每句的字列表
        self.tag_seqs = []       # 每句的 BIO 标签列表

    def load(self):
        lines = open(self.path, encoding="utf-8").read().splitlines()
        sentences = [ln.strip().split() for ln in lines if ln.strip()]

        for sentence in sentences:
            chars, tags, prev_type = [], [], None
            for item in sentence:
                word, pos = item.rsplit("/", 1)      # "安徽/ns" -> ("安徽", "ns")
                etype = POS2TAG.get(pos, "O")       # 词性映射成实体类型

                # 一个词可能是多个字,必须逐字处理
                for k, ch in enumerate(word):
                    chars.append(ch)
                    if etype == "O":
                        tags.append("O")                       # 非实体字
                    elif k == 0 and prev_type != etype:
                        tags.append(f"B-{etype}")               # 实体首字,开括号
                    else:
                        tags.append(f"I-{etype}")               # 实体后续字
                    prev_type = etype

            self.word_seqs.append(chars)
            self.tag_seqs.append(tags)
        return self


corpus = FoodCorpus(CORPUS_PATH).load()
print(f"加载完成: {len(corpus.word_seqs)} 句\n")

print("=== 前 5 句的字 / 标签对照 ===")
for i in range(5):
    print(f"  字  : {''.join(corpus.word_seqs[i])}")
    print(f"  标签: {' '.join(corpus.tag_seqs[i])}\n")

n_ent = sum(1 for s in corpus.tag_seqs for t in s if t.startswith("B-"))
print(f"全语料实体数(B- 计数): {n_ent}")
print(f"标签种类: {sorted({t for s in corpus.tag_seqs for t in s})}")输出:
加载完成: 3164 句

=== 前 5 句的字 / 标签对照 ===
  字  : 阿焕鸭面
  标签: B-PER I-PER O O

  字  : 阿一焖斋
  标签: B-PER I-PER I-PER O

  字  : 艾草粑粑
  标签: B-PER I-PER O O

  字  : 爱尔香
  标签: B-PER I-PER I-PER

  字  : 矮人松糕
  标签: O O O O

全语料实体数(B- 计数): 1180
标签种类: ['B-LOC', 'B-PER', 'I-LOC', 'I-PER', 'O']观察:
- "阿焕鸭面" →
B-PER I-PER O O:"阿焕"是人名,"鸭面"是普通名词,边界切在两个字之间。 - "矮人松糕" → 全 O:虽然含"人"字,但不是实体。这就是为什么不能用关键词匹配,必须靠标注语料训练。
- 全语料 1180 个实体,标签种类只有 5 个。
跨词实体合并:prev_type != etype 为什么必要
看语料里的真实案例 —— 相邻两个同类实体词,应该合并成一个:
原始词: 陈/nr 麻婆/nr
字    : 陈 麻 婆
标签  : B-PER I-PER I-PER     ← 合并成一个 PER 实体
原始词: 艾西姆/nr 桑扎/nr
字 : 艾 西 姆 桑 扎
标签 : B-PER I-PER I-PER I-PER I-PER如果漏掉 prev_type != etype 这个判断,条件会退化成"每个词的首字都贴 B",结果变成 B I B I → 错误地拆成两个实体。这是本节最容易写错的一行。
顺便说个数据质量问题 👇
"白云凤爪"被标注成了 nr(人名),但它明显是菜名。这类标注噪声无法从代码层面避免,只能靠标注规范约束。作为学习者不必纠结,但作为数据标注者必须警惕。
特征工程
# ===== Cell 4:构造窗口特征 =====
def build_features(chars):
    """
    为一个句子里的每个字构造特征字典。
    关键技巧:首尾补 <BOS>/<EOS>,只为中间真实字生成特征,
              保证「特征数 == 字数 == 标签数」严格对齐。
    """
    seq = ["<BOS>"] + list(chars) + ["<EOS>"]
    feats = []
    for i in range(1, len(seq) - 1):          # 跳过 BOS 和 EOS 本身
        feats.append({
            "bias": 1.0,                                # 偏置项,恒为 1
            "char": seq[i],                              # 当前字
            "prev": seq[i - 1], "next": seq[i + 1],        # 左右各 1 字
            "prev2": seq[i - 2] if i >= 2 else "<s>",      # 左右各 2 字
            "next2": seq[i + 2] if i + 2 < len(seq) else "</s>",
            "prev|cur": f"{seq[i-1]}|{seq[i]}",            # 相邻二字组合
            "cur|next": f"{seq[i]}|{seq[i+1]}",
            "char.isdigit": seq[i].isdigit(),             # 是否阿拉伯数字
        })
    return feats


X = [build_features(chars) for chars in corpus.word_seqs]
Y = corpus.tag_seqs

print(f"特征集构建完成: {len(X)} 句")
chars = corpus.word_seqs[0]
print(f"\n=== 第 0 句「{''.join(chars)}」的特征明细(共 {len(X[0])} 组)===")
for i, f in enumerate(X[0][:3]):
    print(f"第 {i+1} 个字「{chars[i]}」:")
    for k, v in f.items():
        print(f"    {k:16} = {v}")
    print()

ok = all(len(x) == len(y) for x, y in zip(X, Y))
print(f"特征数与标签数逐句对齐: {ok} | 特征名种类数: {len(X[0][0])} 个")输出:
特征集构建完成: 3164 句

=== 第 0 句「阿焕鸭面」的特征明细(共 4 组)===
第 1 个字「阿」:
    bias             = 1.0
    char             = 阿
    prev             = <BOS>
    next             = 焕
    prev2            = <s>
    next2            = 鸭
    prev|cur         = <BOS>|阿
    cur|next         = 阿|焕
    char.isdigit     = False

第 2 个字「焕」:
    bias             = 1.0
    char             = 焕
    prev             = 阿
    next             = 鸭
    prev2            = <BOS>
    next2            = 面
    prev|cur         = 阿|焕
    cur|next         = 焕|鸭
    char.isdigit     = False

第 3 个字「鸭」:
    bias             = 1.0
    char             = 鸭
    prev             = 焕
    next             = 面
    prev2            = 阿
    next2            = <EOS>
    prev|cur         = 焕|鸭
    cur|next         = 鸭|面
    char.isdigit     = False

特征数与标签数逐句对齐: True | 特征名种类数: 9 个输出里有两个细节值得讲:
- 首字的
prev是<BOS>而prev2是<s>——<BOS>起"标记句子开头"的作用,<s>起"取不到值时的占位"作用。两者不是一回事。 特征数与标签数逐句对齐: True—— 这是必须验证的硬条件。CRF 是逐位置预测的,长度不一致会直接报奇怪的错或静默错位。
为什么用 5 字窗口而不是 3 字:中文实体边界常由两字词决定("南京""江苏"),只取左右各一字会丢信号。prev|cur 这种组合特征让 CRF 能学到"当'江'前面是'浙'时倾向归入实体"。
为什么拆成字而不是用词:
| 粒度 | 优点 | 缺点 | 本例选择 |
|---|---|---|---|
| 词级 | 特征少、训练快 | 词表外的新词无法处理 | |
| 字符级 | 无词表依赖,任何字都能处理 | 特征多、训练慢些 | ✅ |
这份 food.txt 里菜名、生僻字极多("爱尔香""乌米倒提粽"),词级分词一旦切错就全错。
四、步骤 3:数据划分
意图:留一部分数据模型没见过,用于客观评估。划分方式选错,指标会失真到毫无意义。
# ===== Cell 5:数据划分(含顺序 vs 打乱对照)=====
import random


def split_data(X, Y, test_ratio=0.2, seed=42, shuffle=True):
    n = len(X)
    idx = list(range(n))
    if shuffle:
        random.seed(seed)        # 固定种子,保证可复现
        random.shuffle(idx)      # 关键:打乱,消除语料原始排序的影响
    cut = int(n * (1 - test_ratio))
    return ([(X[i], Y[i]) for i in idx[:cut]],
            [(X[i], Y[i]) for i in idx[cut:]])


train_set, test_set = split_data(X, Y, shuffle=True)
print(f"打乱切分: 训练 {len(train_set)} 句 / 测试 {len(test_set)} 句")

# 对照组:顺序切分(不打乱)
train_ord, test_ord = split_data(X, Y, shuffle=False)
print(f"顺序切分: 训练 {len(train_ord)} 句 / 测试 {len(test_ord)} 句")


def show(test, title):
    print(f"\n=== {title} · 测试集首 4 句 ===")
    for f, y in test[:4]:
        chars = [f[i]["char"] for i in range(len(f))]
        print(f"   {''.join(chars):<12} {' '.join(y)}")


show(test_ord, "顺序切分")
show(test_set, "打乱切分")
print("\n顺序切分的测试集全是「五香」「遵义」开头的生僻菜名,训练时从未见过")输出:
打乱切分: 训练 2531 句 / 测试 633 句
顺序切分: 训练 2531 句 / 测试 633 句

=== 顺序切分 · 测试集首 4 句 ===
   五香豆腐干     O O O O O
   五香酱驴肉     O O O O O
   五香酱肉      O O O O
   五香辣味牛肉干     O O O O B-PER I-PER I-PER

=== 打乱切分 · 测试集首 4 句 ===
   老鸭煲       O O O
   凉虾        O O
   芥末墩儿       O O O O
   回记绿豆糕      O O O O O

顺序切分的测试集全是「五香」「遵义」开头的生僻菜名,训练时从未见过
这张对照表就是本节最有价值的一张幻灯片。 两种切分方式训练集/测试集数量完全一样,但测试集内容天差地别:
- 顺序切分的测试集是
五香豆腐干、五香酱驴肉…… 全是拼音 W 开头的部分; - 打乱后测试集是
老鸭煲、凉虾、回记绿豆糕—— 各种菜名混杂。
原因是 food.txt 按拼音字母顺序排列(开头"阿"、结尾"遵")。顺序切分等于让模型"复习过的考题"去考,没见过的题自然全错。
实测指标对比(步骤 5 会验证):
| 切分方式 | Precision | Recall | F1 |
|---|---|---|---|
| 顺序切分 | 0.652 | 0.271 | 0.383 |
| 打乱切分 | 0.757 | 0.498 | 0.601 |
工程铁律 👇
划分数据集之前,必须先确认语料有没有某种排列顺序(按字母、按时间、按来源、按采集批次)。有就先打乱,没打乱就等于给自己设了一个不可能达到的指标目标。
五、步骤 4:模型训练
意图:用训练集拟合出特征权重,得到一个能把"特征"翻译成"标签"的模型。
# ===== Cell 6:训练 CRF 模型 =====
import time
import sklearn_crfsuite

t0 = time.time()
model = sklearn_crfsuite.CRF(
    algorithm="lbfgs",               # L-BFGS 拟牛顿法,CRF 训练的标准选择
    c1=0.1,                          # L1 正则:惩罚冗余特征,自动剪枝
    c2=0.1,                          # L2 正则:平滑权重,防过拟合
    max_iterations=100,              # 最大迭代轮数
    all_possible_transitions=False,  # 不穷举所有标签转移组合
)
model.fit([x for x, _ in train_set], [y for _, y in train_set])
cost = time.time() - t0

print(f"训练完成,耗时 {cost:.2f} 秒")
print(f"有效特征数: {model.num_attributes_}")
print(f"模型学到的标签: {model.classes_}")
print(f"特征样例: {list(model.state_features_.items())[:3]}")输出:
训练完成,耗时 0.45 秒
有效特征数: 6282
模型学到的标签: ['B-LOC', 'I-LOC', 'O', 'B-PER', 'I-PER']
特征样例: [(('bias', 'B-LOC'), -0.5951), (('bias', 'I-LOC'), -0.921954), (('bias', 'O'), 1.911465)]结果分析:
- 0.45 秒训练完 2531 句,对比深度模型动辄几十分钟,这是 CRF 的核心优势。
state_features_直接给出了特征权重 ——(('bias','O'), 1.91)表示"倾向判为 O"的偏置最强(因为大部分字确实不是实体)。这就是 CRF 的可解释性,医疗、法律场景能直接拿给业务方看。- 有效特征 6282 个,是
c1正则剪枝后的结果(未剪枝时约 16936 个)。
四个参数的作用:
| 参数 | 作用 | 调大的后果 |
|---|---|---|
algorithm | 优化算法,lbfgs 是 CRF 标配 | 换 ap 更慢但有时更准 |
c1 | L1 正则,惩罚权重绝对值 | 特征压缩更狠,可能欠拟合 |
c2 | L2 正则,惩罚权重平方 | 更平滑,特征保留更多 |
all_possible_transitions | 是否把"不可能的标签转移"也加进特征 | 特征空间爆炸式增长 |
c1 调参实测(同一份数据):
| c1 | 有效特征数 | Precision | Recall | F1 |
|---|---|---|---|---|
| 0.0(无正则) | 16936 | 0.740 | 0.493 | 0.592 |
| 0.05 | 8009 | 0.745 | 0.493 | 0.593 |
| 0.1(推荐) | 6282 | 0.757 | 0.498 | 0.601 |
| 0.3(过强) | 3971 | 0.723 | 0.489 | 0.583 |
特征数从 16936 降到 6282,F1 反而上升 —— 这就是 L1 正则在干的事:剪掉噪声特征,保留有判别力的信号。
六、步骤 5:模型评估
意图:用没参与训练的测试集客观检验效果。必须用实体级口径,token 级指标会骗你。
本节用 seqscore 做评估。选它而不是 seqeval 有三个理由:
| 能力 | seqscore | seqeval |
|---|---|---|
| 实体级 P/R/F1 | ✅ | ✅ |
| 同时给出 token 级准确率 | ✅ 一次调用两个口径 | ❌ 要另写代码 |
| 非法标签转移检测 | ✅ 默认直接报错,可选自动修复 | ⚠️ 仅 warn |
| 标签方案互转(BIO↔BIOES) | ✅ convert 命令 | ❌ |
# ===== Cell 7:模型评估 =====
from seqscore.scoring import score_label_sequences

X_test = [x for x, _ in test_set]
Y_test = [y for _, y in test_set]
y_pred = model.predict(X_test)

# 一次调用同时得到两个口径的指标
cs, acc = score_label_sequences(y_pred, Y_test, "BIO", repair=None)

print("=== token 级准确率 ===")
print(f"{acc.hits}/{acc.total} = {acc.accuracy:.3f}\n")
print("=== 实体级指标 ===")
print(f"Precision {cs.precision:.3f} | Recall {cs.recall:.3f} | F1 {cs.f1:.3f}\n")
print("=== 分类别 ===")
for t, s in cs.type_scores.items():
    print(f"  {t:<6} P={s.precision:.3f} R={s.recall:.3f} F1={s.f1:.3f}"
          f"  (参考={s.total_ref} 预测={s.total_pos} 正确={s.true_pos})")

print("\n=== 有差异的预测样例 ===")
n = 0
for i in range(len(X_test)):
    if y_pred[i] != Y_test[i]:
        chars = [X_test[i][j]["char"] for j in range(len(X_test[i]))]
        print(f"  {''.join(chars)}")
        print(f"    标准 {' '.join(Y_test[i])}")
        print(f"    预测 {' '.join(y_pred[i])}\n")
        n += 1
        if n >= 4:
break输出:
=== token 级准确率 ===
2206/2467 = 0.894

=== 实体级指标 ===
Precision 0.757 | Recall 0.498 | F1 0.601

=== 分类别 ===
  PER    P=0.710 R=0.364 F1=0.481  (参考=121 预测=62 正确=44)
  LOC    P=0.793 R=0.663 F1=0.722  (参考=98 预测=82 正确=65)

=== 有差异的预测样例 ===
  金牌猪手王
    标准 O O O O B-PER
    预测 O O O O O

  乌米倒提粽
    标准 B-PER I-PER O O O
    预测 B-LOC I-LOC O O O

  老妈宫粽球
    标准 O O B-PER O O
    预测 O O O O O

  苔菜油占子
    标准 O O O B-PER I-PER
预测 O O O O O结果分析:
PER 的 Recall 只有 0.36,明显低于 LOC 的 0.66。 看分类别明细更清楚:PER 参考 121 个、只预测 62 个、命中 44 个 —— 是漏得多,不是乱报。
从错误样例能看出原因:金牌猪手王里的"金牌"、老妈宫粽球里的"老妈宫"都是地名/菜名成分,但语料把它们标成了nr(人名)。这类标注本身的模糊性,模型学不会。乌米倒提粽被 PER 误判成 LOC —— 开头"乌米"是浙江地名,模型按字面认成了 LOC。这解释了 PER Precision 为什么也不算高。
汇报 NER 效果必须用实体级 👇
token 级准确率是 0.894,实体级 F1 是 0.601,差了近 0.3。token 级只要"杭""州"两个字标对就算成功,但它完全不管边界对不对、实体有没有拼错。
用错口径汇报,等于自己给自己制造"效果很好"的错觉。
本节小结
| 步骤 | 关键动作 | 实测结果 |
|---|---|---|
| 1 数据准备 | 词性分布统计 | 3164 句;发现 nt 仅 1 次、nz 是菜名 |
| 2 特征工程 | 5 字窗口 + BIO 标签 | 6282 个有效特征;1180 个实体 |
| 3 数据划分 | 先打乱 | 训练 2531 / 测试 633 |
| 4 模型训练 | lbfgs + c1/c2 | 耗时 0.57 秒 |
| 5 模型评估 | seqscore 实体级 | P 0.757 / R 0.498 / F1 0.601 |
三条要记住的经验:
- 先看数据再建模型。
nt只有 1 次、nz是菜名 —— 这两个坑只有统计才能发现。 - 划分前必须打乱。语料有序时,顺序切分能让 F1 从 0.601 掉到 0.383。
- 特征不是越多越好。下一节的对照实验里,加 2000 个特征后 F1 从 0.601 降到 0.570。
8:模型应用与错误分析
模型持久化与实际部署
知识点 6 把模型训练出来了,但模型不能只活在内存里。本知识点讲三件事:怎么把模型存下来复用、怎么用它抽实体、以及它到底做不到什么。
承接知识点 6,代码接着上一个 cell 往下写。
一、模型保存与加载
意图:训练一次要几十秒,但推理可能要做几十万次 —— 模型必须存盘复用。
# ===== Cell 8:模型保存 =====
import os
import joblib

MODEL_PATH = "./tmp/food_ner.pkl"
os.makedirs(os.path.dirname(MODEL_PATH), exist_ok=True)   # 确保目录存在
joblib.dump(model, MODEL_PATH)
print(f"模型已保存: {MODEL_PATH} ({os.path.getsize(MODEL_PATH)/1024:.1f} KB)")输出:
模型已保存: ./tmp/food_ner.pkl (526.9 KB)为什么用 joblib 而不是 pickle:
| 方式 | 特点 | 适用 |
|---|---|---|
pickle | Python 标准库,能存任意对象 | 小对象、临时缓存 |
joblib | 为大对象和 NumPy 数组优化,并行加载更快 | 模型文件,首选 |
527 KB 的模型文件,推理时加载只需几十毫秒。
# ===== Cell 9:加载模型(模拟新会话)=====
model2 = joblib.load(MODEL_PATH)
print(f"模型已加载,标签集合: {model2.classes_}")输出:
模型已加载,标签集合: ['B-LOC', 'I-LOC', 'O', 'B-PER', 'I-PER']工程实践:三个必做的持久化动作 👇
- 同时保存映射表和配置(
POS2TAG、CORPUS_PATH)—— 只存模型半年后没人知道它是怎么训的; - 记录依赖版本(
pip freeze > requirements.txt)—— CRFsuite 大版本升级后模型可能无法加载; - 记录训练时间和指标 —— 换语料重训时要有对比基线。
二、实体抽取:从标签还原成词
意图:CRF 输出的是每个字的标签,但业务需要的是"杭州是 LOC"这样的实体列表。
# ===== Cell 10:标签序列 → 实体列表 =====
def extract_entities(text, tags):
    """
    BIO 标签还原成 [(实体文本, 类型), ...]
    规则:一个实体 = 一个 B + 后面紧挨的同类型 I,遇到 O 或新 B 就结束
    """
    entities, start, etype = [], None, None
    for i, (ch, tag) in enumerate(zip(text, tags)):
        if tag.startswith("B-"):
            if start is not None:                  # 先结算上一个实体
                entities.append((text[start:i], etype))
            start, etype = i, tag[2:]             # 开启新实体
        elif tag.startswith("I-"):
            if start is None:                     # 孤立的 I- 当新实体起点
                start, etype = i, tag[2:]
        else:                                     # 遇到 O,实体闭合
            if start is not None:
                entities.append((text[start:i], etype))
                start, etype = None, None
    if start is not None:                         # 收尾:实体在句尾结束
        entities.append((text[start:], etype))
    return entities


# ===== Cell 11:在真实文本上应用 =====
test_texts = [
    "在浙江杭州,人们喜爱品尝东坡肉以及西湖醋鱼。",
    "在广东潮汕,人们喜爱吃牛肉火锅,美味可口。",
    "北京大学 student 张三 在上海工作。",
]

print("=== 新文本实体抽取 ===")
for text in test_texts:
    tags = model2.predict([build_features(list(text))])[0]
    print(f"原文: {text}")
    print(f"标签: {' '.join(tags)}")
print(f"实体: {extract_entities(text, tags)}\n")输出:
=== 新文本实体抽取 ===
原文: 在浙江杭州,人们喜爱品尝东坡肉以及西湖醋鱼。
标签: O O O B-LOC I-LOC O O O O O O O O O O O B-LOC I-LOC O O O
实体: [('杭州', 'LOC'), ('西湖', 'LOC')]

原文: 在广东潮汕,人们喜爱吃牛肉火锅,美味可口。
标签: O O O O O O O O O O O O O O O O O O O O O
实体: []

原文: 北京大学 student 张三 在上海工作。
标签: B-LOC I-LOC O O O O O O O O O O O B-PER I-PER O O B-LOC I-LOC O O O
实体: [('北京', 'LOC'), ('张三', 'PER'), ('上海', 'LOC')]
三、错误分析:看清 CRF 的能力边界
只看 F1 数字不够,得逐条看错在哪。下面三个失败案例,每一个都指向不同的原因。
案例 1:「浙江杭州」只抽出「杭州」—— 边界判断错误
原文: 在浙江杭州,人们喜爱品尝东坡肉以及西湖醋鱼。
标签: O O O B-LOC I-LOC ...
实体: [('杭州', 'LOC'), ...]
↑ 「浙」被判成了 O,本该是 B-LOC原因:CRF 在"浙"和"杭"之间做了个错误判断。中文地名的边界需要理解"浙江"和"杭州"是两个并列的行政单位,但字符级 CRF 只能看到 prev|cur = "在|浙"、cur|next = "浙|杭" 这类表面信号。
解法:词级标注、或引入词典特征、或换 BERT
案例 2:「广东潮汕」完全抽不出来 —— 未登录实体
原文: 在广东潮汕,人们喜爱吃牛肉火锅,美味可口。
标签: O O O O O O O O O O O O O O O O O O O O O
实体: []原因:"潮汕"在 3164 句训练语料里一次都没出现过。CRF 的特征来自字符共现规律,没见过就是没见过。
这是 CRF 的硬伤:无法处理开放词汇
对比看第三句:北京大学 student 张三 在上海工作。 —— "张三"和"上海"都在训练集里高频出现,全部识别正确。
案例 3:人名识别率低 —— 标注数据本身的问题
回到知识点 6 的错误样例:
| 测试样本 | 标准答案 | 模型预测 | 问题 |
|---|---|---|---|
金牌猪手王 | 末尾 B-PER | 全 O | 漏检 |
老妈宫粽球 | 中间 B-PER | 全 O | 漏检 |
苔菜油占子 | 末尾 B-PER I-PER | 全 O | 漏检 |
乌米倒提粽 | B-PER I-PER | B-LOC I-LOC | 类型误判 |
原因:这些"人名"(金牌、老妈宫、苔菜、乌米)本质是地名或菜名成分,是标注者把它们归到了 nr(人名)类。
这不是模型的问题,是标注数据的问题 —— 模型忠实学习了标注规范,包括规范里的模糊之处。
四、对照实验:特征数量与 F1 的关系
意图:验证"特征越多效果越好"这个想当然的假设。
# ===== Cell 12:对照组 —— 关掉 L1 正则 =====
model_nol1 = sklearn_crfsuite.CRF(
    algorithm="lbfgs",
    c1=0.0,                          # 关掉 L1 正则,不做任何剪枝
    c2=0.1,
    max_iterations=100,
    all_possible_transitions=False,
)
model_nol1.fit([x for x, _ in train_set], [y for _, y in train_set])

yp_nol1 = model_nol1.predict(X_test)
cs_nol1, _ = score_label_sequences(yp_nol1, Y_test, "BIO", repair=None)

print("=== L1 正则对特征数与 F1 的影响 ===")
print(f"c1=0.0(不剪枝): {model_nol1.num_attributes_} 个特征 -> F1 = {cs_nol1.f1:.3f}")
print(f"c1=0.1(剪枝)  : {model.num_attributes_} 个特征 -> F1 = {cs.f1:.3f}")
print(f"特征少了 {model_nol1.num_attributes_ - model.num_attributes_} 个,F1 反而更高")输出:
=== L1 正则对特征数与 F1 的影响 ===
c1=0.0(不剪枝): 16936 个特征 -> F1 = 0.592
c1=0.1(剪枝)  : 6282 个特征 -> F1 = 0.601
特征少了 10654 个,F1 反而更高这就是"特征不是越多越好"的实证:剪掉 10654 个低判别力特征,F1 反而提升了 0.009。
更有意思的现象:加了特征,模型却没要
# ===== Cell 13:追加新特征试试 =====
def build_features_v2(chars):
    """在基础特征上追加字符类别和边界标记"""
    seq = ["<BOS>"] + list(chars) + ["<EOS>"]
    base = build_features(chars)          # 复用基础特征
    feats = []
    for i in range(1, len(seq) - 1):
        f = dict(base[i - 1])
        f["char.is_vowel"] = seq[i] in "aeiouv"              # 字符类别特征
        f["is_sent_edge"] = (i == 1 or i == len(seq) - 2)    # 是否在句首句尾
        feats.append(f)
    return feats


X_v2 = [build_features_v2(chars) for chars in corpus.word_seqs]
model_v2 = sklearn_crfsuite.CRF(
    algorithm="lbfgs", c1=0.1, c2=0.1, max_iterations=100,
    all_possible_transitions=False)
model_v2.fit([x for x, _ in train_set], [y for _, y in train_set])
yp_v2 = model_v2.predict(X_test)
cs_v2, _ = score_label_sequences(yp_v2, Y_test, "BIO", repair=None)

print("=== 追加特征的结果 ===")
print(f"原始 9 特征 ({model.num_attributes_} 个) -> F1 = {cs.f1:.3f}")
print(f"追加后 11 特征({model_v2.num_attributes_} 个) -> F1 = {cs_v2.f1:.3f}")输出:
=== 追加特征的结果 ===
原始 9 特征 (6282 个) -> F1 = 0.601
追加后 11 特征(6282 个) -> F1 = 0.601
特征数一个都没多,F1 也完全没变。 原因是 L1 正则把这些新特征全部剪掉了 —— L1 的工作方式就是"如果这个特征对降低损失没帮助,就让它的权重精确等于 0"。
这个结果比"加特征变差"更有价值 👇
它说明了两件事:
- L1 正则在自动做特征选择 —— 你加了新特征,它评估后判定"没用",直接丢弃;
- 判断特征有没有用,不该看"加了多少",而该看"模型留了多少"。
如果强行把 c1 设为 0 让这些特征保留下来,F1 会因为噪声过多而下降(对照 Cell 12:c1=0 时只有 0.592)。
结论:中文 NER 里,领域词典和高质量标注的收益远大于堆特征。与其花时间想新特征,不如去核对标注质量。