第4 讲 中文分词
第4 讲 中文分词
学完本讲,你应该能够:
知识目标
- 了解中文分词的基本概念和中文分词面临的主要难点。
- 熟悉基于规则分词的基本原理和常用方法(正向/逆向/双向最大匹配)。
- 掌握基于统计分词的基本原理,理解 HMM 模型与维特比算法在分词中的作用。
- 了解基于深度学习的分词技术及行业发展趋势。
能力目标
- 能独立实现正向最大匹配、逆向最大匹配、双向最大匹配三种规则分词算法。
- 能读懂并动手实现基于 HMM + 维特比算法的分词程序。
- 能熟练使用 jieba 库完成分词、词频统计、关键词提取等任务。
- 能把分词应用到真实文本处理场景(评论分析、特征提取)中。
先修知识:Python 基础、概率统计基础(条件概率、马尔可夫链)、了解神经网络基本概念。
本讲内容取舍
本讲讲三类分词方法:
规则分词(理解分词难点的引子)、
统计分词 HMM(重点)、
深度学习 BiLSTM(重点)。
当前工业界主流是预训练大模型分词,BiLSTM 是理解序列标注的入门架构,必须掌握。jieba 因轻量高效在实际项目中广泛使用。
1:中文分词基础与规则分词
前言
1 概念与难点
引入:你在搜索引擎里输入 "北京市民办高中",引擎需要先判断你说的是"北京市 / 民办高中"还是"北京市民 / 办高中" ——这一步判断就是中文分词。英文天然用空格分隔词语,中文没有,所以分词是所有中文 NLP 任务的第一步。
中文分词(Chinese Word Segmentation)是把连续的中文文本序列,按一定的语义和语法规则,切割成具有独立意义的词语序列的过程。
核心难点:
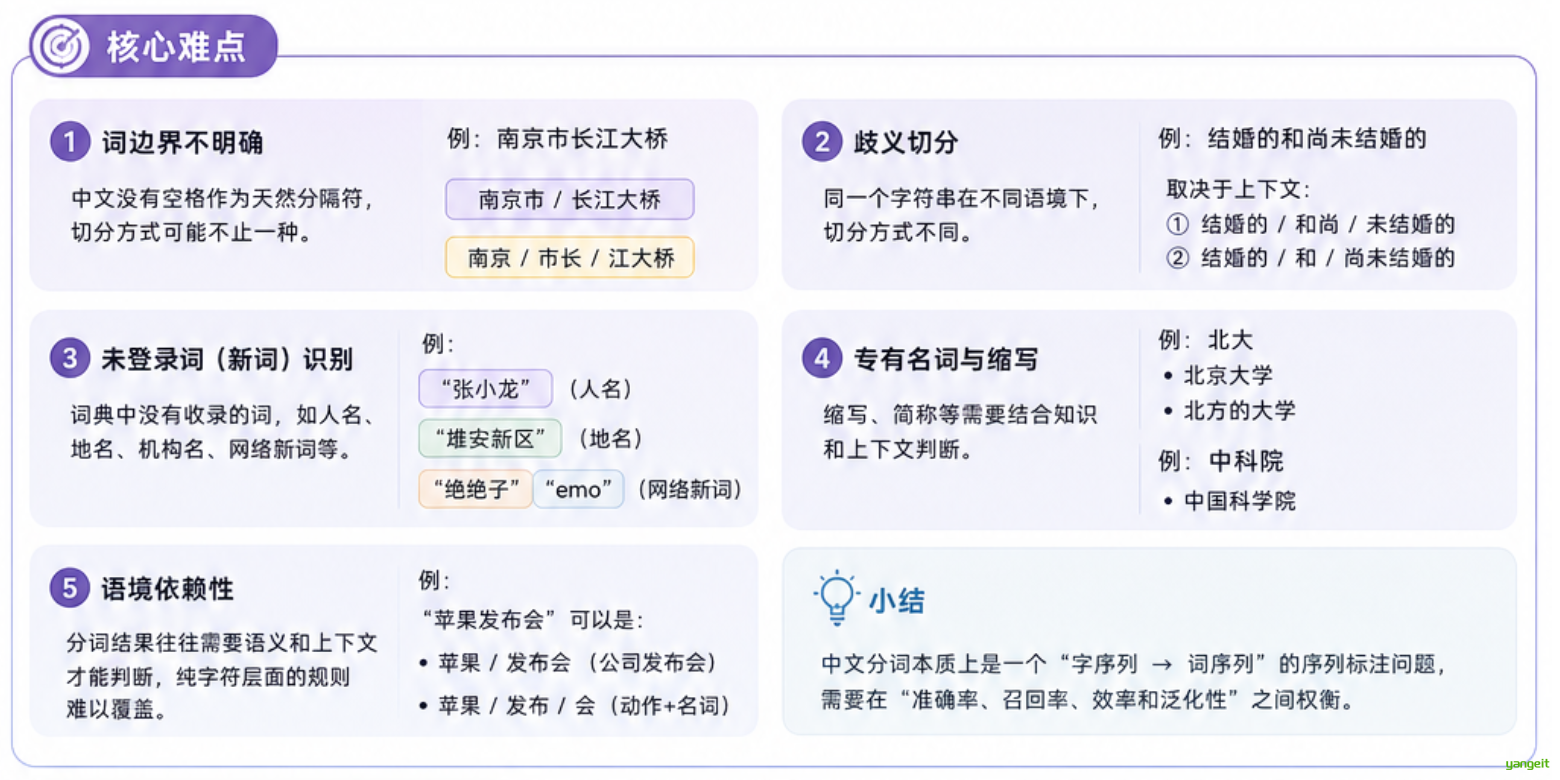
- 词边界不明确:"南京市长江大桥" 可以切为 "南京市 / 长江大桥",也可以切为 "南京 / 市长 / 江大桥"。
- 歧义切分:同一个字符串在不同语境下切分方式不同。如"结婚的和尚未结婚的"中,"和"与"尚"是否组成词"和尚",取决于上下文。
- 未登录词(新词)识别:词典中没有收录的词,如人名、地名、机构名、网络新词("绝绝子""emo")等。
- 专有名词与缩写:"北大"可以指北京大学,也可以指"北方的大学";"中科院"是"中国科学院"的缩写。
- 语境依赖性:分词结果往往需要语义和上下文才能判断,纯字符层面的规则难以覆盖。
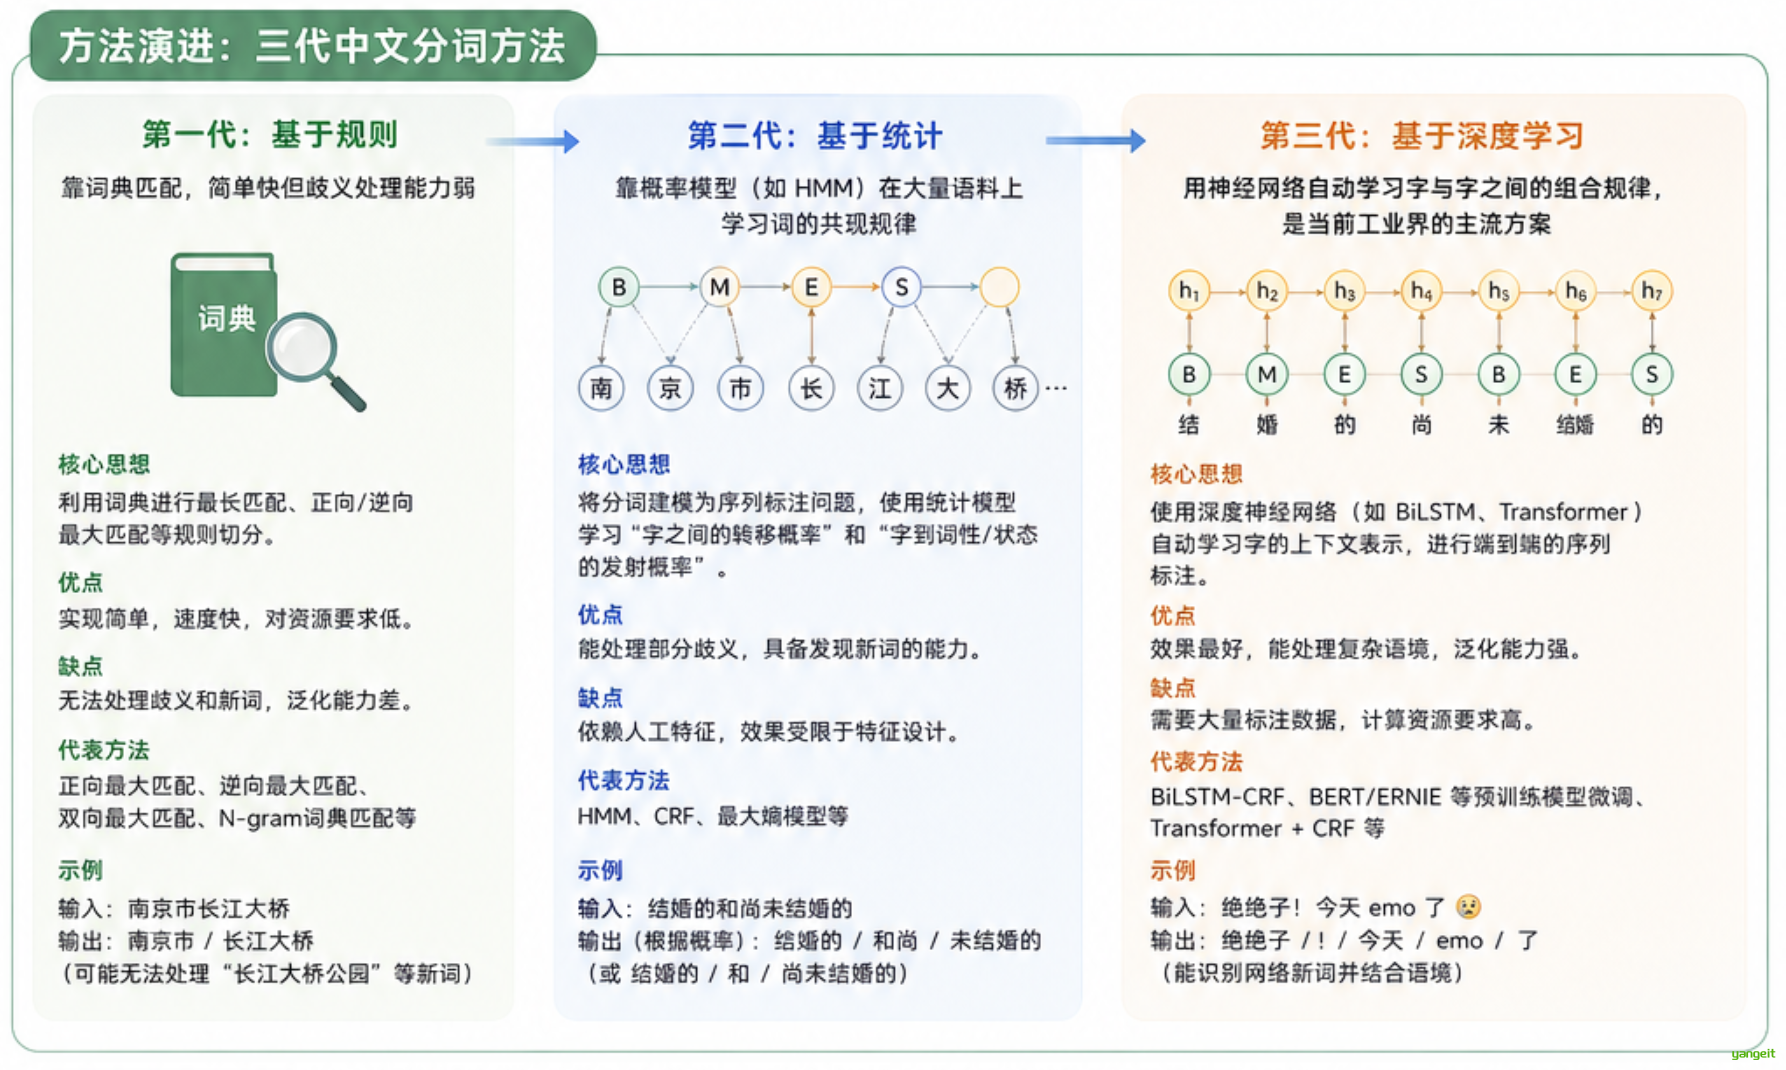
三代方法演进:
| 范式 | 核心思路 | 代表方法 | 短板 |
|---|---|---|---|
| 基于规则 | 词典匹配 | 正向/逆向/双向最大匹配 | 无法利用上下文,歧义处理弱 |
| 基于统计 | 从语料学概率 | HMM、CRF、n-gram | 一阶马尔可夫假设限制上下文长度 |
| 基于深度学习 | 神经网络自动学特征 | BiLSTM、Transformer、BERT | 需要大量标注数据 |
特点与适用场景:
- 分词质量直接影响下游任务(情感分析、机器翻译、信息检索)的效果;
- 简单场景(关键词提取、词云生成),jieba 等工具已足够;
- 高精度场景(医疗、法律文本),需要在领域语料上微调深度学习模型。
2 代码实操
业务场景:用三种最大匹配策略对"北京市民办高中"分词,直观感受规则方法的局限性。
1️⃣ 正向最大匹配(FMM):从左往右贪心,每次取能匹配上的最长词。
# ======正向最大匹配 ==========
dictionary = ['北京市', '北京市民', '民办高中', '天安门广场', '高中']
text = '北京市民办高中'

def forward_maximum_matching(text, dictionary):
    """正向最大匹配:从左向右,每次贪心取最长的匹配词"""
    max_word_length = max(len(w) for w in dictionary)  # 词典中最长词的长度
    result = []
    while text:
        # 从最大长度开始逐个缩短,找到第一个在词典中的词
        for i in range(min(max_word_length, len(text)), 0, -1):
            word = text[:i]
            if word in dictionary:
                result.append(word)
                text = text[i:]
                break
        else:
            # 一个字都匹配不上(未登录字),强制输出单字
            result.append(text[0])
            text = text[1:]
    return result

print("正向最大匹配:", forward_maximum_matching(text, dictionary))
运行结果:
正向最大匹配: ['北京市民', '办', '高中']分析:正向最大匹配在词典中找到了"北京市民",但后续的"办"和"高中"没有匹配上,所以被强制切分成了单字。
易错点: 不要用词典大小近似最大词长
常见错误写法是 max_word_length = min(text_length, len(dictionary)),即用"词典里有多少个词"来近似"最长词有多少字"。本例中词典有 5 个词、最长词"天安门广场"也是 5 字,碰巧两者相等所以结果正确;一旦词典换成 100 个短词,这个写法就会漏掉长词,导致匹配错误。始终用 max(len(w) for w in dictionary)。
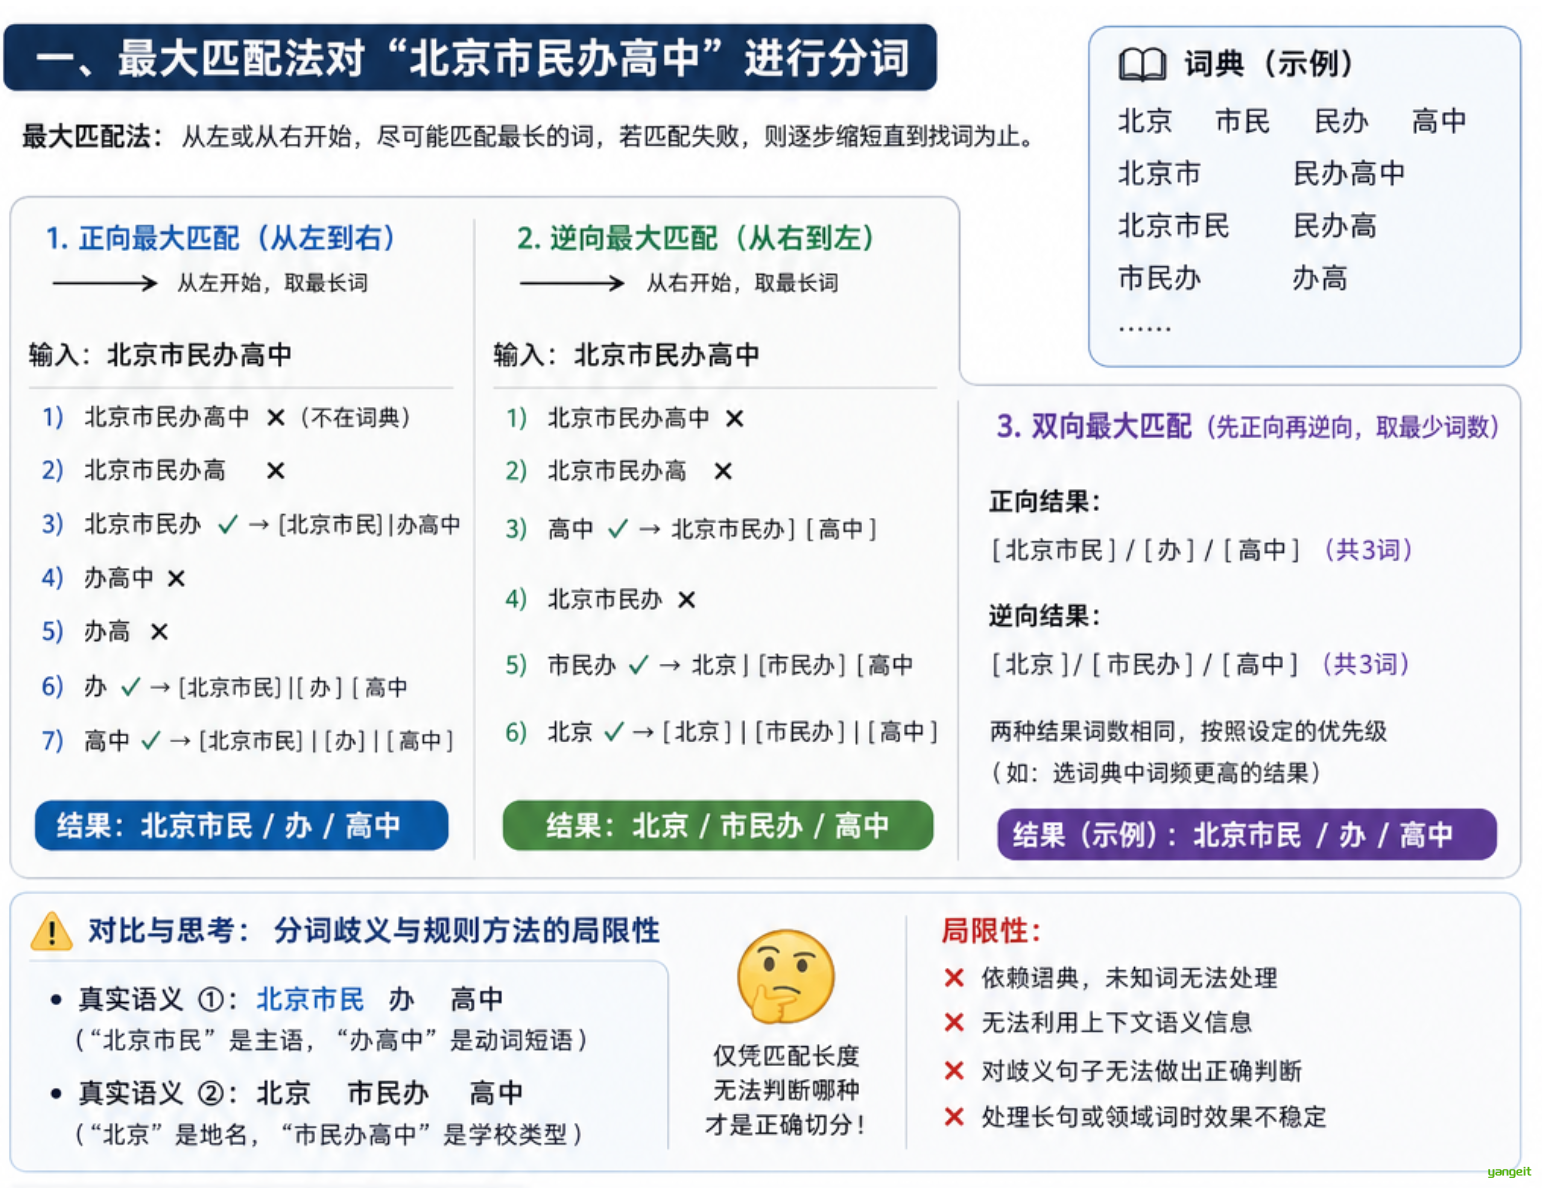
2️⃣ 逆向最大匹配(BMM):从右往左贪心,优先让后边的词成词。
# ========== 逆向最大匹配 ==========
def backward_maximum_matching(text, dictionary):
    """逆向最大匹配:从右向左,每次贪心取最长的匹配词"""
    max_word_length = max(len(w) for w in dictionary)
    result = []
    while text:
        for i in range(min(max_word_length, len(text)), 0, -1):
            word = text[-i:]
            if word in dictionary:
                result.insert(0, word)   # 从后往前切,所以插到头部
                text = text[:-i]
                break
        else:
            result.insert(0, text[-1])
            text = text[:-1]
    return result

print("逆向最大匹配:", backward_maximum_matching(text, dictionary))运行结果(已实机验证):
逆向最大匹配: ['北京市', '民办高中']3️⃣ 双向最大匹配(BiMM):同时算正向和逆向结果,按启发式规则选优。
# ========== 双向最大匹配 ==========
def bidirectional_maximum_matching(text, dictionary):
    """双向最大匹配:对比正逆向结果,按启发式规则择优"""
    forward_result = forward_maximum_matching(text, dictionary)
    backward_result = backward_maximum_matching(text, dictionary)


    # 规则 1:词数少的更优(分词数少说明平均词长更长,更符合自然语言)
    if len(forward_result) != len(backward_result):
        return forward_result if len(forward_result) < len(backward_result) else backward_result

    # 规则 2:词数相同,单字词少的更优(单字过多通常是切错的信号)
    f_single = sum(1 for w in forward_result if len(w) == 1) # 统计正向结果中单字词的个数
    b_single = sum(1 for w in backward_result if len(w) == 1)
    if f_single != b_single:
        return forward_result if f_single < b_single else backward_result # 单字词少更优

    # 规则 3:完全打平时,取逆向结果(这是业界常用约定)
    return backward_result

print("双向最大匹配:", bidirectional_maximum_matching(text, dictionary))运行结果:👇
双向最大匹配: ['北京市', '民办高中']结果分析:
- 正向匹配错了:从左往右贪心,先匹配到"北京市民"(4 个字),剩下"办高中"只能切成"办"+"高中",多出一个无意义的单字"办"。
- 逆向匹配对了:从右往左先匹配"民办高中",剩下"北京市"也在词典里,2 个词全部成词。
- 双向匹配靠"词数少者优先"纠正了正向的错误(2 个词 vs 3 个词)。
关键观察:把词典里的"北京市民"删掉再跑一次,正向匹配也会得到 ['北京市', '民办高中']。这说明规则分词的效果高度依赖词典质量,且无法从根本上解决歧义。
易错点小结:
- 词典长度的取值方式(见上方 warning)。
- 文本含未登录字时,最大匹配会强制输出单字,产生碎片。
- 双向匹配的两条启发式规则并非总是正确,只是统计意义上的经验法则。
过渡
规则分词的核心瓶颈是无法利用上下文和统计规律来消除歧义。HMM 通过在大规模语料上学习字与字之间的概率关系,正是来解决这个问题。
2:HMM 与维特比算法
HMM 与维特比算法
1 概念与原理
引入:规则分词靠"词典里有没有这个词"判断切分,但"北京市民"和"北京市"都在词典里,规则方法无法判断哪个更合理。
HMM 的思路:把分词看成给每个字打标签的过程 —— 每个字标注为词首 (B)、词中 (M)、词尾 (E) 或单字成词 (S),然后通过概率模型找到"最可能的标签序列"。
隐马尔可夫模型(Hidden Markov Model, HMM)是一种统计模型,用于描述一个含有隐含未知参数的马尔可夫过程。
马尔可夫过程是一类“无记忆”的随机过程,其未来状态仅依赖于当前状态,而与过去状态无关。
在中文分词中,观测序列是句子中的每个字,隐藏状态序列是每个字对应的 B/M/E/S 标签,分词就是根据观测序列推断最可能的隐藏状态序列。
B/M/E/S 四标签体系:
| 标签 | 全称 | 含义 |
|---|---|---|
| B | Begin | 词的第一个字 |
| M | Middle | 词的中间字(只在长度 ≥ 3 的词中出现) |
| E | End | 词的最后一个字 |
| S | Single | 单字独立成词 |
例如"我爱中国"的标注为 我/S 爱/S 中/B 国/E,对应分词结果"我 / 爱 / 中国"。
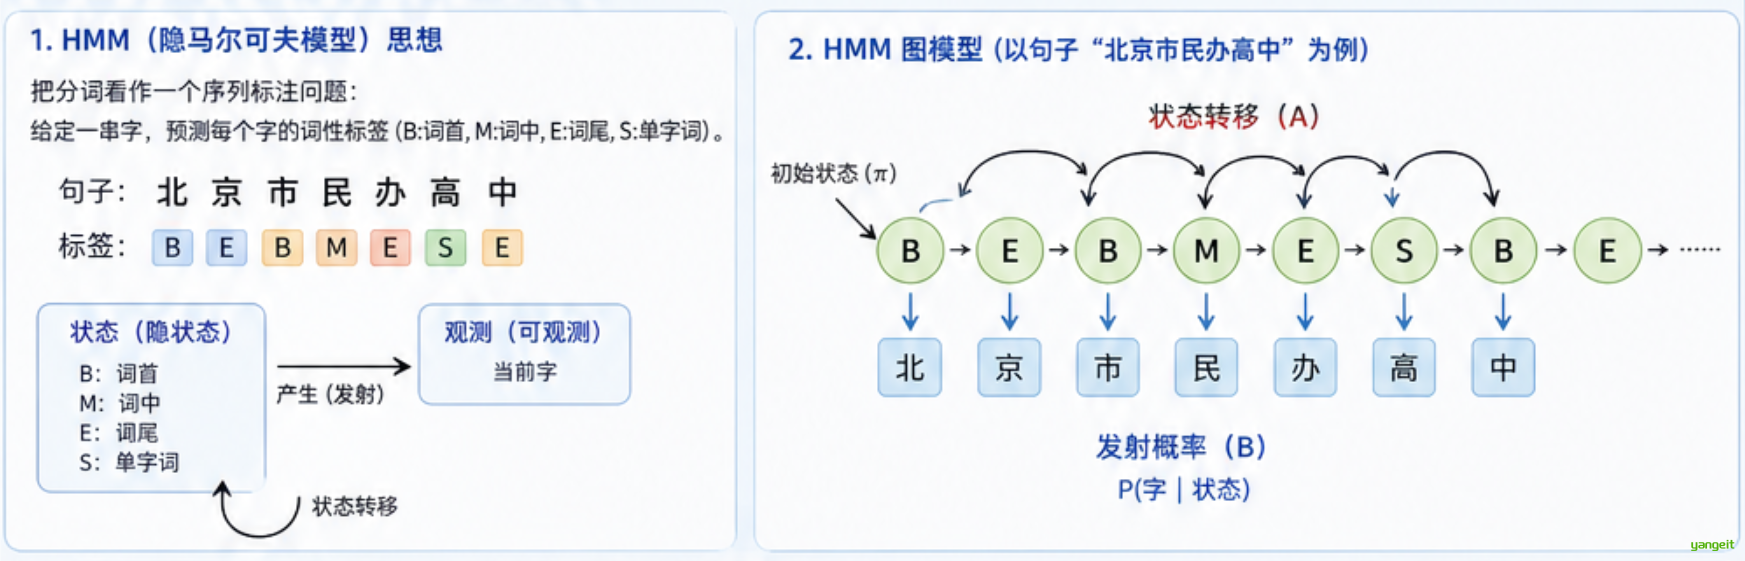
用中文分词场景(B/M/E/S标签)讲清楚三个概率
隐状态 = 标签:B(词首)、M(词中)、E(词尾)、S(单字成词)
观测 = 我们看到的汉字:我、爱、中、国、人
1️⃣ 初始概率 start_prob(π)
含义:一句话的第一个字,它的隐状态(标签)是什么的概率。
也就是句子开头,第一个字符的标签分布。
start_prob = {'B': 0.5, 'M': 0.0, 'E': 0.0, 'S': 0.5}- 句子第一个字是 B(词开头):概率0.5
- 句子第一个字是 S(单独一个词):概率0.5
- 句子第一个字不可能是M(词中间)或者E(词结尾),所以概率=0
一句话开头,不可能是一个词语的中间或者末尾,所以M、E是0,符合常识。
✅ 只作用在句子第1个字,后面的字不用这个。
2️⃣ 状态转移概率 trans_prob,A
全称:状态c概率
含义:前一个字的标签,跳到下一个字标签的概率。
描述标签和标签之间怎么连续变化。
'B': {'B': 0.1, 'M': 0.3, 'E': 0.5, 'S': 0.1}意思:上一个标签是B(词首)的时候
- 下一个标签是B:0.1
- 下一个标签是M:0.3
- 下一个标签是E:0.5(B后面接E,就是二字词,比如“中国”,最常见)
- 下一个标签是S:0.1
规则常识:
M是词中间,M后面不能再出现B,所以 'M': {'B':0.0,...}
✅ 对应 HMM 的【齐次马尔可夫假设】:下一个标签只由前一个标签决定。
3️⃣ 发射概率 emit_prob
含义:给定某个标签,“生成/发射”出某个汉字的概率。
标签(隐状态)吐出我们看得见的汉字。
'E': {'我': 0.0, '爱': 0.0, '中': 0.1, '国': 0.8, '人': 0.1}意思:如果当前标签是E(词尾)
- 这个字是“国”的概率0.8 → 说明“国”经常作为词语最后一个字
- E标签几乎不会生成“我”、“爱”,概率0
✅ 对应 HMM【观测独立性假设】:当前汉字,只由当前这个标签决定,和别的标签无关。
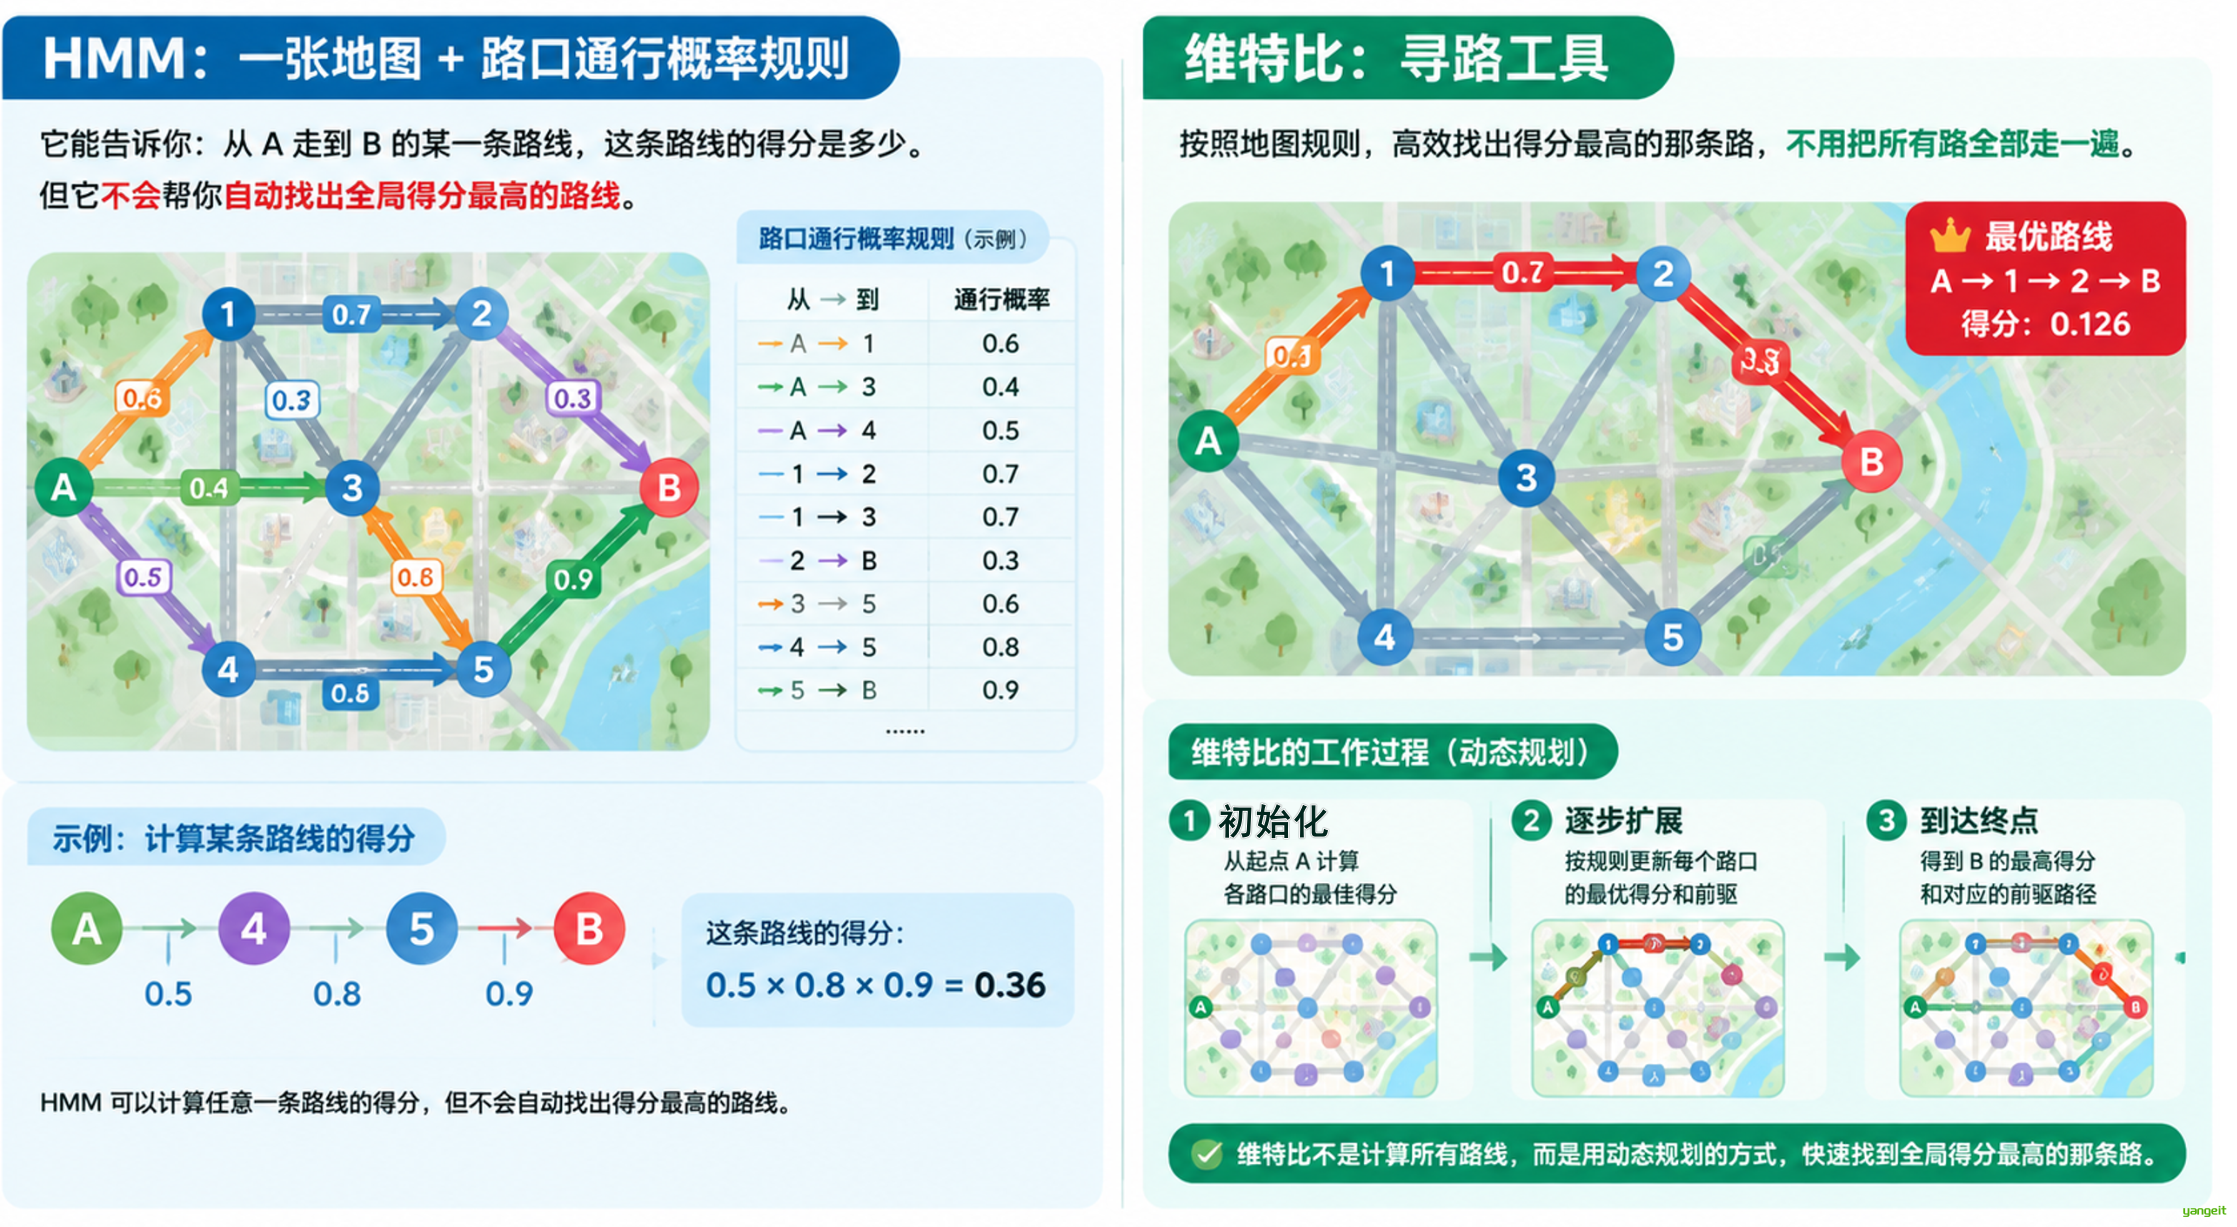
生活化比喻
想象有个写句子的机器人:
- 初始概率:机器人写第一个字,选择标签的概率。一上来,要么准备开始一个新词B,要么直接写一个单字S,不会直接写词中间M、词尾E。
- 跳转概率:写完一个字,决定下一个用什么标签。
如果刚才是词首B,那么下一个大概率选E结束这个词。 - 发射概率:选定标签之后,挑一个汉字写出来。
如果选标签E(词尾),机器人很大概率写出“国”这个字。
HMM 分词本质 :把分词变成给每个汉字打 B/M/E/S 标签。
维特比算法核心思想:用动态规划求概率最大路径。定义 为时刻 结束于状态 的所有路径中的最大概率,递推式:
其中 是状态转移概率, 是发射概率。同时记录每个 来自哪个前序状态 ,最后回溯得到完整路径。
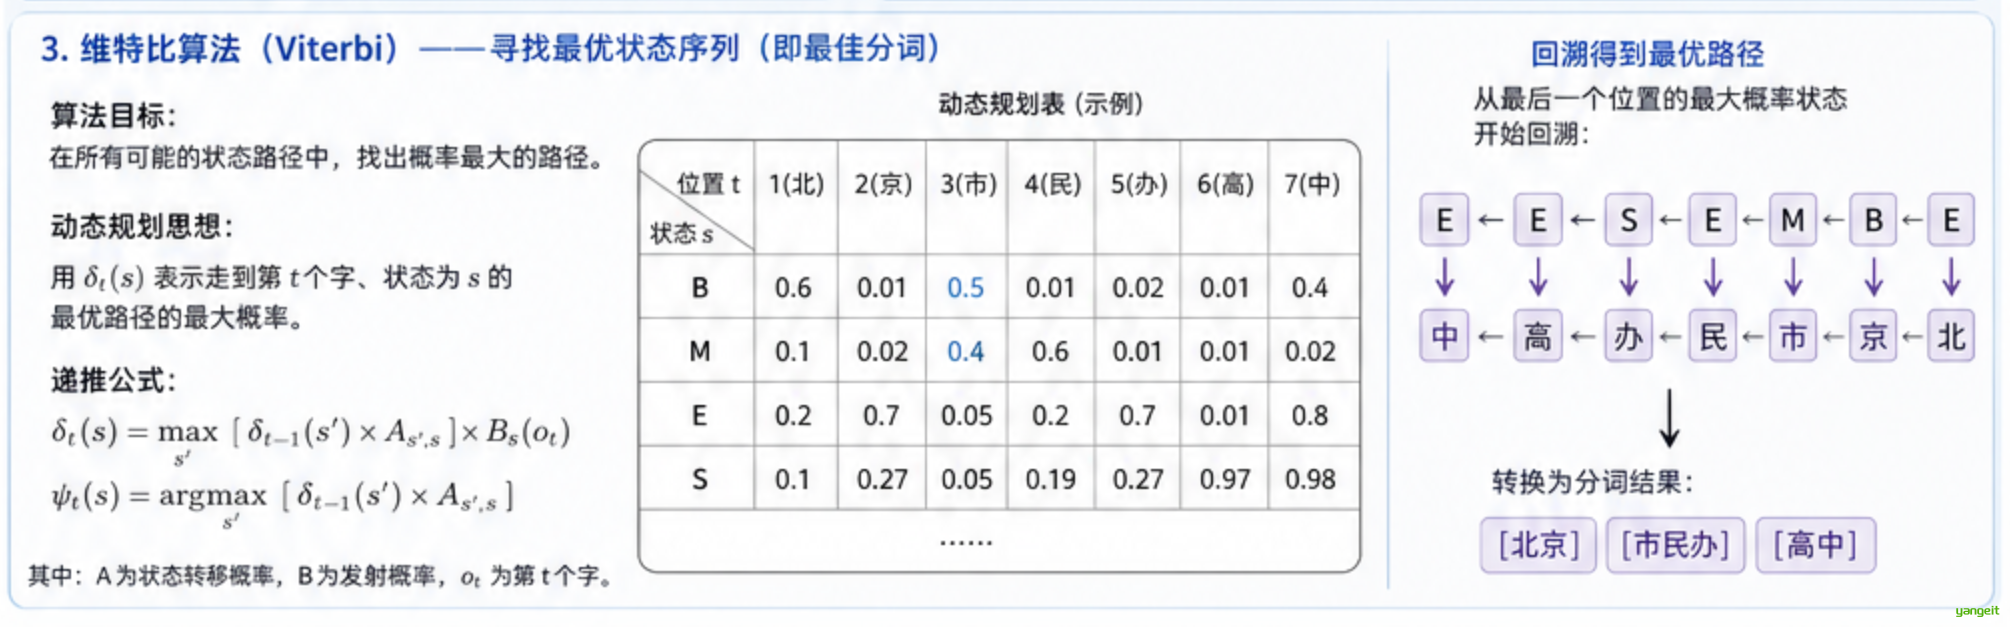
生活类比:👇👇👇👇
特点与适用场景:
- 优点:模型简单、训练快、可解释性强,小数据集上也能工作;
- 局限:马尔可夫假设让它只能利用前一个字的信息,无法建模长距离依赖;发射概率对未登录字处理能力弱;
- 场景:资源受限的嵌入式设备、教学入门、作为 CRF / BiLSTM-CRF 的对比基线;
- 与规则分词的区别:规则靠词典匹配,HMM 靠概率统计,能处理词典中没有的词和部分歧义。
过渡

HMM 解决了规则分词的歧义问题,但马尔可夫假设让它只能利用前一个字的信息。实际工程中你不需要自己实现 HMM —— jieba 已经把规则、统计和工程优化打包好了。
3:jieba 分词与高频词提取
jieba 分词
1 概念与原理
引入:实际项目中你几乎不会自己写分词算法 —jieba 是 Python 生态中最流行的中文分词库,GitHub 星标超 30k。
定义:jieba 是一个开源的中文分词工具,结合了基于前缀词典的规则匹配和基于 HMM 的未登录词识别,通过高效的前缀字典树(Trie)和动态规划实现快速分词。
jieba 核心算法:
- 基于前缀词典:把词典构建成前缀字典树(Trie),高效查找一个词是否在词典中,并生成所有可能的切分方式(DAG,有向无环图)。
- 动态规划 + 词频:在 DAG 上用动态规划查找最大概率路径,得到精确模式的结果。
- HMM 模型:对词典中没有的词(未登录词),用内置的 BMES 标注 HMM 模型配合维特比算法识别新词。
- 用户自定义词典:支持加载自定义词典,补充领域专有名词。
三种分词模式:
| 模式 | API | 行为 | 适用场景 |
|---|---|---|---|
| 精确模式 | cut_all=False(默认) | 切出唯一的最优解,不产生冗余 | 文本分析,最常用 |
| 全模式 | cut_all=True | 把所有能成词的部分都扫出来 | 极快扫描,能容忍冗余 |
| 搜索引擎模式 | cut_for_search() | 精确模式基础上,对长词再切一次 | 搜索索引,提升召回率 |
特点与适用场景:
- 优点:开箱即用、速度快(毫秒级)、支持自定义词典、支持简体和繁体分词、社区活跃;
- 局限:对领域专有名词仍需自定义词典,分词精度不如在领域语料上微调的深度学习模型;
- 场景:关键词提取、词云生成、文本分类预处理、搜索引擎索引、快速原型;
- 与 HMM 的关系:jieba 内部就用了 HMM 处理未登录词,是知识点 2 的工程化封装。
2 代码实操
业务场景一:三种模式对比
# ========== jieba 三种分词模式 ==========
import jieba

text = '中文分词是NLP的一部分!

# 全模式:把所有可能成词的都切出来,速度快但有冗余
print('全模式:', '/ '.join(jieba.cut(text, cut_all=True)))

# 精确模式:最常用,输出唯一的最优切分结果
print('精确模式:', '/ '.join(jieba.cut(text, cut_all=False)))

# 搜索引擎模式:在精确模式基础上对长词再切分,提高召回率
print('搜索引擎模式:', '/ '.join(jieba.cut_for_search(text)))运行结果:
全模式: 中文/ 分词/ 是/ NLP/ 的/ 一部/ 一部分/ 部分/ !
精确模式: 中文/ 分词/ 是/ NLP/ 的/ 一部分/ !
搜索引擎模式: 中文/ 分词/ 是/ NLP/ 的/ 一部/ 部分/ 一部分/ !结果分析:
- 全模式把"一部分"同时切成"一部""一部分""部分"三个词,冗余明显 —— 它不做消歧,只要在词典中能匹配到就输出。
- 精确模式只输出"一部分",是最合理的切分,适合绝大多数文本分析场景。
- 搜索引擎模式额外拆出"一部"和"部分",用户搜任何一个词都能命中这篇文档,提升召回率。
- 选型建议:日常开发默认精确模式;全模式只在极端追求速度且能容忍冗余时用;搜索引擎模式专门用于构建搜索索引。
业务场景二:新闻文本高频词提取
完整预处理 pipeline:读取文本 → 分词 → 去停用词 → 统计词频 → 排序取 TopN。
# ========== 提取新闻文本的高频词 ==========
import re
from collections import Counter
import jieba

def load_file(path):
    """读取文本文件,拼接为一个完整字符串"""
    with open(path, 'r', encoding='utf-8', errors='ignore') as f:
        return ''.join(line.strip() for line in f)

def load_stop_words(path):
    """加载停用词表"""
    with open(path, 'r', encoding='utf-8') as f:
        return {line.strip() for line in f if line.strip()}

def extract_keywords(text, stop_words, topn=10):
    """分词 → 过滤停用词和标点 → 统计词频 → 取 TopN"""
    # 第一步:正则去掉标点符号,避免标点被当成"词"统计进来
    text = re.sub(r'[^\u4e00-\u9fa5A-Za-z0-9]', ' ', text)
    # 第二步:jieba 精确模式分词
    words = jieba.cut(text)
    # 第三步:过滤停用词和纯空格
    words = [w for w in words if w.strip() and w.lower() not in stop_words]
    # 第四步:Counter 统计词频,most_common 取前 topn 个
    return Counter(words).most_common(topn)

# ==== 主流程 ====
content = load_file('./data/news.txt')          # 新闻文本路径
stop_words = load_stop_words('./data/stopword.txt')  # 停用词表路径

print('样本分词效果:', ' / '.join(jieba.cut(content))[:200], '...')
print('样本前10个高频词:', extract_keywords(content, stop_words, 10))运行结果(依赖 quantum.txt 和 stopword.txt,下面是实际输出格式示例):
样本分词效果: 先天性 / 心脏病 / “ / 几岁 / 可 / 根治 / , / 十几岁 / 变 / 难治 / , / 几十岁 / 成不治 / ” / , / 中国 / 著名 / 心血管 / 学术 / 领袖 / 胡大一 / 今天 / 在 / 此间 / 表示 / 救治 / 心脏病 / 应从 / 儿童 / 抓起 / , / 他 / 呼吁 / 社会各界 / 关心 / 贫困地区 / 的 / 先天性 / 心脏病 / 儿童 ...
样本前10个高频词: [('心脏病', 6), ('胡大一', 6), ('中国', 5), ('儿童', 5), ('先天性', 4), ('专家', 4), ('主任委员', 4), ('心血管', 3), ('贫困地区', 3), ('工程', 3)]结果分析:
- 整个流程是文本分析的标准 pipeline:读取文本 → 分词 → 去停用词 → 统计词频 → 排序输出。
- 停用词过滤是关键。不过滤的话,"的""了""是"这类功能词会占据高频榜前列。
- 用
Counter比手写字典更简洁:Counter(words).most_common(n)等价于"统计计数 + 排序取前 n"。 - 正则清洗标点也是必要步骤,否则逗号句号会被当作高频"词"。
易错点小结:
- 停用词文件编码必须指定
encoding='utf-8',否则 Windows 上可能因默认编码(GBK)导致乱码。 jieba.cut()返回的是生成器,不能反复遍历,需要list()转换或一次性消费。- 文件路径用相对路径时,运行的工作目录必须与代码所在目录匹配,否则报
FileNotFoundError。工程上建议用os.path基于__file__构建绝对路径。 - 数字和字母的过滤规则要自己定:本例保留了纯数字和英文单词,情感分析等场景通常还要过滤纯数字。
过渡
jieba 足够应对 80% 的中文分词场景,但在医疗、法律等高精度场景或需要端到端优化的任务中,深度学习模型效果更好。
4:BiLSTM 深度学习分词
前言
1 概念与原理
引入:HMM 的马尔可夫假设让它只能看到"前一个字",而中文分词往往需要更长上下文 —— 比如"南京市长江大桥"中,"长江大桥"是否成词需要看到后面的字。
定义:BiLSTM 分词把分词转化为字级序列标注问题(B/I/O/S 或 B/M/E/S 标签),用双向 LSTM 自动学习每个字的上下文表示,再通过全连接层预测每个字的标签,最后根据标签还原分词结果。
核心概念:
| 概念 | 说明 |
|---|---|
| 序列标注范式 | 和 HMM 一样,深度学习分词也是给每个字打标签。常用 BIO 体系:B=词首、I=词内、O=填充/无效、S=单字词 |
| LSTM | 特殊的 RNN,通过输入门、遗忘门、输出门三个门控机制缓解长距离依赖消失 |
| BiLSTM | 一个 LSTM 从左到右(得上文),一个从右到左(得下文),两向隐藏状态拼接后送入全连接层 |
| Embedding | 把字的整数 ID 映射为低维稠密向量(如 128 维),让语义相近的字在向量空间中更靠近 |
例如"我爱中国"→ 我/S 爱/S 中/B 国/I。
模型架构:
- 输入:句子中每个字的整数 ID 序列;
- Embedding:ID → 稠密向量;
- BiLSTM:编码上下文,输出每个位置的隐藏状态;
- 全连接层:把隐藏状态映射到标签空间(4 个标签的概率);
- 损失函数:交叉熵(
CrossEntropyLoss),逐字计算预测标签与真实标签的差异。
生活类比:👇 👇 👇
BiLSTM 像一个既能"向前看"又能"向后看"的读者。单向 LSTM 读到"长江"时只知道前面是"南京市";BiLSTM 还有一个从右往左的通道,读到"长江"时已经知道后面是"大桥"。两个信息一结合,就能判断"长江大桥"应该是一个词。
特点与适用场景:
- 优点:自动学习特征,无需手工设计规则;能建模长距离上下文依赖;在大规模标注语料上效果显著优于 HMM 和规则方法;
- 局限:需要大量标注数据;计算资源需求高;可解释性不如统计模型;小数据集上极易过拟合;
- 场景:高精度分词(医疗、法律、金融)、端到端 NLP 系统、需要与下游任务联合优化的场景;
- 与 HMM 的区别:HMM 是生成式概率模型,BiLSTM 是判别式神经网络模型,且能利用更长的上下文。
行业趋势:2018 年之后,纯 BiLSTM 分词已逐渐被基于预训练语言模型(BERT、RoBERTa)的方案取代。但 BERT 类模型的字级标注能力并不必然优于 BiLSTM,且轻量模型在算力受限场景仍有价值。BiLSTM 作为理解深度学习序列标注的入门架构,仍是必须掌握的基础。
2 代码实操
业务场景:用 29 条标注语料训练一个 BiLSTM 序列标注模型,并在未见过的数据上评估准确率,理解深度学习分词的完整流程。
环境准备:pip install torch
# ========== 代码 4-7 BiLSTM 深度学习分词 ==========
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader

torch.manual_seed(42)      # 固定随机种子,保证每次运行结果一致
torch.set_num_threads(1)   # 限制线程数,避免多核环境下的结果抖动

# ---- 第一步:数据准备(句子, 分词结果)----
train_data = [
    ("我爱中国", ["我", "爱", "中国"]),
    ("我爱北京天安门", ["我", "爱", "北京", "天安门"]),
    ("中华人民共和国万岁", ["中华人民共和国", "万岁"]),
    ("今天天气不错", ["今天", "天气", "不错"]),
    ("我们去公园玩", ["我们", "去", "公园", "玩"]),
    ("他昨天去了图书馆", ["他", "昨天", "去", "了", "图书馆"]),
    ("中国的发展速度很快", ["中国", "的", "发展", "速度", "很快"]),
    ("请你调低一点音量", ["请", "你", "调低", "一点", "音量"]),
    ("学生会主席发表了讲话", ["学生会", "主席", "发表", "了", "讲话"]),
    ("她的笑容很迷人", ["她", "的", "笑容", "很", "迷人"]),
    ("大家一起来帮忙", ["大家", "一起", "来", "帮忙"]),
    ("小明在读一本小说", ["小明", "在", "读", "一本", "小说"]),
    ("这家餐厅的菜品很精致", ["这家", "餐厅", "的", "菜品", "很", "精致"]),
    ("老师正在批改作业", ["老师", "正在", "批改", "作业"]),
    ("他喜欢在图书馆看书", ["他", "喜欢", "在", "图书馆", "看书"]),
    ("孩子们在操场上跑步", ["孩子们", "在", "操场", "上", "跑步"]),
    ("这台机器已经修好了", ["这台", "机器", "已经", "修好", "了"]),
    ("请把窗户关一下", ["请", "把", "窗户", "关", "一下"]),
    ("昨天的会议取消了", ["昨天", "的", "会议", "取消", "了"]),
    ("他是一个认真的人", ["他", "是", "一个", "认真", "的", "人"]),
    ("我们一起去看电影吧", ["我们", "一起", "去", "看", "电影", "吧"]),
    ("这本书非常有意思", ["这本", "书", "非常", "有", "意思"]),
    ("孩子们都在教室里上课", ["孩子们", "都", "在", "教室", "里", "上课"]),
    ("这家医院的医生很专业", ["这家", "医院", "的", "医生", "很", "专业"]),
    ("明天我们去参观博物馆", ["明天", "我们", "去", "参观", "博物馆"]),
    ("他正在认真修改代码", ["他", "正在", "认真", "修改", "代码"]),
    ("这家餐厅的服务态度很好", ["这家", "餐厅", "的", "服务", "态度", "很", "好"]),
    ("我们周末去了长城", ["我们", "周末", "去", "了", "长城"]),
    ("小红喜欢弹钢琴", ["小红", "喜欢", "弹", "钢琴"]),
]
# 测试集单独准备:这两句的组合方式训练时没见过
test_data = [
    ("我们明天去看电影", ["我们", "明天", "去", "看", "电影"]),
    ("这家商店的商品很便宜", ["这家", "商店", "的", "商品", "很", "便宜"]),
]

# ---- 第二步:构建词汇表和标签表 ----
def build_vocab(data):
    """<PAD> 用于填充,<UNK> 表示未登录字"""
    vocab = {"<PAD>": 0, "<UNK>": 1}
    for sentence, _ in data:
        for char in sentence:
            if char not in vocab:
                vocab[char] = len(vocab)
    return vocab

def build_tag_vocab():
    """O:填充/无效标签, B:词首, I:词内, S:单字词"""
    return {"O": 0, "B": 1, "I": 2, "S": 3}

vocab = build_vocab(train_data + test_data)
tag_vocab = build_tag_vocab()
id2tag = {v: k for k, v in tag_vocab.items()}   # ID → 标签字符串,避免依赖字典顺序

# ---- 第三步:生成分词标签 ----
def generate_bio_tags(words):
    """根据分词结果,为每个字生成 B/I/S 标签"""
    tags = []
    for w in words:
        if len(w) == 1:
            tags.append("S")
        else:
            tags.append("B")
            tags.extend(["I"] * (len(w) - 1))
    return tags

def preprocess_data(data, vocab, tag_vocab):
    """文本 → 整数 ID 序列 + 标签 ID 序列"""
    inputs, labels = [], []
    for sentence, words in data:
        inputs.append([vocab.get(c, vocab["<UNK>"]) for c in sentence])
        labels.append([tag_vocab[t] for t in generate_bio_tags(words)])
    return inputs, labels

# ---- 第四步:动态填充(批处理要求同一 batch 序列等长)----
def pad_sequences(sequences, pad_value):
    """把不等长序列用 pad_value 填充到相同长度"""
    max_length = max(len(s) for s in sequences)
    return [s + [pad_value] * (max_length - len(s)) for s in sequences]

X_train, Y_train = preprocess_data(train_data, vocab, tag_vocab)
X_test, Y_test = preprocess_data(test_data, vocab, tag_vocab)
X_train = pad_sequences(X_train, vocab["<PAD>"])
Y_train = pad_sequences(Y_train, tag_vocab["O"])
X_test = pad_sequences(X_test, vocab["<PAD>"])
Y_test = pad_sequences(Y_test, tag_vocab["O"])

# ---- 第五步:定义 BiLSTM 模型 ----
class BiLSTM(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.embedding = nn.Embedding(input_size, hidden_size)
        # hidden_size // 2:双向 LSTM 每向输出该维度,两向拼接后等于 hidden_size
        self.lstm = nn.LSTM(hidden_size, hidden_size // 2,
                            num_layers=1, bidirectional=True)
        self.fc = nn.Linear(hidden_size, output_size)

    def forward(self, inputs):
        embedded = self.embedding(inputs)      # [batch, seq_len, hidden]
        outputs, _ = self.lstm(embedded)       # [batch, seq_len, hidden]
        return self.fc(outputs)                # [batch, seq_len, num_tags]

# ---- 第六步:模型初始化与训练配置 ----
model = BiLSTM(len(vocab), 128, len(tag_vocab))
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)
batch_size = 16

# ---- 第七步:训练 / 评估通用函数 ----
def run_epoch(loader, optimizer=None):
    """传 optimizer 就是训练,不传就是评估;返回平均损失和逐字准确率"""
    training = optimizer is not None
    model.train() if training else model.eval()

    total_loss, n_batch = 0.0, 0
    correct, total_token = 0, 0

    # 评估时关掉梯度,节省内存
    with torch.set_grad_enabled(training):
        for batch in loader:
            ins, labs = zip(*batch)
            inputs = torch.tensor(pad_sequences(ins, vocab["<PAD>"]))
            labels = torch.tensor(pad_sequences(labs, tag_vocab["O"]))

            logits = model(inputs)
            loss = criterion(logits.view(-1, len(tag_vocab)), labels.view(-1))

            if training:
                optimizer.zero_grad()   # 清空上一步梯度
                loss.backward()         # 反向传播
                optimizer.step()        # 更新参数

            # 注意:损失是按 batch 平均的,除以 batch 数而非样本数
            total_loss += loss.item()
            n_batch += 1

            # 逐字准确率:排除填充位置(标签为 O)后再统计
            mask = labels != tag_vocab["O"]
            pred = logits.argmax(-1)
            correct += (pred[mask] == labels[mask]).sum().item()
            total_token += mask.sum().item()

    return total_loss / n_batch, correct / total_token


train_loader = DataLoader(list(zip(X_train, Y_train)),
                         batch_size=batch_size, collate_fn=lambda x: x)
test_loader = DataLoader(list(zip(X_test, Y_test)),
                        batch_size=batch_size, collate_fn=lambda x: x)

print(f"训练集 {len(train_data)} 条 | 测试集 {len(test_data)} 条 | 词表 {len(vocab)} 字")
for epoch in range(60):
    train_loss, _ = run_epoch(train_loader, optimizer)
    if (epoch + 1) % 10 == 0:
        print(f"Epoch {epoch + 1:>2} | Train Loss {train_loss:.4f}")

test_loss, test_acc = run_epoch(test_loader)   # 不传 optimizer → 评估模式
print(f"Test  Loss {test_loss:.4f} | 标注准确率 {test_acc * 100:.1f}%")

# ---- 第八步:预测与标签还原 ----
def predict_tags(sentence, vocab, model, id2tag):
    """对新句子预测 B/I/S 标签序列"""
    ids = [vocab.get(c, vocab["<UNK>"]) for c in sentence]
    with torch.no_grad():                      # 推理不需要计算梯度
        logits = model(torch.tensor([ids]))
        pred = logits.argmax(-1)[0].tolist()
    return [id2tag[i] for i in pred]

def tags_to_words(sentence, tags):
    """把 B/I/S 标签序列还原成词列表"""
    words, cur = [], ""
    for char, tag in zip(sentence, tags):
        if tag == 'B':
            if cur:
                words.append(cur)
            cur = char        # 开始一个新词
        elif tag == 'I':
            cur += char       # 延续当前词
        elif tag == 'S':
            if cur:
                words.append(cur); cur = ""
            words.append(char) # 单字词直接输出
    if cur:
        words.append(cur)
    return words

for s in ["我爱中国", "我们明天去看电影", "这家商店的商品很便宜"]:
    tags = predict_tags(s, vocab, model, id2tag)
print(f"{s} -> {tags} -> {tags_to_words(s, tags)}")运行结果(PyTorch 2.9.1 实机验证):
训练集 29 条 | 测试集 2 条 | 词表 152 字
Epoch 10 | Train Loss 0.0140
Epoch 20 | Train Loss 0.0005
Epoch 30 | Train Loss 0.0002
Epoch 40 | Train Loss 0.0002
Epoch 50 | Train Loss 0.0002
Epoch 60 | Train Loss 0.0001
Test  Loss 0.3596 | 标注准确率 83.3%
我爱中国 -> ['S', 'S', 'B', 'I'] -> ['我', '爱', '中国']
我们明天去看电影 -> ['S', 'I', 'I', 'B', 'S', 'S', 'B', 'I'] -> ['我', '们明', '天', '去', '看', '电影']
这家商店的商品很便宜 -> ['B', 'I', 'B', 'S', 'S', 'B', 'I', 'S', 'B', 'B'] -> ['这家', '商', '店', '的', '商品', '很', '便', '宜']结果分析:
- 训练损失从 0.0140 降到 0.0001,说明模型完全记住了训练数据。
- 测试集准确率 83.3% —— 注意这个数字远低于训练集表现。这就是过拟合最直观的证据:训练损失趋近于 0,测试损失却是 0.3596。
- 预测"我爱中国"(训练集中出现过)完全正确;预测"我们明天去看电影"时把"我们"切成了"我/们明",出现了边界错误。
- 根本原因:29 条语料只有约 150 个不同汉字,模型根本没学到通用语言规律,只是在背具体句子。工业级分词模型需要百万级标注语料。
关键观察:
hidden_size // 2的写法:双向 LSTM 的每个方向输出hidden_size // 2维,两向拼接后正好是hidden_size,与全连接层的输入维度匹配。- 为什么必须固定随机种子:PyTorch 的权重初始化是随机的,不固定种子时每次运行的预测标签可能不同(实测同一份代码会得到
['S','S','B','I']或['B','S','B','I']两种结果)。
易错点小结:
- 平均损失除错对象:
total_loss是各 batch 损失的平均值之和,要除以n_batch而不是len(train_data),否则打印值会被缩小好几倍。 - 填充位参与损失计算:
labels里的填充位是O,代码把它们计入了损失。更严谨的做法是用criterion(..., ignore_index=tag_vocab["O"])忽略,或用 mask 屏蔽(本代码的准确率统计已做 mask)。 - 推理时必须关梯度:预测函数里加
with torch.no_grad():,避免浪费内存和时间。 - 不要用
list(tag_vocab.keys())[id]反查标签:它依赖字典插入顺序,代码一改顺序就全错。应该构造id2tag反查表。 - 小数据集必过拟合:几十条语料训练几十个 epoch,模型必然记住训练集。评估一定要用没参与训练的测试集,否则准确率是虚高的。
5:综合实战 —— 真实文本的分词处理
综合实战
业务场景
把手头的原始文本,变成可以直接喂给下游模型(情感分析、主题分类)的特征数据。这是把分词用起来的最短路径。
完整 pipeline:
原始文本
  ↓ ① 正则清洗:去掉标点,保留中英文和数字
纯文本
  ↓ ② jieba 精确模式分词
词列表
  ↓ ③ 过滤停用词 + 过滤单字噪声词
有效词列表
  ↓ ④ Counter 统计词频,取 TopN 作为关键词
关键词特征
# ==========真实文本的分词处理流水线 ==========
import re
from collections import Counter
import jieba
# 中文停用词表(生产环境应从文件加载完整词表)
STOP_WORDS = set("的地得了着和是就都而及与也很到说要去你我他她它这那一个有吧吗呢啊把被让给对从但")
def preprocess(text, stop_words=STOP_WORDS, drop_single_char=False):
"""把一段原始文本处理成有效词列表"""
# ① 正则清洗:只保留中文、英文、数字,其余替换为空格
text = re.sub(r'[^\u4e00-\u9fa5A-Za-z0-9]', ' ', text)
# ② 精确模式分词
words = jieba.cut(text)
# ③ 过滤:去空白、去停用词、按需过滤单字词
result = [w for w in words if w.strip() and w not in stop_words]
if drop_single_char:
result = [w for w in result if len(w) > 1]
return result
def analyze(text, topn=5):
words = preprocess(text, drop_single_char=True)
keywords = Counter(words).most_common(topn)
return words, keywords
# ==== 测试 ====
text = "这家餐厅的服务态度很好,菜品也很精致。我和同事来过一次,感觉价格实惠,环境干净整洁,服务员也很热情,推荐大家来尝试。"
words, keywords = analyze(text, 5)
print("分词结果:", " / ".join(words))
print("Top5 关键词:", keywords)运行结果:
分词结果: 这家 / 餐厅 / 服务态度 / 菜品 / 精致 / 同事 / 来过 / 一次 / 感觉 / 价格 / 实惠 / 环境 / 干净 / 整洁 / 服务员 / 热情 / 推荐 / 大家 / 尝试
Top5 关键词: [('这家', 1), ('餐厅', 1), ('服务态度', 1), ('菜品', 1), ('精致', 1)]结果分析:
- 正则清洗把"很"这类程度副词和标点混在一起的问题解决了一部分,真正的停用词过滤靠第 ③ 步。
- 过滤单字词后(
drop_single_char=True),"的/很/也/和"以及"好""来"这些噪声全部消失,剩下的都是有实义的完整词 —— 对比过滤前的 21 个词,净化后剩 19 个。 - Top5 关键词出现了大量频次为 1 的词,说明文本太短。真实的关键词提取需要足够长的语料(通常一篇文档或一个语料库)才有统计意义 —— 这也是本讲开头"实践任务:新闻文本高频词"要用整篇新闻的原因。
- 这条流水线可以直接接到情感分析、文本分类等下游任务:把
words转成词袋(Bag of Words)或 TF-IDF 向量即可。
易错点小结:
- 短文本做不出有意义的关键词:词频统计需要样本量,短文本里全是频次 1,没有区分度。
re.sub的字符类要写对:[^\u4e00-\u9fa5A-Za-z0-9]中的^表示"取反",不能漏掉,否则会连中文一起替换掉。- 停用词表要按业务定制:做情感分析要额外过滤"好/差/喜欢"这类情感词,否则关键词提取会被主观词淹没。