part02-自然语言处理-语料库
part02-自然语言处理-语料库
学完本讲,你应该能够:
- 用自己的话说出什么是语料库,讲出它的八大特点和八大用途。
- 按三种划分方式给七大类语料库归类,并说出构建语料库的七大原则。
- 说出六个常用中文语料库的名字、用途和获取渠道。
- 认识文本处理工具箱:正则六函数、OpenCC、jieba、Counter 各管什么。
- 独立完成两个任务:网络在线语料分析(六步流水线)、构建电影评论语料库。
1.语料库是什么
前言
上一讲我们说:模型读了什么语料,就学会什么表达。这一讲就来解决"米"的问题——语料就是 NLP 的米,没有语料,再好的算法也做不出饭 👈
语料库(Corpus),就是为支持和促进 NLP 技术研究与开发,收集组织的大量文本或语音数据集合。它包含从基础语言单元到复杂语言结构的各类语言元素,可涵盖多语言、领域和风格。
注意两个关键词:大量(不是一篇文章)、有组织(不是随便一堆文本)。网上爬来没清洗的数据只能叫"原始文本",整理好、可使用的才叫语料库。
语料库(Corpus):为 NLP 研发而收集组织的大量文本/语音数据集合。例:相当于学生的"课本 + 习题集"——教材里的课文是精心挑选、成体系组织的,不是从街上捡的一沓传单。
2 八大特点
| 特点 | 一句话理解 | 为什么重要 |
|---|---|---|
| 多样性 | 多类型、多话题的文本 | 给计算机丰富的语言样本,学习不同场景的表达 |
| 规模 | 数据量大 | 数据越多,接触的语言现象越广,规律学得越准 |
| 平衡性 | 文本分布均衡 | 避免某类文本过度集中,防止模型学偏、提高泛化能力 |
| 质量 | 低错误率、反映真实自然语言 | 错误数据教出错误模型,"垃圾进垃圾出" |
| 标注 | 提供词性、句法等结构化信息 | 标注信息帮助训练复杂 NLP 任务 |
| 可访问性 | 开放或可合规获取 | 研究者和开发者拿得到、用得上 |
| 语言文化多样性 | 涵盖多语言文化背景 | 满足跨语言研究和多语言应用 |
| 时间敏感性 | 动态更新 | 语言在变(新词、网络用语),语料也要跟着更新 |
泛化能力:模型在没见过的数据上依然表现好的能力。例:只背过娱乐新闻的模型,一聊科技就露馅——泛化能力差;什么都读过的模型,换话题也能应对——泛化能力好。
3 八大用途
| 用途 | 典型用法 |
|---|---|
| 机器翻译训练 | 提供双语/多语对照文本,让模型学习语言间的对应关系 |
| 语言研究 | 提供丰富语言样本,分析语言的结构、用法、演变 |
| 信息检索和数据挖掘 | 分析处理大量文本,快速找到所需信息、挖掘有价值数据 |
| 评估和测试 | 作为标准数据集,评估 NLP 系统和模型的性能 |
| 模型训练和开发 | 为各种 NLP 模型提供训练数据 |
| 教育和学习 | 为学生教师提供丰富学习资源 |
| 开发语言资源 | 帮助开发词典、语法规则库等 |
| 语音识别和生成 | 为语音系统提供训练数据 |
标准数据集:大家公认的、用来"考试"的固定数据集合。例:相当于全国统一的考试卷——各家的模型都做同一套题,分数才能横向比较。
自检
- 语料库的定义是:为支持和促进 NLP 技术研究与开发而___的数据集合?A.随手保存、未加整理 B.收集组织大量文本或语音 C.单篇文档精读标注 D.人工逐句翻译
答案:B.语料库强调"大量、有组织、服务于 NLP 研发",不是随便一堆文本 - 语料库的"平衡性"特点指的是?A.数据量大 B.文本分布均衡、避免某类过度集中 C.错误率低 D.标注了词性句法
答案:B.分布均衡能防止模型学习产生偏差、提高泛化能力。A 是规模、C 是质量、D 是标注 - 某语料 90% 是娱乐新闻,训练出的模型聊科技就答非所问,主要违背了哪个特点?A.多样性 B.规模 C.时间敏感性 D.可访问性
答案:A.多类型、多话题才叫多样性,单一话题过度集中是多样性不足 - 语料库用于机器翻译训练时,主要提供?A.单语新闻文本 B.双语或多语对照文本 C.语音录音 D.图片字幕
答案:B.双语对照文本让模型学习语言间的对应关系 - 下列哪项不属于 PPT 列举的语料库用途?A.信息检索和数据挖掘 B.语音识别和生成 C.预测加密货币行情 D.教育和学习
答案:C.八大用途不含金融行情预测
2.语料库的种类与构建原则
前言
知道了"什么是好语料库",接下来解决两个问题:语料库分哪几类?自己动手构建时要守哪些规矩?
1 七大种类
七种语料库可以按三种方式划分:按内容领域分、按更新方式分、按标注形式分 👈
| 划分方式 | 种类 | 用途 |
|---|---|---|
| 按内容领域 | 专业或特定领域语料库 | 专注医疗、法律等领域,训练专用模型,在该领域更精准 |
| 双语或多语语料库 | 包含平行翻译文本,用于机器翻译和跨语言研究 | |
| 平衡语料库 | 覆盖多领域文本,支持通用语言模型训练 | |
| 按更新方式 | 静态语料库 | 数据固定不变,适合历史分析 |
| 动态语料库 | 持续更新,适配实时应用 | |
| 按标注形式 | 注释语料库 | 标注词性、句法等结构化信息,训练复杂 NLP 任务 |
| 多模态语料库 | 整合文本、图像、音频等多种数据,支持多模态系统开发 |
平行翻译文本:同一段内容在两种语言里一一对应的文本。例:一句中文配一句英文翻译,像双语绘本的左右两栏——机器翻译模型就靠"对答案"学会翻译。
多模态:同时包含文字、图片、音频等多种类型信息。例:上讲提过,"能看图、能听话、能说话"的模型,靠的就是多模态语料。
2 构建七大原则
动手建语料库前,七条规矩先背下来:
| 原则 | 一句话理解 |
|---|---|
| 代表性 | 语料要能代表目标应用场景的语言现象,不能"挂羊头卖狗肉" |
| 多样性 | 覆盖多种类型、多种话题的文本 |
| 高质量 | 低错误率、清洗到位、真实反映语言使用 |
| 透明性和可追溯性 | 数据来源、处理过程有据可查,别人能复现 |
| 遵守伦理和法律 | 涉及隐私、版权的数据必须合规获取、取得授权 |
| 可持续性和可扩展性 | 后续能持续补充新数据、不断扩展 |
| 平衡性 | 各领域、各类型文本比例均衡 |
可追溯:每条数据"从哪来、怎么处理过"都有记录。例:像食品的溯源码——扫一下就知道这颗菜哪个基地种的,出问题能查到源头;语料可追溯,实验结果才可信。
自检
- 主要用于机器翻译和跨语言研究的语料库是?A.平衡语料库 B.双语或多语语料库 C.静态语料库 D.注释语料库
答案:B.双语/多语语料库包含平行翻译文本,帮计算机学习语言对应关系 - 静态语料库与动态语料库的核心区别在于?A.数据量大小 B.是否持续更新 C.是否标注词性 D.是否对外开放
答案:B.静态=数据固定、适合历史分析;动态=持续更新、适配实时应用 - 开发"看图说话"这类图文结合系统,需要的是?A.静态语料库 B.多模态语料库 C.注释语料库 D.动态语料库
答案:B.多模态语料库整合文本、图像、音频等多种形式数据 - 未经授权抓取用户私信作为训练数据,违反了哪条原则?A.遵守伦理和法律 B.多样性 C.可持续性 D.平衡性
答案:A.私信属个人隐私,采集语料必须合规、取得授权 - 七大原则中,与"语料库后续能持续补充新数据、不断扩展"对应的是?A.可持续性和可扩展性 B.平衡性 C.代表性 D.高质量
答案:A.语言在动态发展,语料库要能随之扩充才不会过时
3.语料从哪来:常用语料库获取渠道
前言
自己从零爬数据太慢,做实验优先用"现成的好米"。常用中文语料库分三类:
| 类别 | 语料库 | 内容与用途 | 获取渠道 |
|---|---|---|---|
| 新闻类 | 搜狗新闻语料库 | 新闻语料研究和开发 | 搜狗实验室官网直接下载 |
| 人民日报语料库 | 多年新闻文本,用于分词、词性标注等 | GitHub 可获取处理版本 | |
| 社交与古典 | 社交媒体文本 | 微博等平台抓取,适配情感分析 | GitHub 或论文附录 |
| 中文电子文本项目 | 古典文学数据库,支持历史文本分析 | 官网免费访问下载 | |
| 学术问答类 | 百度问答数据集 | 百度开放的问答语料,用于问答系统开发 | 百度研究开放数据集网站 |
| 清华大学开放中文语料库(THUCNews) | 基于新浪新闻的新闻分类数据集 | 官网或 GitHub 下载 |
THUCNews:清华大学推出的开放中文语料库,基于新浪新闻构建的新闻分类数据集。例:每篇新闻已标好类别(体育、财经、科技……),是做"文本分类"实验最常用的入门数据集之一。
选语料三步走:先看任务(分类?翻译?情感?)→ 再找对口的语料库 → 最后确认获取渠道合规 👇
自检
- 搜狗新闻语料库的正确获取方式是?A.搜狗实验室官网直接下载 B.论文附录申请 C.只能线下邮寄硬盘 D.需付费采购
答案:A.由搜狗实验室提供,官网可直接下载 - 人民日报语料库在 NLP 中最常用于?A.语音合成 B.分词、词性标注等任务 C.图像识别 D.视频检索
答案:B.包含多年新闻文本,GitHub 可获取处理版本 - 要做新闻文本分类实验,最适合的数据集是?A.清华大学开放中文语料库 B.百度问答数据集 C.中文电子文本项目 D.微博情感语料
答案:A.THUCNews 是基于新浪新闻的分类数据集,官网或 GitHub 提供下载 - 研究古代文学、做历史文本分析,可用?A.搜狗新闻语料库 B.中文电子文本项目 C.百度问答数据集 D.THUCNews
答案:B.中文电子文本项目是古典文学数据库,官网免费访问下载 - 百度问答数据集的获取渠道是?A.百度研究开放数据集网站 B.搜狗实验室官网 C.微博开放平台 D.GitHub 古腾堡项目
答案:A.用于问答系统开发,在百度研究开放数据集网站获取
4.文本处理工具箱:正则·OpenCC·jieba·Counter
前言
两个实践任务前,先把四件工具装进工具箱。本讲只要求"认识工具、知道谁管什么",正则语法细节后续单元专门讲 👈
1 正则表达式:文本筛选器
正则表达式(Regular Expression,常简称"正则"或"Regex")是一种用特殊符号组合成的"规则字符串",核心作用是快速匹配、查找、替换文本中符合特定规律的内容。简单说,它就像一把"文本筛选器"——你写好"筛选规则",计算机就能从杂乱的文本里精准找到你要的内容(比如电话号码、邮箱),或者删掉你不要的内容(比如非中文字符)。
re 模块六个常用函数:
| 函数 | 核心用途 | 适合场景举例 |
|---|---|---|
re.sub() | 替换 / 删除字符 | 文本清洗(去非中文、去符号) |
re.findall() | 提取所有符合条件的内容 | 批量提手机号、数字、邮箱 |
re.search() | 找第一个符合条件的内容 | 判断文本是否含某类内容 |
re.match() | 从开头匹配,验证格式 | 验证手机号、邮箱开头合法性 |
re.split() | 按规则分割文本 | 分割句子、拆分带多种分隔符的文本 |
re.compile() | 预编译规则,重复使用 | 批量处理大量文本时提高效率 |
正则表达式:用特殊符号写成的"筛选规则"字符串。例:
[^\u4e00-\u9fa5]表示"所有不是中文的字符"——用re.sub()把它们替换成空,一段文本眨眼就只剩中文。
2 OpenCC:繁简转换器
OpenCC 是专门用于中文繁简转换的工具库。OpenCC() 是核心类,负责初始化转换配置;convert() 方法返回转换后的字符串。处理两岸三地文本(如香港、台湾的繁体资料)时非常实用。
#  需要安装:pip install opencc-python-reimplemented
from opencc import OpenCC

# t2s = 繁体 → 简体(s2t 则是简体 → 繁体)
cc = OpenCC('t2s')
text_simplified = cc.convert('機器學習是人工智慧的核心')
print(text_simplified)   # 输出:机器学习是人工智能的核心
3 jieba:中文分词
jieba 是 Python 中最常用的中文分词库,核心功能是把连续的中文文本拆分成独立的词语(如"我爱中国"→["我", "爱", "中国"])。两个最常用函数的区别:
| 函数 | 返回类型 | 特点 | 适用场景 |
|---|---|---|---|
jieba.cut(text) | 生成器 | 不直接返回结果,需 for 循环逐个获取或 list() 转列表;内存占用小 | 大文本分词、节省内存 |
jieba.lcut(text) | 列表 | 直接返回 [词1, 词2, ...],可用索引访问;一次性加载到内存 | 中小文本、直接操作列表 |
import jieba
lcut=jieba.lcut("我爱中国")
print(lcut) # 输出:['我', '爱', '中国']分词:给连续的汉字加上词语边界。英文单词之间有空格,中文没有——"研究生命的起源"可以切成"研究/生命/的/起源",也能切成"研究生/命/的/起源",机器必须先做选择。
生成器(generator):一种"按需生产、用一次给一个"的对象。例:像拧开水龙头接水,要多少流多少;而列表像先把一整桶水搬回家。处理超大文本时水龙头更省力——这就是 cut() 比 lcut() 省内存的原因。
4 Counter:词频统计器
Counter 来自 Python 标准库 collections,专门数个数:传入一个词列表,自动统计每个词出现的次数。
from collections import Counter

words = ['电影', '好看', '电影', '剧情', '电影']
word_count = Counter(words)
print(word_count.most_common(2)) # [('电影', 3), ('好看', 1)]most_common(n):取出现次数最多的前 n 个。例:
Counter(words).most_common(10)就是"词频 Top10"——两个实战任务的收尾都用它。
自检
- 正则表达式的核心作用是?A.压缩文本体积 B.按规则快速匹配、查找、替换文本 C.翻译文本 D.统计词频
答案:B.正则像"文本筛选器":写好规则,计算机按规则精准筛选内容 - 文本清洗中"移除非中文字符",应使用的 re 函数是?A.re.findall() B.re.match() C.re.sub() D.re.compile()
答案:C.re.sub() 负责替换/删除字符,是文本清洗主力 - 要批量提取文本中所有邮箱地址,最合适的函数是?A.re.findall() B.re.search() C.re.sub() D.re.split()
答案:A.findall 提取所有符合条件的内容;search 只找第一个 - jieba.cut() 与 jieba.lcut() 的核心区别是?A.cut 精度高、lcut 精度低 B.cut 返回生成器、lcut 返回列表 C.cut 只能切英文 D.lcut 不支持中文
答案:B.cut 返回生成器(省内存,适合大文本);lcut 直接返回列表(中小文本方便取用) - 用 OpenCC 把繁体文本转简体,正确写法是?A.
cc = OpenCC('t2s'); cc.convert(text)B.cc = OpenCC('s2t'); cc.convert(text)C.opencc.translate(text)D.OpenCC(text)
答案:A.t2s = 繁→简;s2t 是简→繁;convert() 返回转换后的字符串
5.实践任务一:网络在线语料分析 ✏️
前言
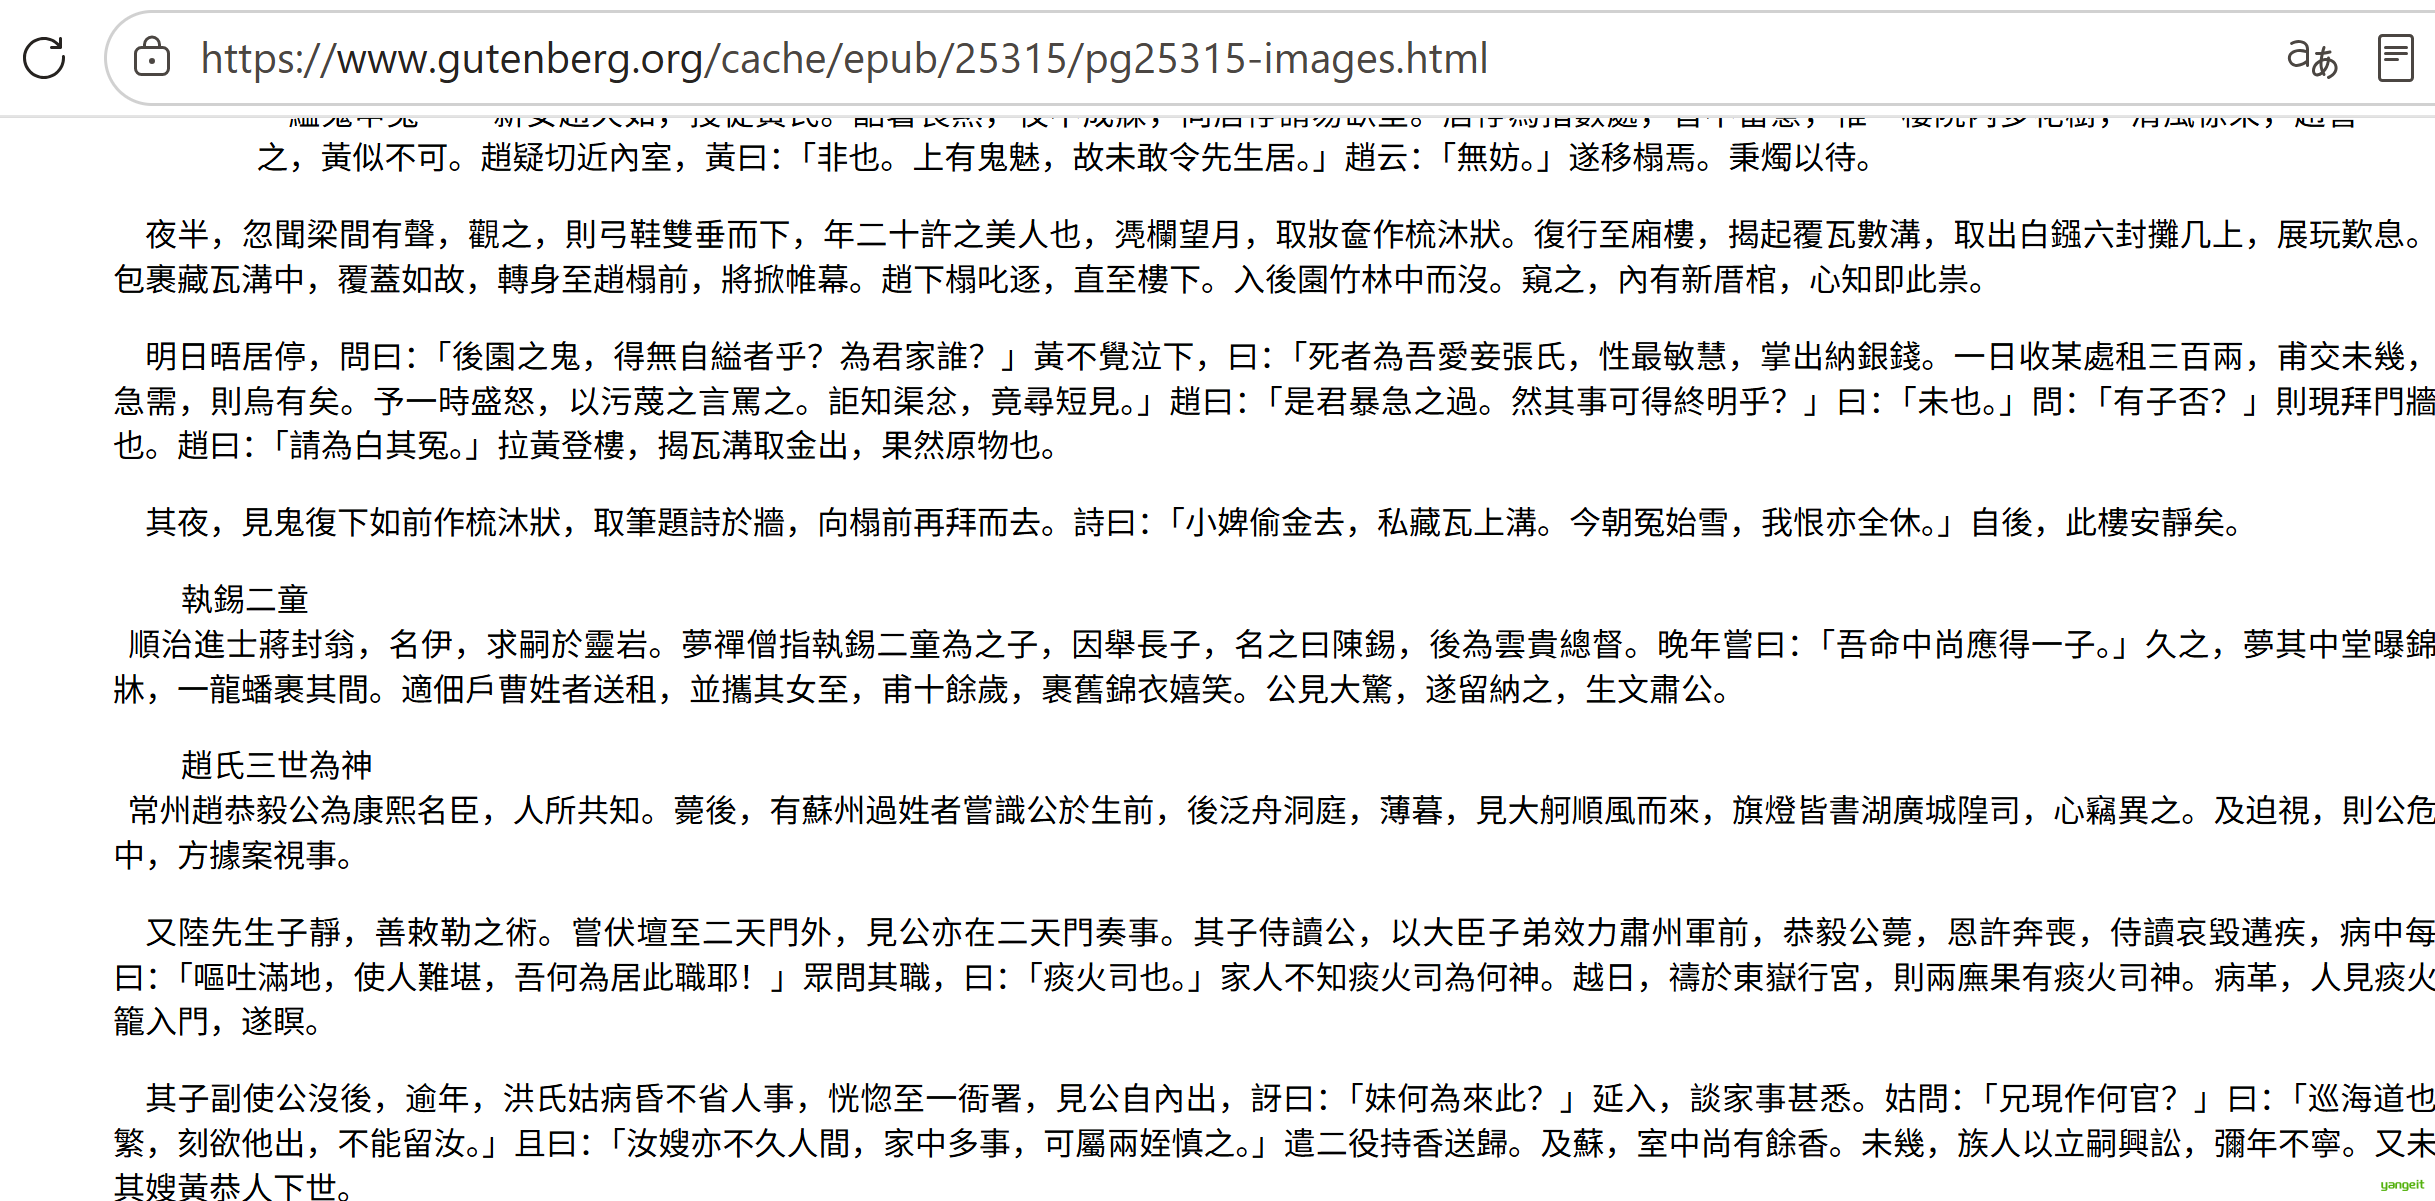
工具备齐,开工。任务:从古腾堡项目(Project Gutenberg,免费的电子书网站)获取一篇中文语料,完成获取 → 清洗 → 转换 → 停用词 → 词频 → 预览 六步流水线 👇
任务地址:https://www.gutenberg.org/cache/epub/25315/pg25315-images.html
1 六步流水线
| 步骤 | 做什么 | 用什么工具 |
|---|---|---|
| ① 获取文本 | 爬取网页上的在线语料 | requests + BeautifulSoup |
| ② 清洗文本 | 去除噪声:无用字符、错误格式 | re.sub() 删非中文字符 |
| ③ 文本转换 | 繁体转简体,便于后续分析 | OpenCC('t2s') |
| ④ 加载停用词 | 过滤"的、是、在"等无意义词 | 停用词表 |
| ⑤ 词频统计 | 统计每个词出现的次数 | jieba 分词 + Counter |
| ⑥ 预览文本 | 查看分析结果,确认流程是否达标 | print 输出 |
BeautifulSoup:从网页 HTML 里"捞内容"的库。例:网页像一碗汤,HTML 标签是佐料,BeautifulSoup 负责把你要的肉(正文文本)从汤里捞出来。
停用词:"的、了、在、是"这类出现频率极高但没有实际意义的词。例:统计"的"出现 800 次、主题词出现 20 次——不过滤停用词,词频榜会被它们霸屏,看不出文本在讲什么。
2 参考实现
import requests
from bs4 import BeautifulSoup
import re
import jieba
from opencc import OpenCC
from collections import Counter

# ===== 第 1 步:获取文本 =====
url = "https://www.gutenberg.org/cache/epub/25315/pg25315-images.html"
resp = requests.get(url)
resp.encoding = 'utf-8'
soup = BeautifulSoup(resp.text, 'html.parser')
raw_text = soup.get_text()

# ===== 第 2 步:清洗文本(移除非中文字符)=====
chinese_only = re.sub(r'[^\u4e00-\u9fa5]+', ' ', raw_text)

# ===== 第 3 步:文本转换(繁体 → 简体)=====
cc = OpenCC('t2s')
text = cc.convert(chinese_only)

# ===== 第 4 步:加载停用词 =====
stopwords = {'的', '了', '在', '是', '我', '有', '和', '就', '不', '人',
             '都', '一', '一个', '上', '也', '很', '到', '說', '要', '去',
             '你', '會', '着', '没有', '看', '好', '自己', '這'}

# ===== 第 5 步:分词 + 过滤停用词 + 词频统计 =====
words = [w for w in jieba.lcut(text) if w.strip() and w not in stopwords]
word_count = Counter(words)

# ===== 第 6 步:预览输出 =====
print("总词数:", len(words))
print("不重复词汇数:", len(word_count))
print("高频词 Top10:", word_count.most_common(10))
# 词频区间统计:只出现 1 次的词有多少个
freq_1 = sum(1 for c in word_count.values() if c == 1)
print("只出现 1 次的词:", freq_1)
print("文本预览:", text[:200])
运行结果:👇
总词数: 46691
不重复词汇数: 20181
高频词 Top10: [('之', 956), ('曰', 732), ('而', 534), ('则', 265), ('矣', 252), ('亦', 249), ('为', 235), ('与', 231), ('其', 223), ('见', 214)]
只出现 1 次的词: 15013
文本预览:  续子不语 续子不语 续子不语 续子不语 第一卷 狼军师 有钱某者 赴市归晚 行山麓间 突出狼数十 环而欲噬 迫甚 见道旁有积薪高丈许 急攀跻执 爬上避之 狼莫能登 内有数狼驰去 少焉 簇拥一兽来 俨舆卒之舁官人者 坐之当中 众狼侧耳于其口傍 若密语俯听状 少顷 各跃起 将薪自下抽取 枝条几散溃矣 钱大骇呼救 良久 适有樵伙闻声共喊而至 狼惊散去 而舁来之兽独存 钱乃与各樵者谛视之 类狼非狼 圆睛
3 扩展:柱状图可视化
用 matplotlib 把 Top10 高频词画成柱状图:词语作 x 轴、出现次数作 y 轴,plt.bar(x, y) 绘制,再加上标题和标签,数据一目了然。
import matplotlib.pyplot as plt

top10 = word_count.most_common(10)
x = [w for w, c in top10]
y = [c for w, c in top10]

plt.rcParams['font.sans-serif'] = ['SimHei']   # 中文显示
plt.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(10, 5))
plt.bar(x, y)
plt.title("高频词 Top10")
plt.xlabel("词语")
plt.ylabel("出现次数")
plt.show()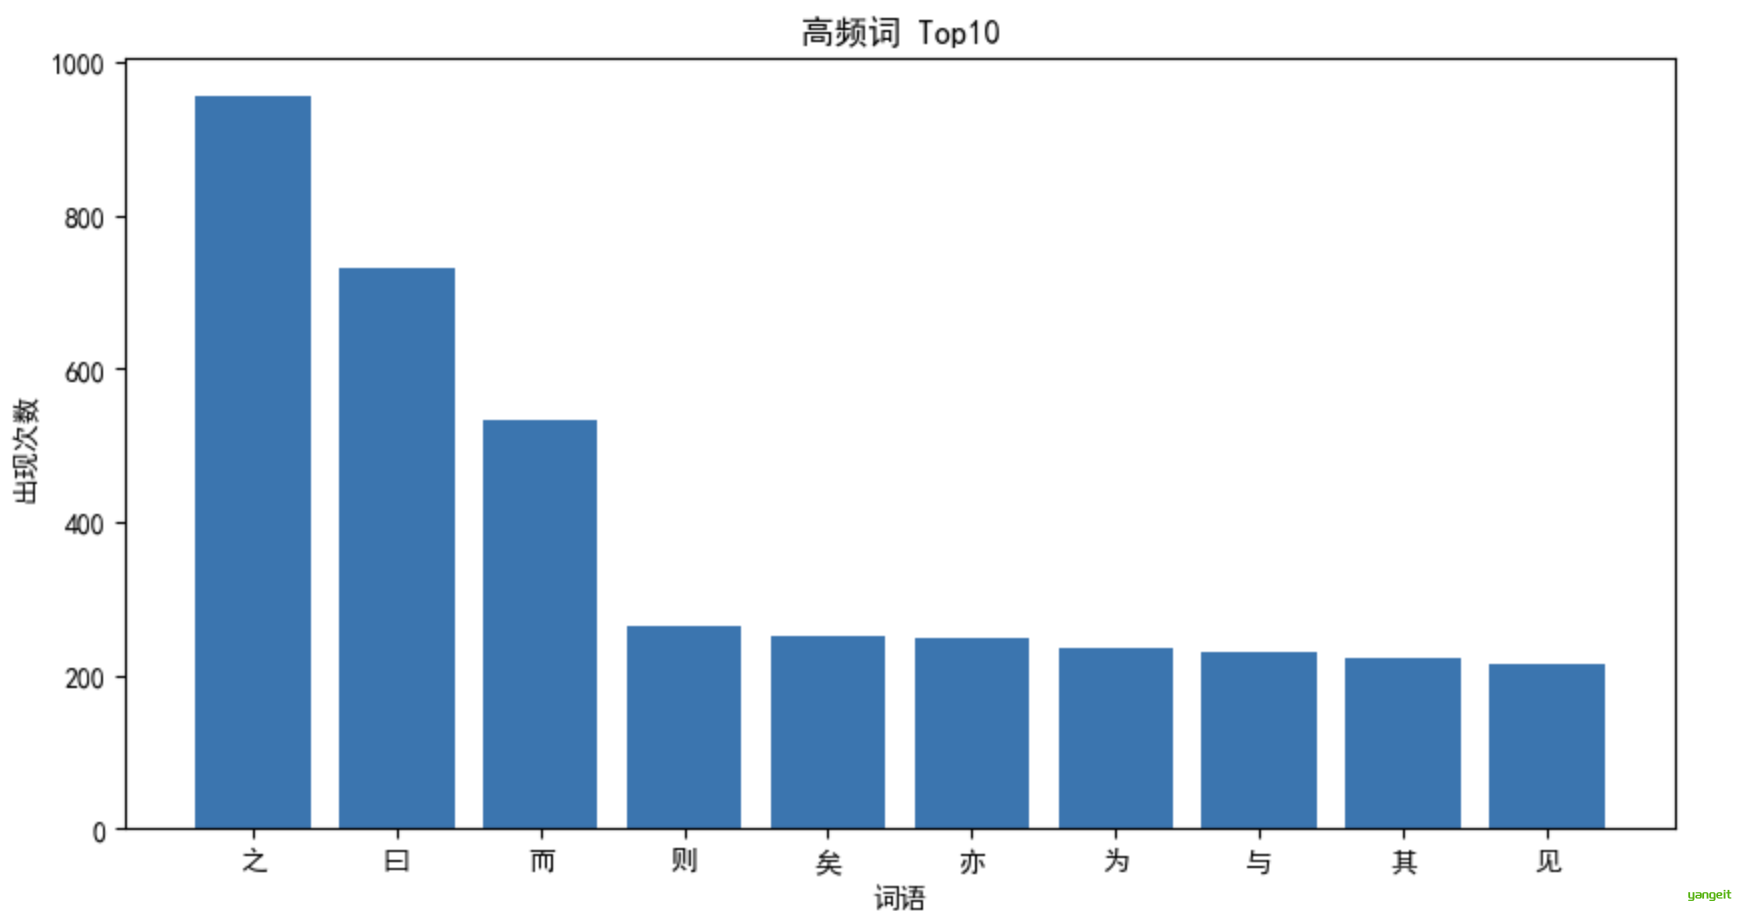
常见报错排查
| 现象 | 原因 | 解决办法 |
|---|---|---|
ModuleNotFoundError | 库没装 | pip install requests beautifulsoup4 opencc-python-reimplemented jieba |
| requests 超时 | 网络问题 | 检查网址拼写、确认网络连通 |
| 统计结果全是"的、了" | 停用词没过滤 | 检查第 4 步停用词表是否加载、过滤条件写反 |
UnicodeDecodeError | 编码不匹配 | resp.encoding = 'utf-8' 显式指定 |
| 中文字符被误删 | 正则范围写错 | 用 [^\u4e00-\u9fa5](^ 表示"非") |
自检
- 流程第一步获取在线语料,使用的组合是?A.requests + BeautifulSoup B.pandas + numpy C.jieba + OpenCC D.matplotlib + Counter
答案:A.爬虫获取在线语料是整个分析流程的起始步骤 - 分析过程中加载停用词表的目的是?A.加快运行速度 B.过滤"的、是、在"等无实际意义的词,聚焦有价值信息 C.转换繁简体 D.去除重复文本
答案:B.停用词高频但无信息量,过滤后词频统计才有意义 - 清洗古腾堡中文文本时"移除非中文字符",正确思路是?A.用 re.sub() 配合中文字符范围正则删除非中文部分 B.用 Counter 统计后删除 C.用 OpenCC 转换即可 D.手工逐行删除
答案:A.正则描述"哪些是中文保留、其余删掉",re.sub 一行完成 - 原始语料是香港繁体资料,转成简体应使用?A.jieba B.OpenCC C.BeautifulSoup D.pandas
答案:B.OpenCC 专做中文繁简转换,处理两岸三地文本非常实用 - 统计每个词出现次数(词频),应使用哪个类?A.collections.Counter B.re.compile C.OpenCC D.requests
答案:A.Counter 传入词列表,自动统计每个词出现次数、排序取 Top N
6.实践任务二:构建电影评论语料库
前言
任务一分析别人的语料,任务二亲手构建一个自己的语料库:从 ratings.csv(已发给大家的电影评分评论数据)出发,三步建成 movie_comments.txt 👇
1 三步建库
| 步骤 | 做什么 | 工具 |
|---|---|---|
| ① 数据收集 | 读取 ratings.csv,用其中的评论和评分信息 | pandas |
| ② 数据预处理 | 对 comment 列评论文本清洗:去标点符号、数字、多余空格 | 正则表达式 |
| ③ 构建语料库 | 处理后写入 movie_comments.txt,每条评论单独占一行 | open + write |
| ④ 随机查看 | 随机抽取一条评论展示,验证语料库有效性 | random |
2 参考实现
import pandas as pd
import re
import random

# ===== 第 1 步:读取数据(数据收集)=====
df = pd.read_csv('./data/ratings.csv')

# ===== 第 2 步:数据预处理(清洗 comment 列)=====
def clean_text(text):
    """去标点、数字、多余空格,规范文本格式"""
    text = re.sub(r'[^\u4e00-\u9fa5a-zA-Z]+', ' ', str(text))
    return text.strip()

comments = df['comment'].apply(clean_text)

# ===== 第 3 步:构建语料库(每条评论单独一行)=====
with open('./data/movie_comments.txt', 'w', encoding='utf-8') as f:
    for c in comments:
        if c:                      # 跳过清洗后的空评论
            f.write(c + '\n')
print("语料库构建完成,共", sum(1 for c in comments if c), "条评论")

# ===== 第 4 步:随机查看(验证语料库有效性)=====
with open('movie_comments.txt', 'r', encoding='utf-8') as f:
    lines = f.readlines()
print(random.choice(lines).strip())pandas:Python 最常用的数据分析库,读表格文件是它的看家本领。例:
pd.read_csv()一行把 CSV 读成表格(DataFrame),之后df['comment']像按列名查字典一样取出评论列。
3 拓展任务:语料库词频 Top10
对建好的语料库做分词 + 停用词过滤 + 词频统计,提取出现频率最高的前 10 个词语:
import jieba
from collections import Counter

# ① 读取语料库文件,获取所有评论文本
with open('./data/movie_comments.txt', 'r', encoding='utf-8') as f:
    lines = [line.strip() for line in f if line.strip()]

# ② jieba 分词 + ③ 加载停用词过滤
stopwords = {'的', '了', '在', '是', '我', '有', '和', '就', '不', '都'}
words = []
for line in lines:
    words += [w for w in jieba.lcut(line)
              if len(w) > 1 and w not in stopwords]   # 顺带过滤单字

# ④ 词频统计 + ⑤ 取 Top10
word_count = Counter(words)
for word, count in word_count.most_common(10):
    print(f"词语: {word}  频次: {count}")
把 Top10 词语喂给上一讲的 WordCloud,还能生成电影评论词云图——第 1 讲的词云 + 第 2 讲的语料库,串成完整链路 👈
常见报错排查
| 现象 | 原因 | 解决办法 |
|---|---|---|
FileNotFoundError | 路径不对 | ratings.csv 和脚本放同一目录,或写全路径 |
KeyError: 'comment' | 列名写错 | print(df.columns) 先看真实列名 |
| 语料库里有很多空行 | 清洗后变空串也写入了 | 写文件前 if c: 判断跳过 |
读文件报 UnicodeDecodeError | 编码不匹配 | open(..., encoding='utf-8') |
| 中文全变乱码 | 写入没指定编码 | open(..., 'w', encoding='utf-8') |
自检
- 任务 2 的数据来源是?A.ratings.csv 的 comment 列 B.微博热搜 C.搜狗新闻语料库 D.手工录入
答案:A.使用已有 ratings.csv 数据文件,提取其中评论文本 - 构建好的语料库文件及格式要求是?A.movie_comments.txt,每条评论单独一行 B.movie.csv,逗号分隔 C.comments.json,键值对 D.任意格式均可
答案:A.预处理后的评论逐条写入 txt 文件,一行一条 - 用 pandas 读取 ratings.csv 的正确函数是?A.pd.read_csv() B.pd.open_csv() C.pd.load_excel() D.pd.read_table()
答案:A.read_csv 是 pandas 读 CSV 的标准函数,之后取 df["comment"] 列 - 数据预处理阶段,正则清洗要去除的内容是?A.标点符号、数字及多余空格 B.所有中文动词 C.少于 5 个字的评论 D.好评之外的评论
答案:A.去标点、数字、多余空格,规范文本格式,形成标准化语料 - 拓展任务要求提取词频排名前几的词语及次数并展示?A.前 5 B.前 10 C.前 20 D.全部
答案:B.jieba 分词 + 停用词过滤 + Counter 统计,取 Top 10
附本讲名词速查表
| 名词 | 一句话解释 | 出现位置 |
|---|---|---|
| 语料库(Corpus) | 为 NLP 研发收集组织的大量文本/语音数据集合,"课本+习题集" | 1.1 |
| 泛化能力 | 模型在没见过的数据上依然表现好的能力 | 1.2 |
| 标准数据集 | 公认用来"考试"的固定数据集,可横向比较各家模型 | 1.3 |
| 平行翻译文本 | 同一内容在两种语言里一一对应,机器翻译靠它"对答案" | 2.1 |
| 多模态 | 同时包含文字、图片、音频等多种类型信息 | 2.1 |
| 可追溯 | 数据"从哪来、怎么处理过"都有记录,像食品溯源码 | 2.2 |
| THUCNews | 清华开放中文语料库,新浪新闻分类数据集 | 3 |
| 正则表达式 | 用特殊符号写成的"筛选规则"字符串,匹配/查找/替换文本 | 4.1 |
| OpenCC | 专做中文繁简转换的库,t2s = 繁转简 | 4.2 |
| jieba | 最常用的中文分词库,给连续汉字加词语边界 | 4.3 |
| 分词 | 给连续的汉字加上词语边界,中文 NLP 第一道工序 | 4.3 |
| 生成器(generator) | "按需生产、用一次给一个",cut() 省内存的原因 | 4.3 |
| Counter | collections 库的数个数工具,most_common(n) 取 Top N | 4.4 |
| BeautifulSoup | 从网页 HTML 里"捞内容"的库,把正文从汤里捞出来 | 5.1 |
| 停用词 | "的、了、在"等高频无意义词,统计前必须过滤 | 5.1 |
| pandas | Python 最常用的数据分析库,read_csv 读表格是看家本领 | 6.2 |