part01-自然语言处理-绪论
part01-自然语言处理-绪论
学完本讲,你应该能够:
- 用自己的话解释什么是自然语言处理,说出它的三大核心目标。
- 按顺序说出 NLP 的四个发展阶段,以及每个阶段的代表性技术。
- 区分 NLP 的"基础任务"与"应用任务",各举出三个例子。
- 说出中文 NLP 的五个处理环节,并动手跑通一个中文词云图任务。
1.NLP概要
前言
1 什么是 NLP
我们每天都在用语言:发微信、写评论、问客服。这些文字对人来说很好懂,但对计算机来说只是一串没有意义的符号。
自然语言处理(Natural Language Processing,简称 NLP),就是让计算机学会理解、分析、生成人类语言的一门技术。
它不是一个单独的学科,而是三者的交叉:
| 学科 | 它贡献了什么 |
|---|---|
| 语言学 | 词语的构成、句子的结构、语义和语境 |
| 计算机科学 | 算法、数据结构、工程实现 |
| 人工智能 | 让机器从数据中自己学规律 |
语料 / 语料库:供计算机学习的文本材料,"语料"是一批文本,集合起来叫"语料库"。例:模型读了什么语料,就学会什么样的表达——语料相当于学生的课本和习题集,没有语料,模型就是巧妇难为无米之炊。
一句话记住 NLP 的定位:让机器从"看不懂字"到"读得懂、答得对、写得通" 👈
2 三大核心目标
| 目标 | 要解决的问题 | 生活中的例子 |
|---|---|---|
| 语言理解 | 机器能不能读懂这段话的意思 | 判断一条评论是好评还是差评 |
| 人机交互 | 人能不能用说话的方式指挥机器 | 智能客服、语音助手 |
| 语言生成 | 机器能不能自己写出通顺的话 | 自动摘要、机器翻译、作文辅助 |
3 市场价值:为什么值得学
| 地区 | 2025 年(亿美元) | 2030 年(亿美元) |
|---|---|---|
| 全球 | 336.8 | —(2037 年预计 7348.2) |
| 中国 | 180 | 350 |
| 美国 | 128.8 | 417.9 |
| 拉美 | 0.56 | 17.4 |
据中国 NLP 行业白皮书,中国已有 75% 的企业采用聊天机器人提升客服效率。这意味着:NLP 已经不是实验室里的概念,而是企业里真实在用的生产力工具。
开放模型 / 封闭模型:开放模型指权重公开、谁都可以下载使用的模型;封闭模型指只提供接口、看不到内部参数的模型。例:Llama 2 是开放模型(像公开配方的菜谱,可以自己改),GPT-4 是封闭模型(像餐厅招牌菜,好吃但不知道怎么做)。2025 年两者性能差距已缩窄到 1.7%。
2.NLP发展历程
前言
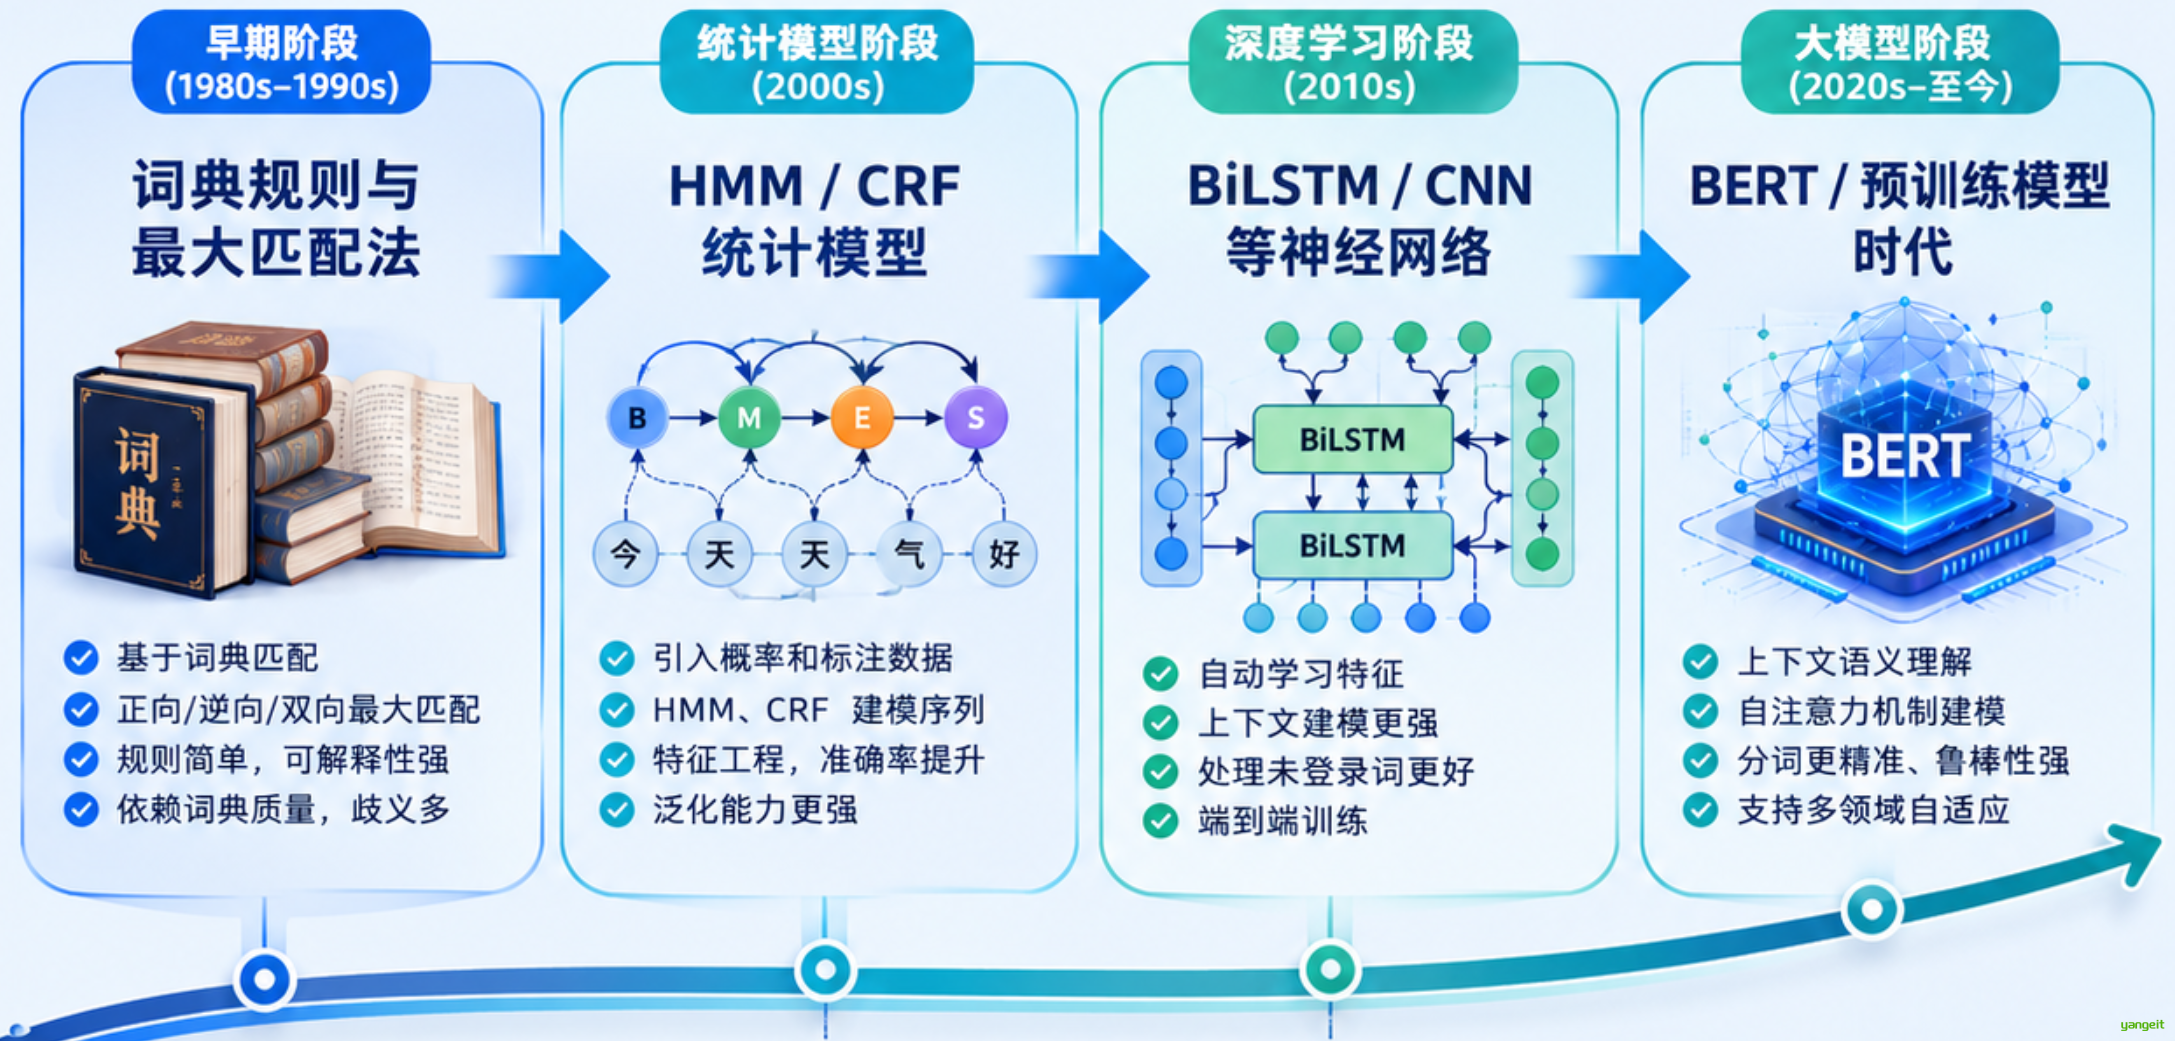
NLP 不是一夜之间出现的,它经历了四次技术路线的更替。
| 阶段 | 时间 | 核心思路 | 代表性成果 |
|---|---|---|---|
| 规则时代 | 1950s | 人手写规则,让机器照着做 | 图灵测试提出,出现首个句法分析器 |
| 统计时代 | 1990s | 从大量语料中统计概率 | 语料库建设、机器学习方法普及 |
| 深度学习革命 | 2010s | 用神经网络自己学特征 | Word2Vec 词向量、Transformer 架构 |
| 大模型时代 | 2020s 至今 | 超大规模预训练 + 微调 | GPT-4o、InternLM3,中美差距缩至 0.3%–8.1% |
图灵测试:1950 年图灵提出的思想实验——如果人通过文字对话分不出对面是人还是机器,就认为这台机器具备智能。例:相当于给 AI 办一场"闭眼面试",只看回答内容,不看外表;它是"机器能否思考"的第一个可操作标准。
预训练 + 微调:先用海量文本把模型训练一遍(预训练),再用你自己的少量数据针对性训练一遍(微调)。例:预训练像读完整个图书馆打底子,微调像考前刷真题针对性提分——这是大模型时代的标准做法。
2023–2025 的三个新方向
| 方向 | 在做什么 | 典型成果 |
|---|---|---|
| 模型轻量化 | 用小参数量逼近大模型效果 | 8B 参数模型性能接近大模型,显存只要 4.1GB |
| 推理增强 | 让模型学会逐步推理,而不只是猜答案 | 南京大学 R-PRM 数学推理准确率超教师模型 11.9% |
| 多模态融合 | 同时理解文字、图片、声音 | GPT-4o 支持文本—图像跨模态交互 |
参数量(如 8B):模型内部可调节的"旋钮"数量,8B 就是 80 亿个。例:参数越多模型记的东西越多,但也越吃内存——轻量化就是"不明显变笨的前提下把模型变小",8B 小模型普通显卡就能跑,大模型要服务器。
多模态:模型能同时处理文字、图片、音频等多种类型的信息。例:以前模型是"只读文字的书生",多模态模型是"能看图、能听话、还能说话的人"——真实场景的文档常常图文混排,只会读文字的模型处理不了。
自检
- Word2Vec 与 Transformer 出现在哪个阶段?A.规则时代 B.统计时代 C.深度学习革命 D.大模型时代
答案:2010s 深度学习革命时期 - 图灵测试的提出属于哪个阶段?A.1950s B.1990s C.2010s D.2020s
答案:1950s 规则时代,也是 NLP 的起点 - 关于模型轻量化,正确的是?A.模型越大效果一定越好 B.8B 参数模型性能接近大模型,显存仅 4.1GB C.轻量化模型不能用于中文 D.轻量化意味着不需要训练
答案:A.模型轻量化 = 用更小参数量逼近大模型效果,普通设备也能部署 - GPT-4o 支持文本—图像跨模态交互属于哪类突破?A.模型轻量化 B.推理增强 C.多模态融合 D.语料库建设
答案:C.同时理解文本和图像属于多模态融合 - 统计时代的核心思路是?A.人手写规则让机器照做 B.从大量语料中统计概率 C.用神经网络自己学特征 D.超大规模预训练+微调
答案:B.统计时代靠语料库和概率统计取代人工规则
3.核心技术与任务体系
前言
NLP 的任务分成两层:下面一层打地基,上面一层做业务。
| 层次 | 任务 | 说明 |
|---|---|---|
| 基础任务 | 词法分析(分词、词性标注) | 把句子切成词,并标出每个词是什么词性 |
| 句法分析 | 分析句子的语法结构,谁修饰谁 | |
| 语义分析 | 理解句子真正的含义 | |
| 应用任务 | 机器翻译 | 一种语言翻译成另一种语言 |
| 文本分类 | 把文本分到预设的类别里 | |
| 情感分析 | 判断文本表达的情绪倾向 | |
| 问答系统 | 根据问题给出答案 | |
| 信息检索 | 从大量文本中找到需要的内容 |
词法 / 句法 / 语义分析:三个由浅入深的理解层次。例:把它们想成语文课的三道题——词法分析=划词语、标词性("服务"是名词);句法分析=划句子成分(主谓宾定状补);语义分析=概括中心思想(这段话到底想说啥)。多数应用任务只用到词法层。
命名实体识别(NER):从文本中找出人名、地名、机构名、时间、金额等特定类别的词。例:像给文本做荧光笔标注,把"张三""长沙""2026年9月"标出来——信息抽取、知识图谱都靠它把非结构化文本变成结构化数据。
信息检索:从海量文本里找出与需求相关的内容,并按相关度排序。例:就是图书馆检索台 + 搜索引擎的结合体,你给关键词,它给结果;问答系统、企业知识库、RAG 都建立在它之上。
自检
- 下列属于"基础任务"的是?A.机器翻译 B.情感分析 C.词性标注 D.问答系统
答案:C.词性标注属于词法分析,是基础任务 - "概括这段话的中心思想"最对应哪个任务层次?A.词法分析 B.句法分析 C.语义分析 D.信息检索
答案:C.语义分析 = 概括中心思想 - 命名实体识别(NER)的任务是?A.把文本分到预设类别 B.从文本中找出人名、地名、机构名等特定词 C.翻译文本 D.自动写摘要
答案:B.命名实体识别(NER)像给文本做荧光笔标注,把"张三""长沙""2026年9月"标出来 - 信息检索要做的事情是?A.从海量文本中找出相关内容并按相关度排序 B.判断情感倾向 C.把句子切成词语 D.标出每个词的词性
答案:A.信息检索 = 从海量文本中找出相关内容并按相关度排序,相当于图书馆检索台 + 搜索引擎 - 基础任务与应用任务的关系是?A.完全没有关系 B.基础任务的输出常作为应用任务的输入 C.应用任务先做,基础任务后做 D.两者互相排斥
答案:B.基础任务的输出常作为应用任务的输入
4.典型应用场景
前言
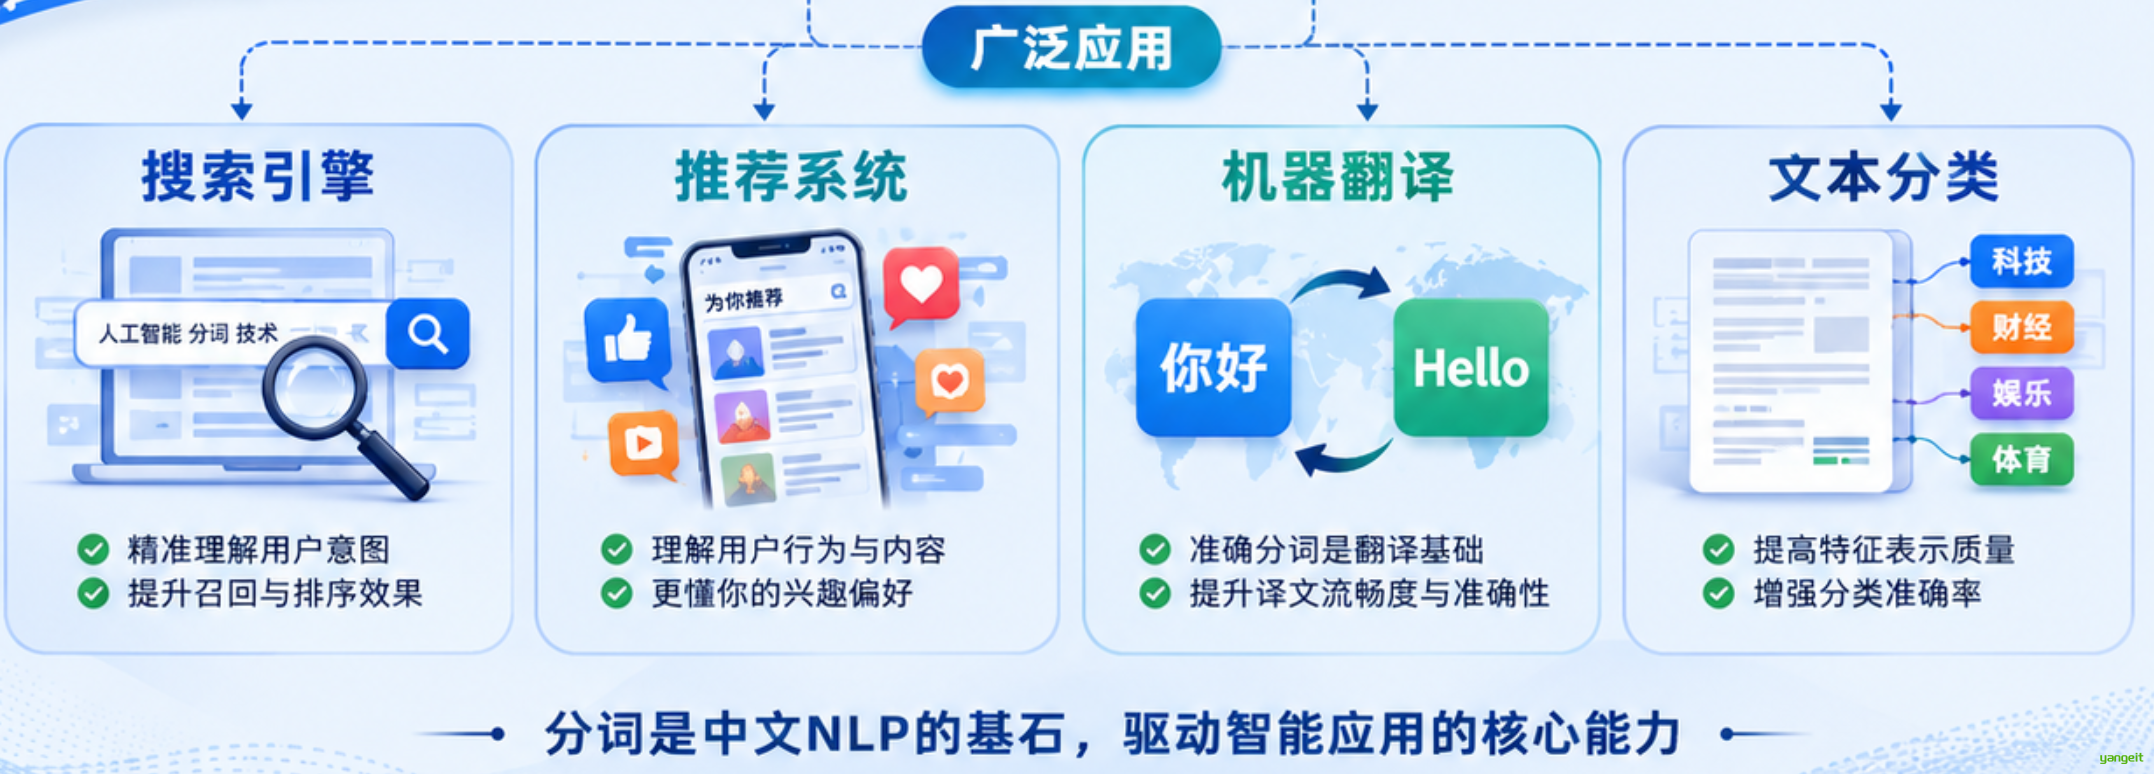
学 NLP 最实在的问题是:它到底能干什么活?
| 领域 | 在做什么 | 实测效果 |
|---|---|---|
| 教育 | 个性化学习路径生成、智能批改 | 批改效率提升约 30% |
| 医疗 | 病历分析、辅助诊断 | Phi-2 辅助诊断效率提升约 50% |
| 客服 | 电商对话系统、自动应答 | 响应时间缩短约 60% |
| 内容创作 | 论文撰写辅助、多语言翻译 | GPT-4 翻译准确率超过 95% |
智能批改:用模型自动评阅作业、作文,给出分数和修改建议。例:相当于给老师配了一个不知疲倦的助教,先帮你看完 100 份作业的错别字和语法,老师再重点看立意——但哪些交给机器、哪些必须老师看,要划清边界。
对话系统:能与人多轮对话、完成特定任务的系统。例:它不是"问答库",而是带记忆的接线员——记得你上一句说了什么,能接着往下聊;企业落地最多、最容易见到投入产出比的 NLP 应用。
自检
- 教育领域智能批改的实测效果是?A.批改效率提升约 30% B.诊断效率提升约 50% C.响应时间缩短约 60% D.翻译准确率超过 95%
!!答案:A.批改效率提升约 30% - 医疗领域 Phi-2 辅助诊断的效果是?A.批改效率提升约 30% B.诊断效率提升约 50% C.响应时间缩短约 60% D.翻译准确率超过 95%
!!答案:B.诊断效率提升约 50% - 电商客服对话系统的实测效果是?A.批改效率提升约 30% B.诊断效率提升约 50% C.响应时间缩短约 60% D.翻译准确率超过 95%
!!答案:C.响应时间缩短约 60% - 内容创作领域 GPT-4 多语言翻译的准确率?A.超过 85% B.超过 90% C.超过 95% D.超过 99%
!!答案:C.超过 95% - 对话系统与普通"问答库"最大的区别是?A.带记忆、能多轮对话 B.运行速度更快 C.不需要任何数据 D.只能回答一个问题
答案:A.对话系统与普通"问答库"最大的区别是:对话系统带记忆、能多轮对话
5.中文NLP的挑战与突破
前言
英文单词之间有空格,中文没有。这一个差别,带来了一连串的难题。
| 挑战 | 具体表现 | 例子 |
|---|---|---|
| 字词组合复杂 | 没有明显词边界,必须先分词 | 需要 jieba、HanLP 等分词工具 |
| 语序灵活与歧义 | 同一句话可以有多种理解 | "咬死了猎人的狗" |
| 多音字 / 同音字 | 同形不同音,语义不同 | "行"读 xíng(行走)/ háng(银行) |
| 语义隐含 | 依赖文化背景,字面看不出来 | 成语、隐喻、歇后语 |
| 资源相对匮乏 | 高质量中文语料少于英文 | CPM-Bee 等国产模型正在补短板 |
歧义句到底难在哪
"咬死了猎人的狗"这句话有两种完全不同的理解:
- 狗是凶手:那条狗把猎人咬死了。
- 狗是受害者:猎人养的狗被(别的动物)咬死了。
人能靠常识和上下文秒懂,机器却必须靠结构和概率去判断——这就是"歧义"的难处。
分词:把连续的汉字序列切成一个个有意义的词。例:"我爱人工智能" → "我 / 爱 / 人工智能",相当于给一整串没断句的拼音加上空格和标点;分词错了后面全错——"南京市长江大桥"切错就会把"市长"当成一个人。
停用词:出现频率极高但几乎没有实际意义的词,如"的、了、和、在、也、很"。例:就像一碗汤里的浮沫,看着多,捞掉才见真材实料——做词频统计、词云时不去停用词,画面会被"的、了"占满。
自检
- "咬死了猎人的狗"体现的是哪种挑战?A.资源匮乏 B.语序灵活与歧义性 C.缺少字母 D.编码问题
答案:B.语序灵活与歧义性,同一句话可以有多种理解 - 中文没有词边界,要用什么?A.分词工具 B.更大的显示器 C.更快的网络 D.英文词典
答案:A.分词工具,jieba、HanLP、THULAC 都是常用中文分词工具 - 解决中文没有词边界的问题,要用什么?A.分词工具 B.更大的显示器 C.更快的网络 D.英文词典
答案:A.分词工具,jieba、HanLP、THULAC 都是常用中文分词工具 - "行"读 háng 时,对应的词语是?A.行走 B.银行 C.行不行 D.行动
答案:B.银行,háng 表示"机构/职业/次序"(银行、行业、排行) - 做词频统计、词云时要去掉停用词,因为?A.它们太长影响排版 B.它们高频但无意义,会盖住主题词 C.它们无法被分词 D.它们会导致报错
答案:B.它们高频但无意义,会盖住主题词,停用词像汤里的浮沫,捞掉才见真材实料 - "画蛇添足""胸有成竹"这类成语让模型难以理解,属于哪种挑战?A.字词组合复杂 B.多音字问题 C.语义隐含 D.资源匮乏
答案:C.语义隐含,成语、隐喻依赖文化背景,字面推不出来
6.中文NLP基本流程
前言
拿到一段中文文本,从原始字符串到能用的结论,要走完五个环节。
| 环节 | 做什么 | 输出长什么样 |
|---|---|---|
| ① 数据获取 | 采集文本(公开数据集、爬虫) | 一堆原始文本 |
| ② 预处理 | 分词、去停用词、词性标注 | 干净的词语列表 |
| ③ 特征工程 | 把词转成数字向量 | 一串数字 |
| ④ 模型构建 | 用模型完成具体任务 | 分类/情感/实体等结果 |
| ⑤ 评估优化 | 用指标衡量效果并调参 | 准确率、F1 值,决定是否重来 |
下面逐个环节拆开看(以句子"这家餐厅的服务态度非常好,菜品也很新鲜。"为例)。
1️⃣ 数据获取
原始文本:这家餐厅的服务态度非常好,菜品也很新鲜。
2️⃣ 预处理
先分词,再去停用词:
分词结果:这家 / 餐厅 / 的 / 服务 / 态度 / 非常 / 好 / , / 菜品 / 也 / 很 / 新鲜 / 。
去停用词后:这家、餐厅、服务、态度、非常、好、菜品、新鲜
3️⃣ 特征工程
计算机不认识汉字,只认识数字,所以要把词变成向量。
词向量 / 词嵌入:用一组数字(比如 100 个数)来表示一个词,意思相近的词,数字也相近。例:相当于给每个词发一张身份证 + 坐标,放到一张"语义地图"上——"国王"和"王子"挨得近,"国王"和"白菜"离得远;有了坐标就能算"两个词有多像"。
TF-IDF:一种给词打权重的方法——一个词在这篇文章里出现越多(TF),在别的文章里出现越少(IDF),它就越能代表这篇文章。例:就像判断一个人的口头禅——他天天说(词频高),别人都不说(独特性强),这句话就是他的特征;这是最经典的 baseline(基线方法)。
4️⃣ 模型构建
选一个模型来完成任务:传统机器学习用 SVM,深度学习用 Transformer。本例输出:正面情感。
SVM 与 Transformer:SVM 是传统机器学习方法,靠找一条"分界线"把样本分开;Transformer 是深度学习架构,靠注意力机制理解上下文。例:SVM 像一把尺子量到底,简单快速;Transformer 像一个读过海量文本的人,能结合上下文理解,但更吃算力——小数据快任务 SVM 仍好用,语义理解任务现在是 Transformer 的天下。
注意力机制:让模型在处理某个词时,自动决定"该重点看句子里的哪些其他词"。例:像人读句子时的目光焦点——读到"它"的时候,你会自动回头去看"它"指的是谁;它是 Transformer 的核心。
5️⃣ 评估优化
模型跑完不能拍脑袋说"效果不错",要用数字说话。
准确率:预测正确的样本数 ÷ 全部样本数。例:100 道题做对 92 道,准确率 92%。但它在样本不均衡时会骗人——100 条评论 95 条好评,模型全部猜"好评"也有 95% 准确率,可一条差评都没抓出来。
精确率:我判定为正的样本里,真正为正的比例——衡量"查得准不准"。例:模型判 100 条是好评,其中 90 条真是好评,精确率 0.9;精确率低 = 冤枉了好人(把差评误判成好评)。
召回率:真正为正的样本里,被找出来的比例——衡量"查得全不全"。例:全部好评有 100 条,模型只找出 80 条,召回率 0.8;召回率低 = 放走了坏人(漏掉了差评)。
F1 值:精确率和召回率的调和平均数,取值 0~1,越接近 1 越好。例:像偏科看总分——精确率高但召回率低,或反过来,F1 都会被拉低;只有两项都高 F1 才高。不知道该看哪个指标时,看 F1 一般不会错。
本例结果:准确率 92.4%,F1 值 0.91 → 模型可用;想再提升,最直接的办法是补充语料,而不是反复调参。
自检
- 分词、去停用词、词性标注属于哪一步?A.数据获取 B.预处理 C.特征工程 D.评估优化
答案:B.预处理 - TF-IDF / Word2Vec 向量化的目的是什么?A.让文本更好看 B.让计算机能处理数字 C.减少存储空间 D.加快网络传输
答案:B.让计算机能处理数字 - 100 条评论里 95 条好评,模型全猜"好评"得到 95% 准确率但一条差评没抓出来,说明?A.模型效果很好 B.样本不均衡时准确率会骗人 C.好评太多是数据错误 D.应该删掉差评
答案:B.样本不均衡时准确率会骗人 - 评估情感分析模型时,"精确率低"意味着?A.查得很准 B.冤枉了好人——把对的判错了 C.查得很全 D.没有任何影响
答案:精确率低=冤枉好人;召回率低=放走坏人。 - F1 值是哪两个指标的调和平均?A.准确率和精确率 B.精确率和召回率 C.召回率和准确率 D.准确率和错误率
答案:F1 = 精确率与召回率的调和平均,像偏科看总分。
精确率:我判定为正的样本里,真正为正的比例——衡量"查得准不准"。,召回率:真正为正的样本里,被找出来的比例——衡量"查得全不全"。他们是相反的,所以F1值是调和平均数,取值0-1,越接近1越好。
7.Python开发环境搭建
前言
1️⃣ 为什么选 Python
| 优势 | 说明 |
|---|---|
| 开发效率高 | 同样的功能,代码量往往只有 Java 的几分之一 |
| 社区活跃 | 遇到问题基本都能搜到答案 |
| 库生态丰富 | NLP 需要的工具几乎都有现成的包 |
Conda / PyPI:都是 Python 的"应用商店"。PyPI 是官方包仓库(用
pip install装包);Conda 是 Anaconda 自带的包与环境管理器(用conda install装包)。例:PyPI 像手机自带应用商店,Conda 像一个还能帮你分身管理环境的应用商店——不同项目需要不同版本的库,靠 Conda 环境隔离,避免"装了 A 项目把 B 项目搞崩"。
2️⃣ 常用工具一览
| 工具 | 用途 | 什么时候用 |
|---|---|---|
| jieba | 中文分词(精确模式) | 几乎所有中文任务的第一步 |
| HanLP | 词性标注、命名实体识别 | 需要语法/实体信息时 |
| PyTorch / TensorFlow | 深度学习框架 | 自己训练模型时 |
| Hugging Face Transformers | 加载 BERT / GPT 等预训练模型 | 想直接用现成的大模型时 |
| THULAC | 清华分词工具 | jieba 之外的备选 |
| CPM-Bee | 国产百亿参数开源模型 | 需要中文大模型且要求可商用时 |
预训练模型与微调:别人已经用海量数据训练好的模型,你直接拿来用,或用自己的数据再训一遍(微调)。例:模型是已经大学毕业的通才,微调就是让他实习三个月变成你行业的专才——从零训练要几百万,微调只要几百块和几百条数据,这是普通人用上大模型的唯一现实路径。
3️⃣ Anaconda 安装四步
- 官网下载:https://www.anaconda.com/
- 自定义路径:建议安装在非系统盘(如 D 盘),避免 C 盘爆满 👈
- 配置环境变量:在系统 Path 中添加
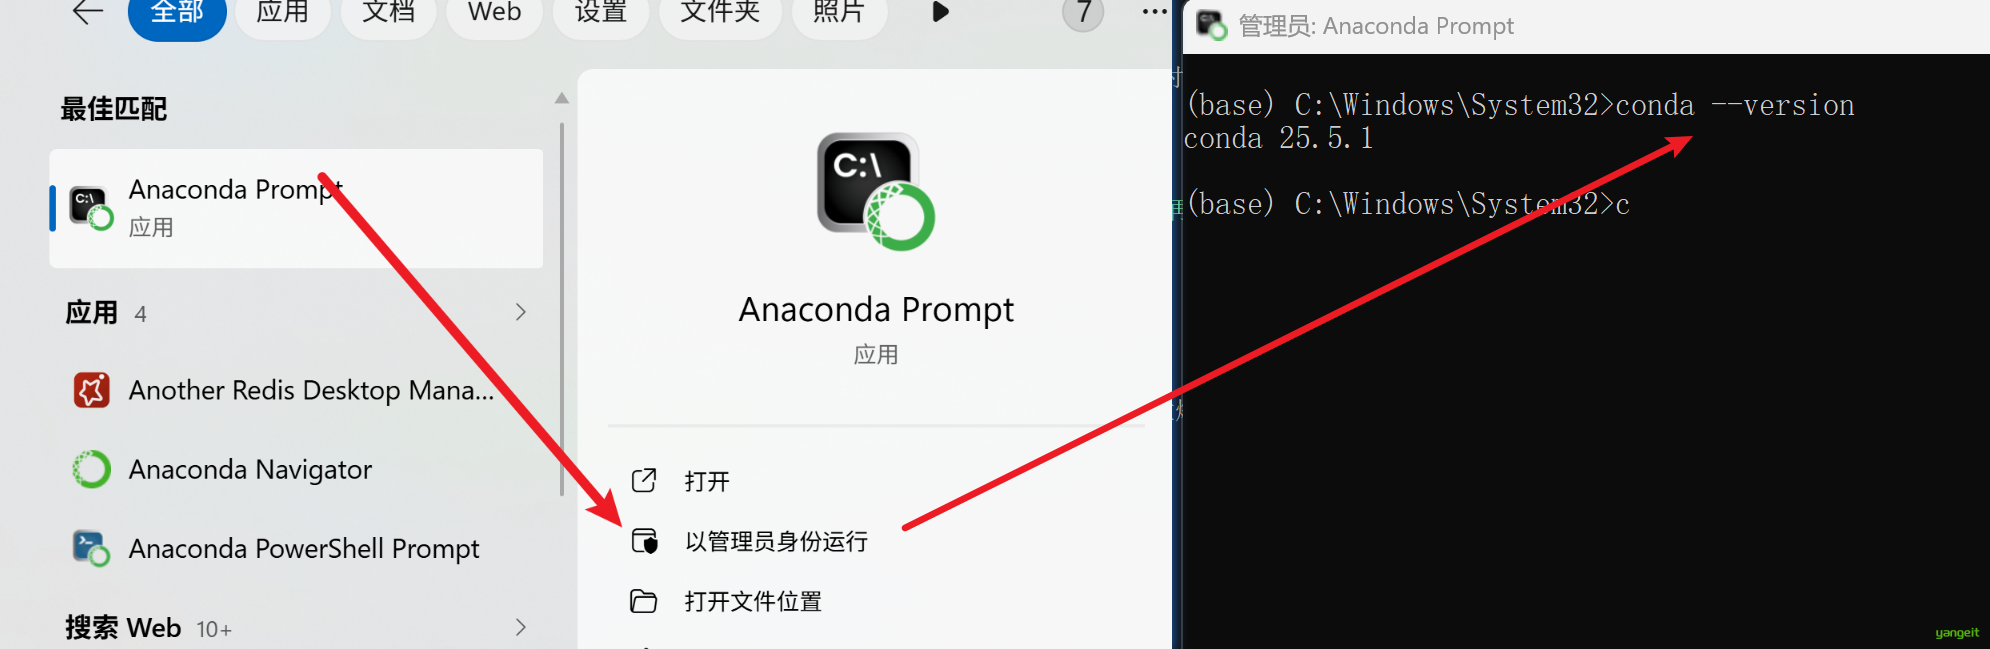
Anaconda/Scripts和Anaconda/Library/bin两个目录 - 验证安装:打开命令行输入
conda --version
python
能显示版本号即安装成功。
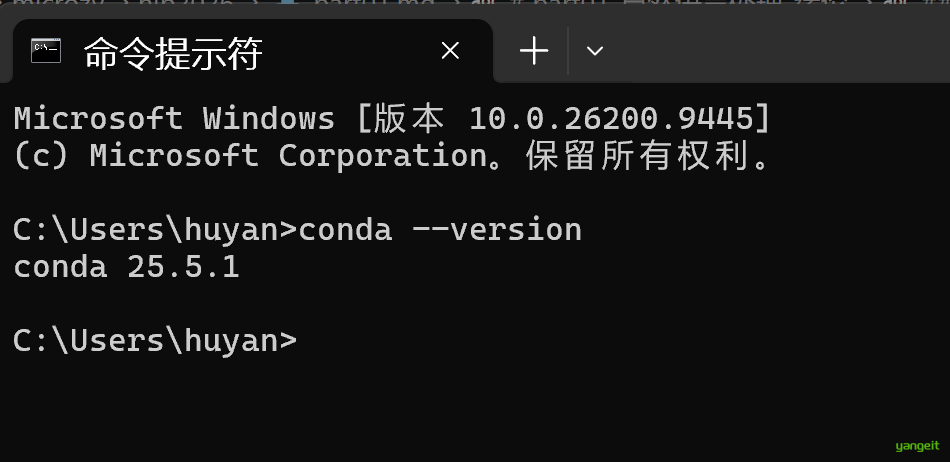
也可以直接调用 conda的控制台
4️⃣ Jupyter Notebook 安装和启动
Jupyter Notebook是基于网页的用于交互计算的应用程序。其可被应用于全过程计算:开发、文档编写、运行代码和展示结果。——Jupyter Notebook官方介绍
简而言之,Jupyter Notebook是以网页的形式打开,可以在网页页面中「直接」编写代码和运行代码,代码的运行结果也会直接在代码块下显示。如在编程过程中需要编写说明文档,可在同一个页面中直接编写,便于作及时的说明和解释。
8.Jupyter Notebook ✏️
Jupyter Notebook
Jupyter Notebook是基于网页的用于交互计算的应用程序。其可被应用于全过程计算:开发、文档编写、运行代码和展示结果。——Jupyter Notebook官方介绍
简而言之,Jupyter Notebook是以网页的形式打开,可以在网页页面中「直接」编写代码和运行代码,代码的运行结果也会直接在代码块下显示。如在编程过程中需要编写说明文档,可在同一个页面中直接编写,便于作及时的说明和解释。
1. 安装Jupyter Notebook
因为已经安装了Anaconda,所以Jupyter Notebook已经安装好了,无需单独安装。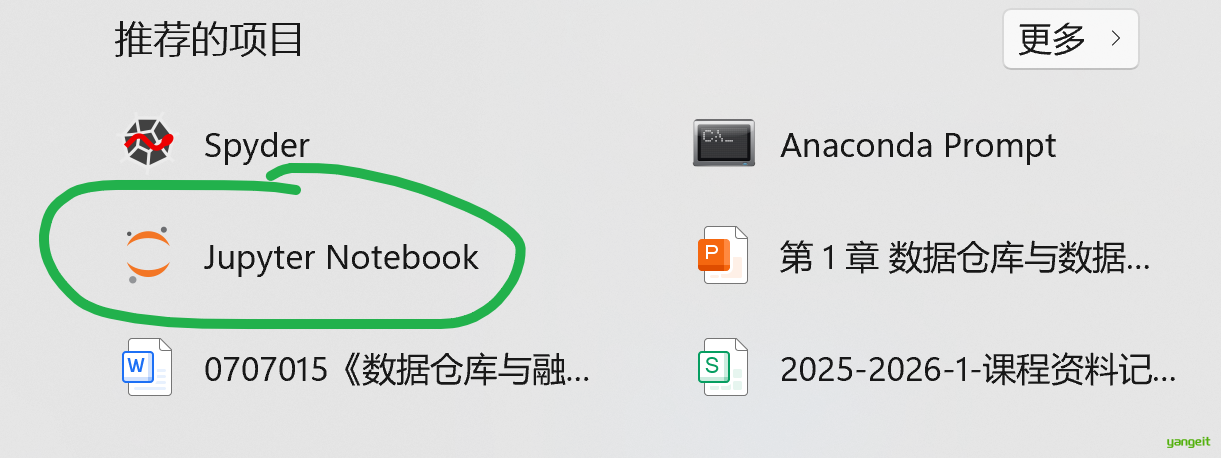
直接在开始菜单中找到图标,点击即可打开即可
如果没有图标,则在Anaconda Prompt中输入以下命令:
jupyter notebook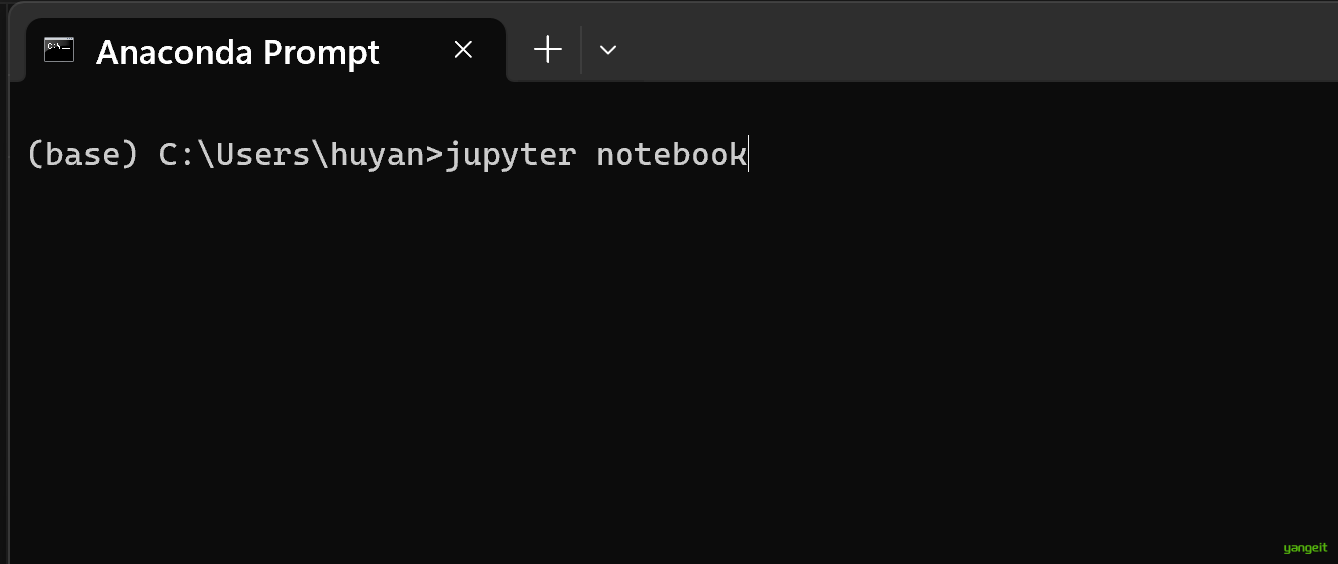
自动打开浏览器,自动跳转到Jupyter Notebook的首页。
当执行完启动命令之后,浏览器将会进入到Notebook的主页面,如下图所示。
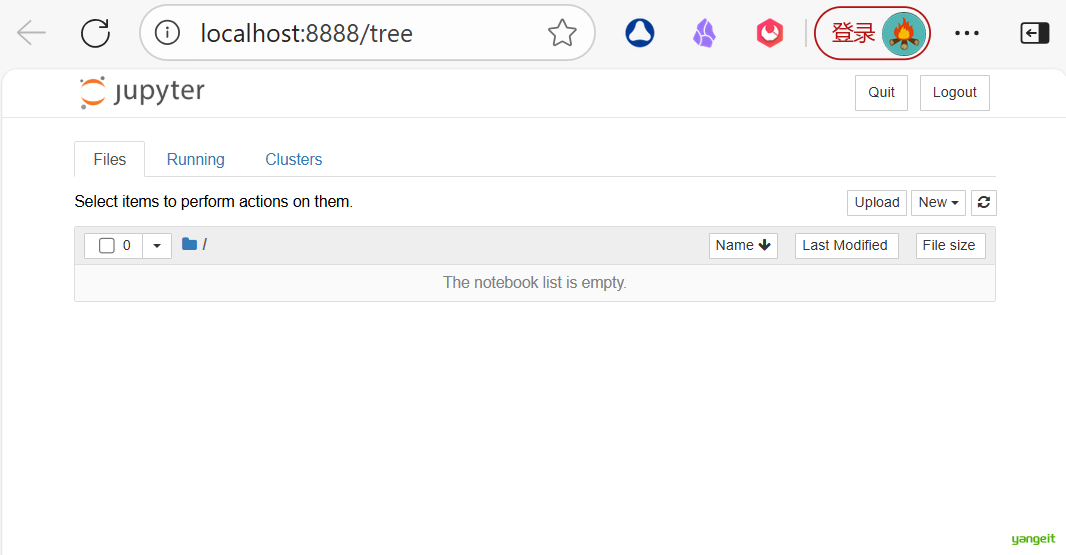
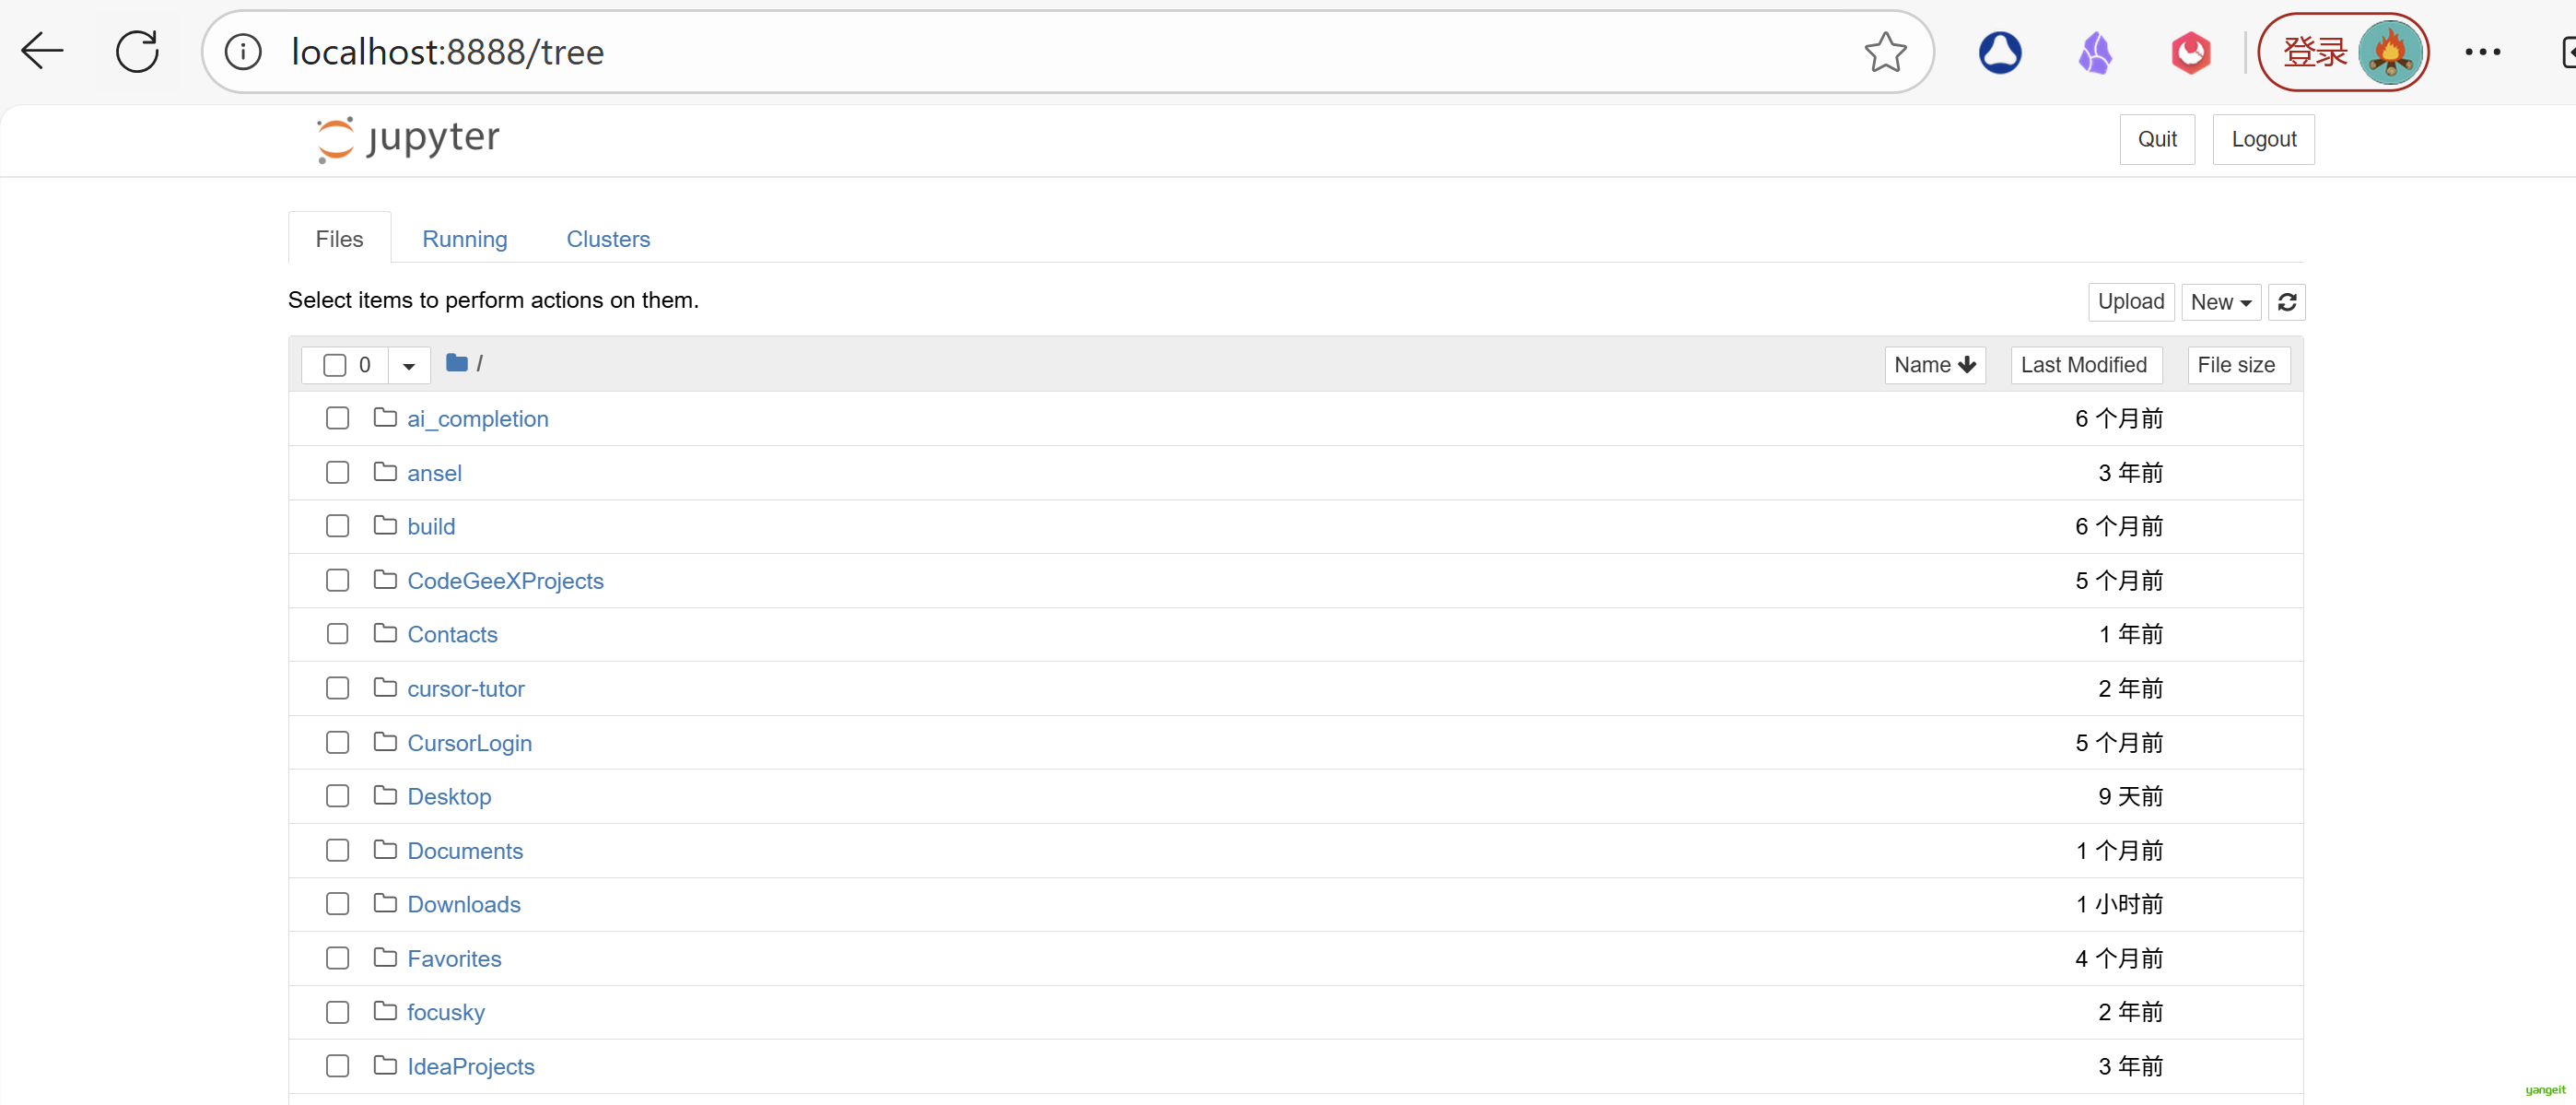
如果你的主页面里边的文件夹跟我的不同,或者你在疑惑为什么首次启动里边就已经有这么多文件夹,不要担心,这里边的文件夹全都是你的家目录里的目录文件。接下来
我们设置Jupyter Notebook文件存放位置:
- 在非中文目录下创建一个文件夹,例如:
D:\javasoftware\jupyter_notebook - 在Anaconda Prompt中输入以下命令:
# 生成配置文件
jupyter notebook --generate-config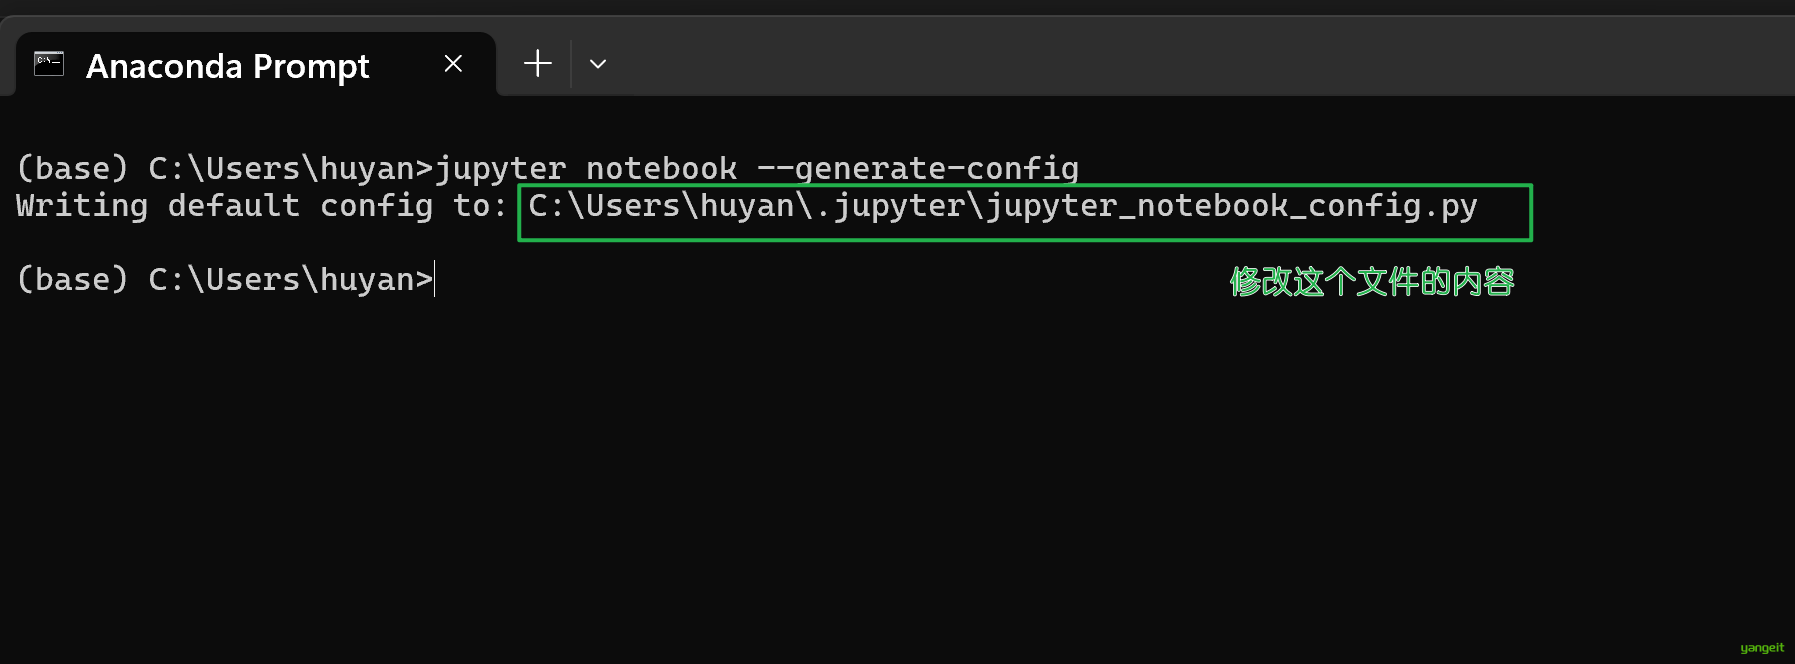
- 打开生成的配置文件,找到以下内容,修改为:
# c.NotebookApp.notebook_dir = ''
c.NotebookApp.notebook_dir = 'D:\\javasoftware\\jupyter_notebook'
- 保存并关闭配置文件,重新启动Jupyter Notebook,即可看到文件已经改变到我们指定的目录下。
2. Jupyter Notebook界面介绍
主页面内容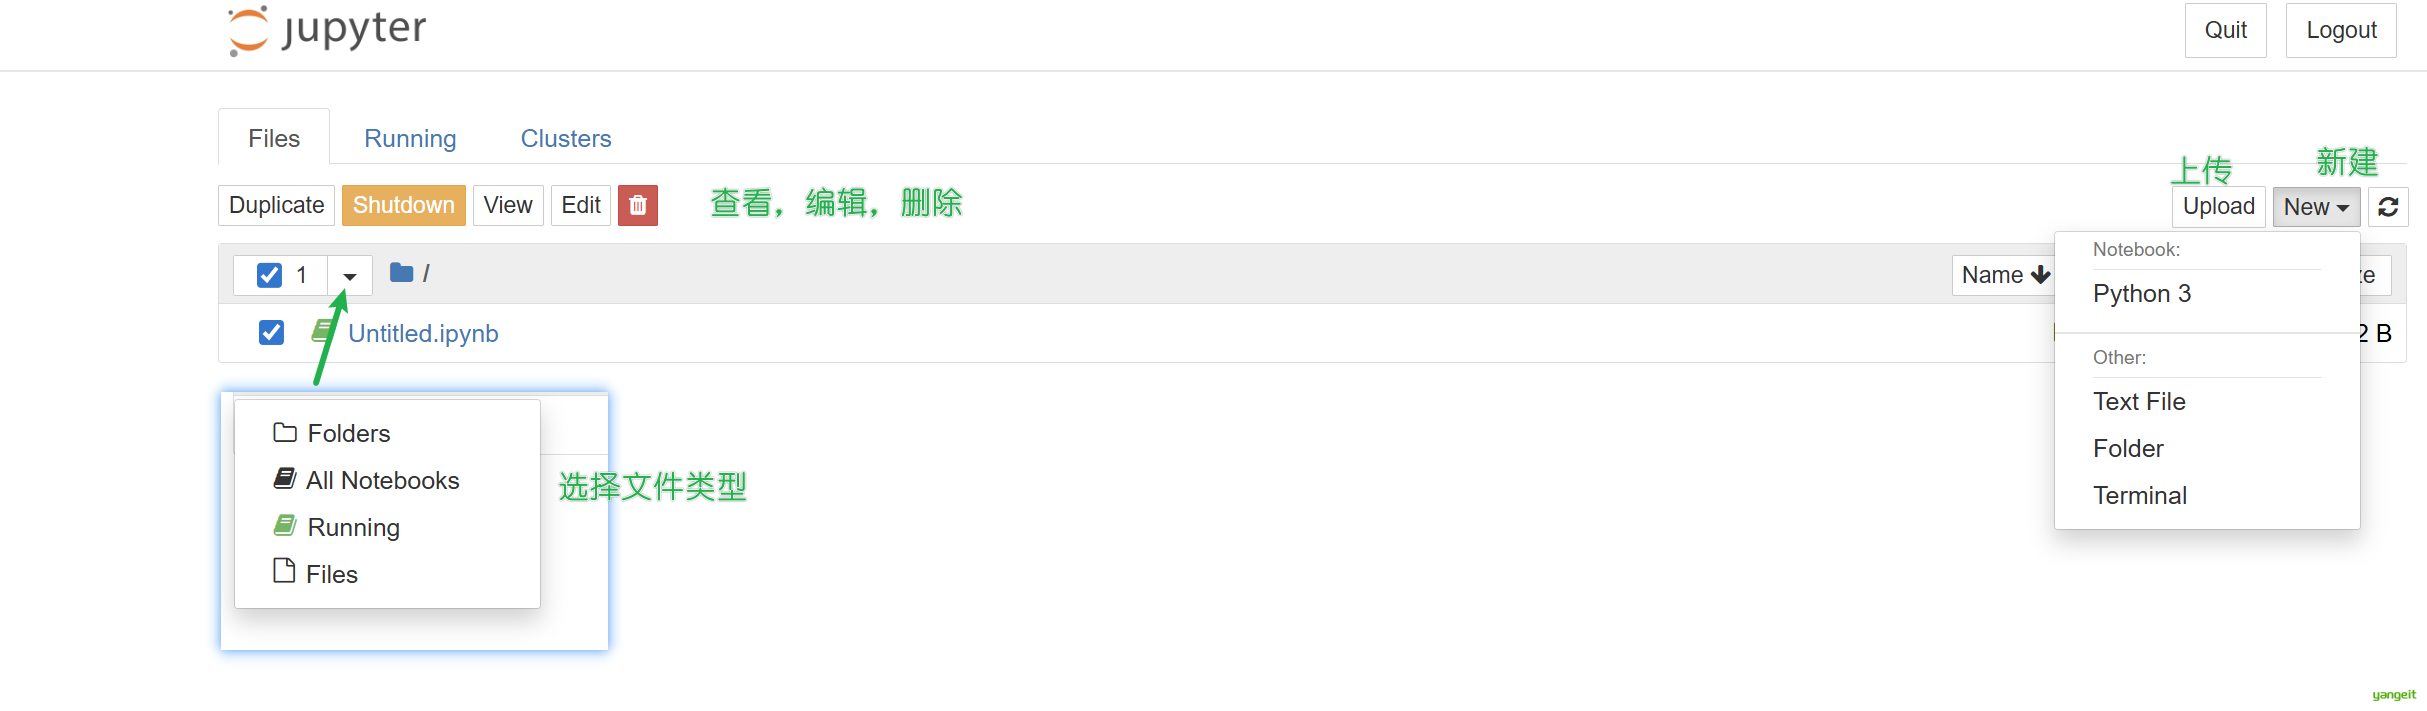
编辑界面(Notebook Editor)
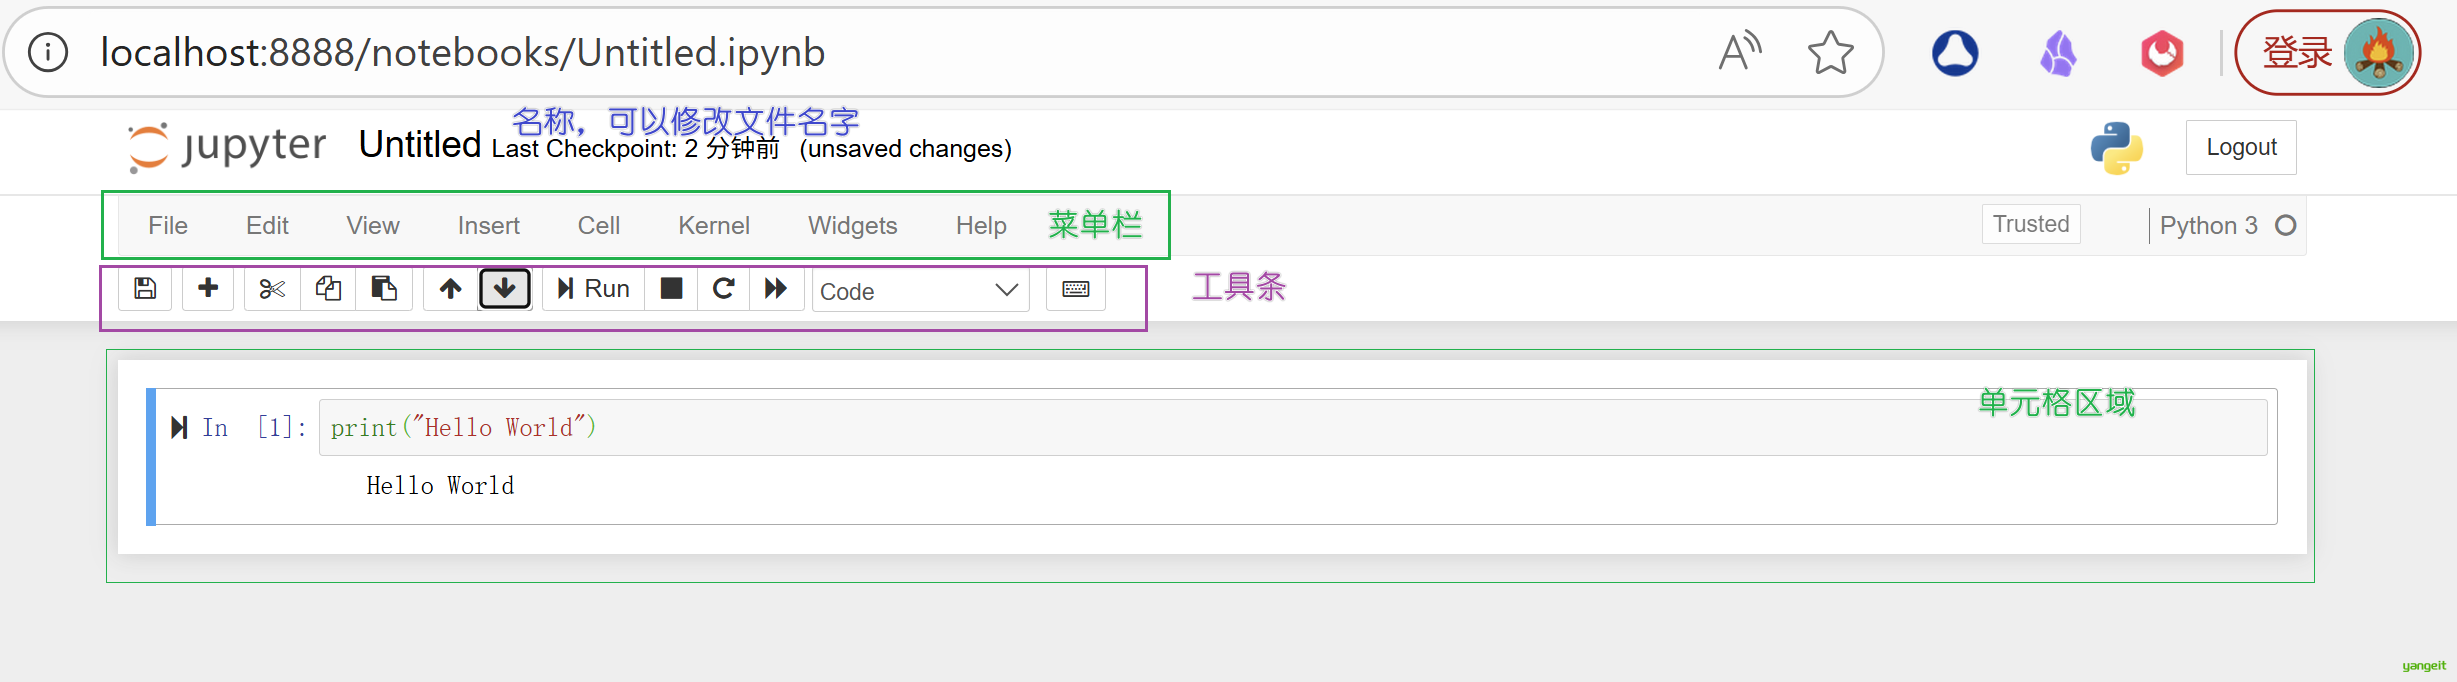
一个notebook的编辑界面主要由四部分组成:名称、菜单栏、工具条以及单元(Cell),如下图所示:
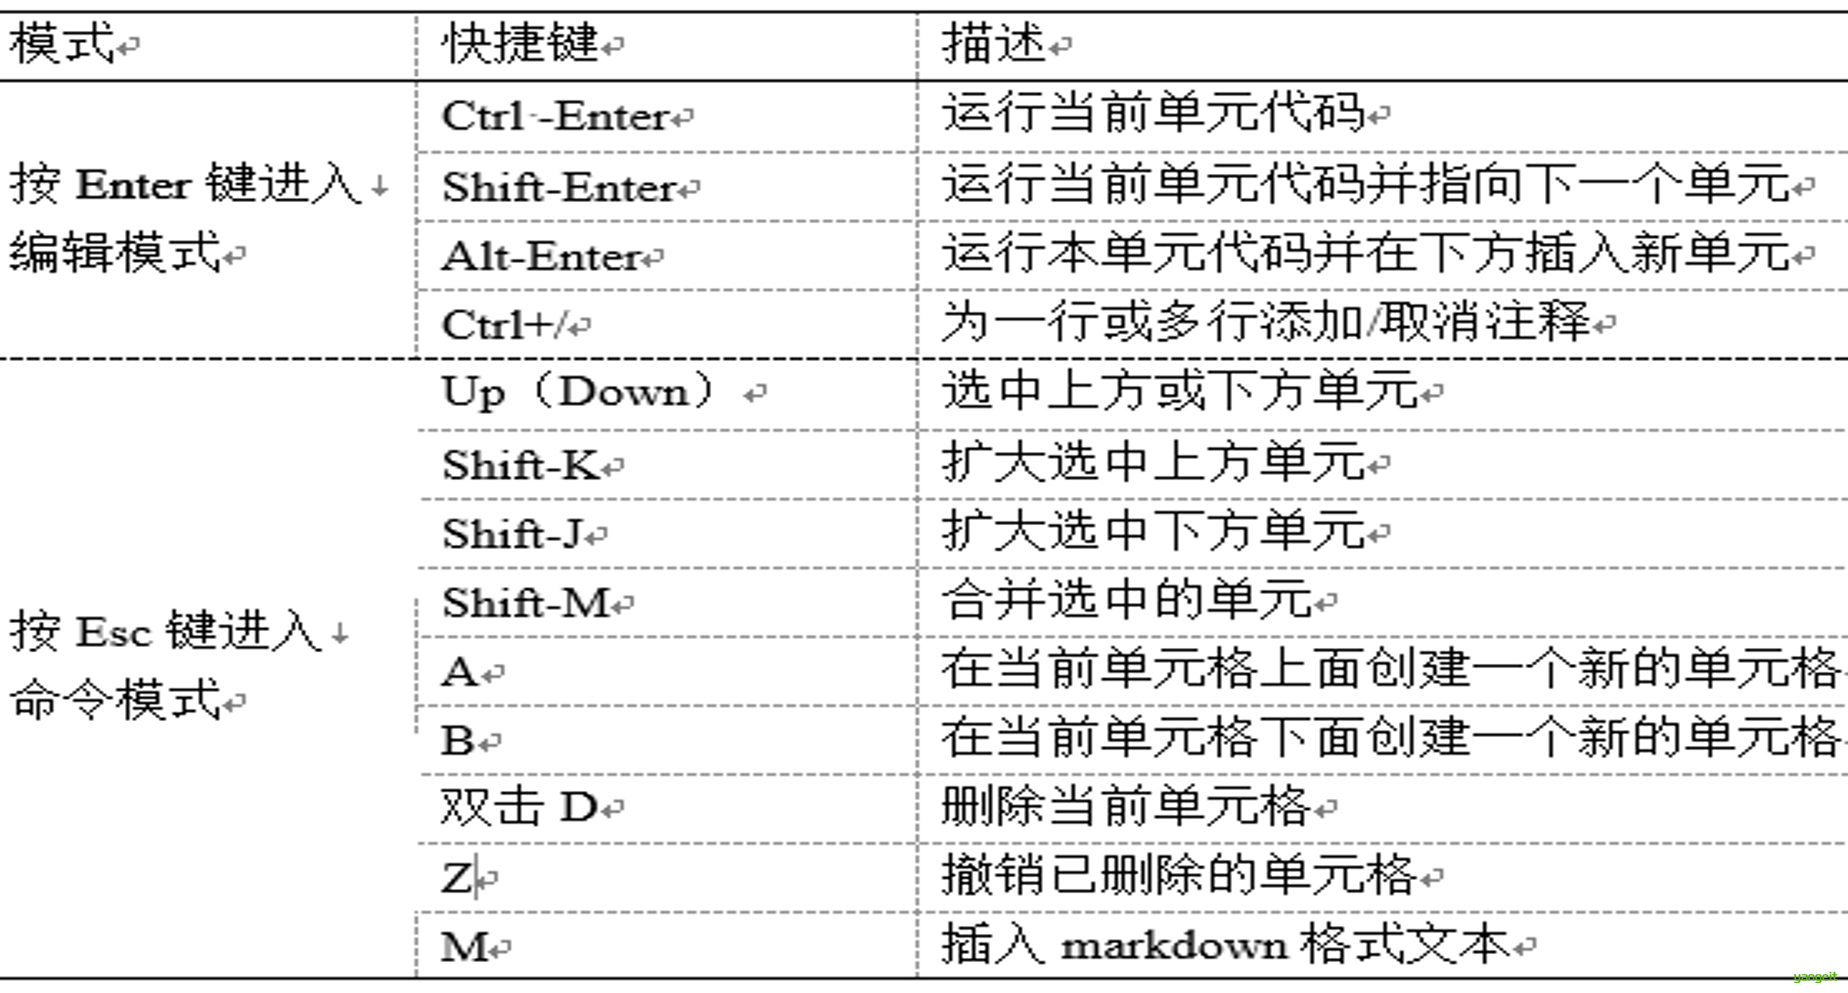
3. Jupyter Notebook的常用快捷键
好,接下来,我们在Jupyter Notebook中编写第一个程序,来体验一下Jupyter Notebook的强大之处吧!!
print("Hello World!")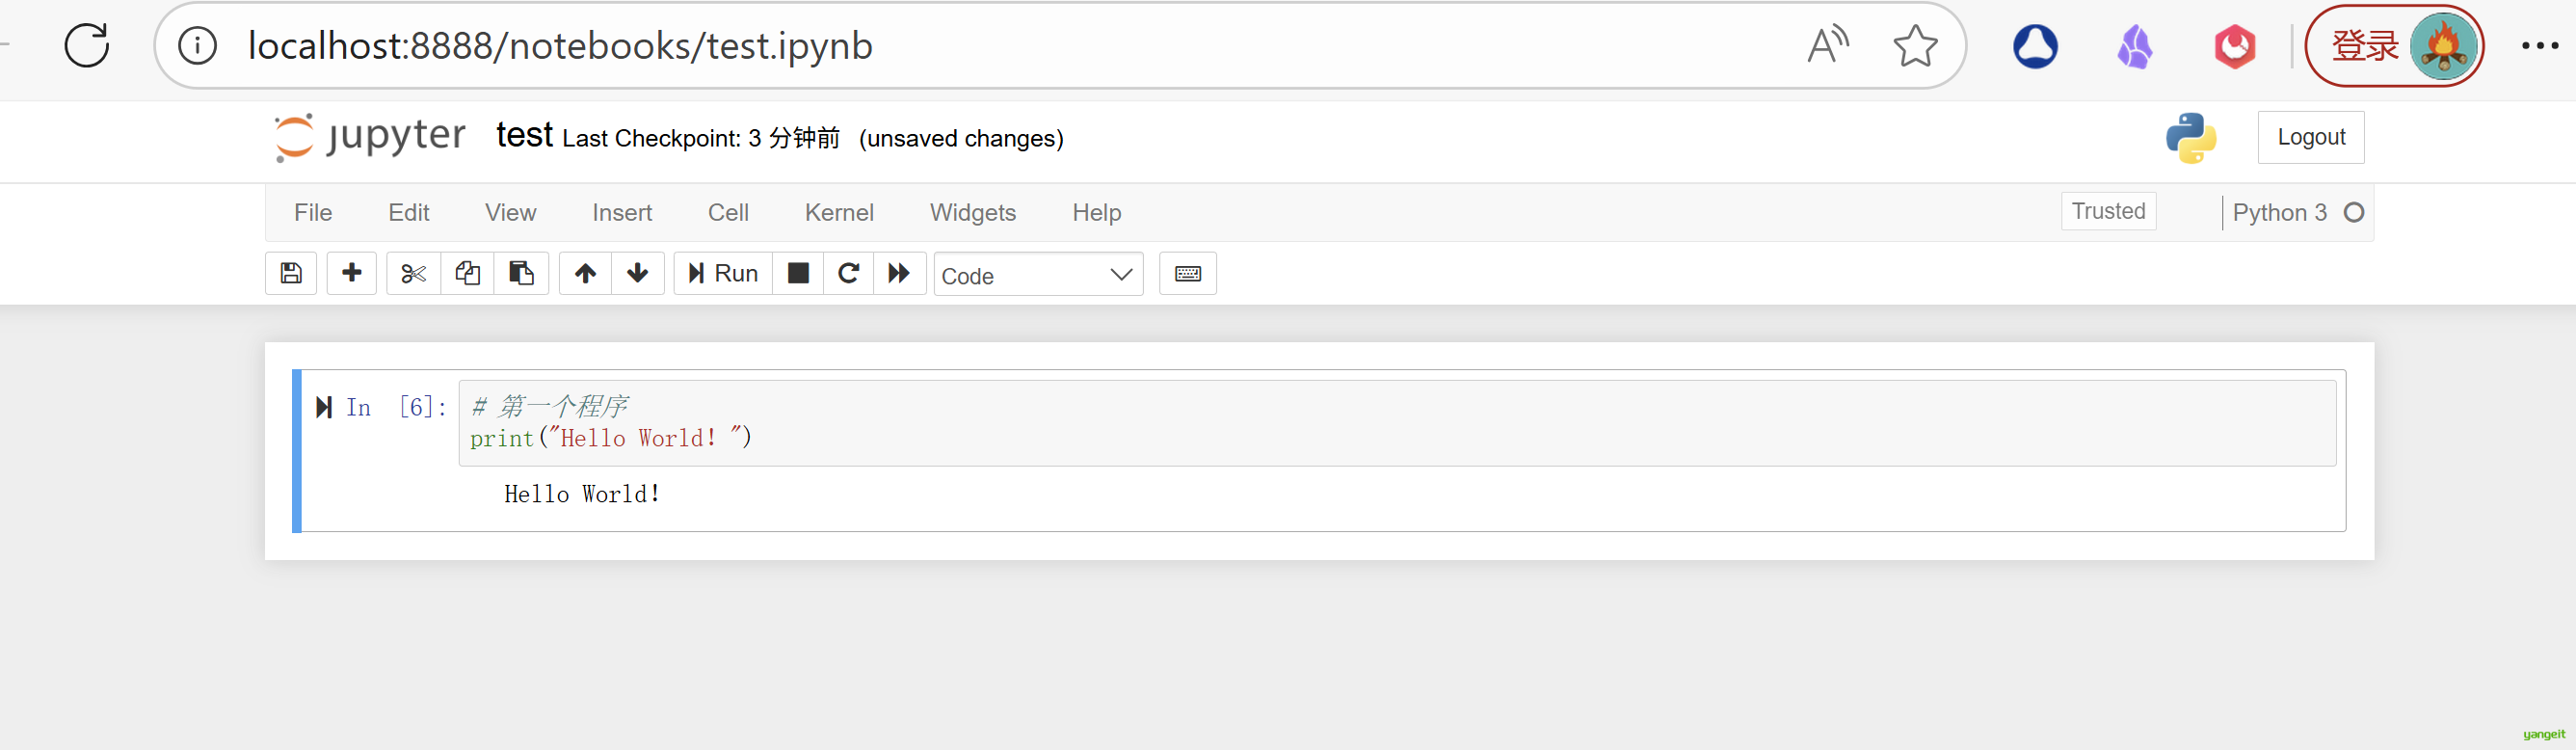
总结
课堂作业
- 在Jupyter Notebook中编写第一个程序,来体验一下Jupyter Notebook的强大之处吧!!
9.实践任务:中文高频词云图
前言
任务目标
用词云可视化一段文本,字号越大代表出现次数越多,一眼看出文本的核心主题。
五个步骤
| 步骤 | 做什么 | 关键代码 |
|---|---|---|
| ① 数据准备 | 读取本地或网络文本文件 | open(...).read() |
| ② 中文分词 | jieba 精确模式分词 | jieba.lcut(text) |
| ③ 去停用词 | 过滤"的、了、在"等无意义高频词 | 列表推导式过滤 |
| ④ 词云生成 | 设置字体、背景色、尺寸 | WordCloud(...).generate() |
| ⑤ 展示保存 | 显示并保存为图片 | plt.imshow() / to_file() |
完整可运行代码
# -*- coding: utf-8 -*-
#要实现Python中的高频词云图,你可以按照以下步骤进行操作:
#1. 安装相关库:首先,确保你已经安装了`Wordcloud`库和`matplotlib`库。你可以使用以下命令进行安装:
#pip install jieba wordcloud matplotlib
#2. 准备数据:将你要生成词云图的文本数据准备好,并读取到Python中。如果文本是一个文件,可以使用文件读取方法;如果文本是字符串,可以直接将其赋值给一个变量。
#3. 进行分词:使用结巴分词(jieba)或其他分词工具对文本进行分词处理,将文本切分成单个词语。例如使用结巴分词进行分词:


import jieba
from collections import Counter
from wordcloud import WordCloud
import matplotlib.pyplot as plt
import re

# 读取文本文件
with open("../data/二十大报告.txt", "r", encoding="gbk") as f:
    text = f.read()
# 读取中文停用词表
with open("../data/stopwords.txt", "r", encoding="gbk") as f:
    stopwords = f.read()

#分词
seg_list = jieba.cut(text)
words = " ".join(seg_list)

# 设置停用词,用于过滤一些常见无意义的词语
def remove_stopwords(text, stopwords):
    text_without_stopwords = [word for word in re.split(r'\W+', text) if word not in stopwords]
    return ' '.join(text_without_stopwords)

text_without_stopwords = remove_stopwords(words, stopwords)

#统计词频:使用Python中的`collections`库统计每个词语出现的频率
word_count = Counter(text_without_stopwords.split())
#统计出现频率最高的前10个词汇
n=10
top_words = word_count.most_common(n)

# 打印频率最高的前10个词汇
for word, count in top_words:
    print(f"词语: {word}  频次: {count}")

#生成词云图:使用`Wordcloud`库根据词频数据生成词云图。可以设置不同的参数来调整词云图的外观,如背景颜色、字体样式、词语显示大小等。
wordcloud = WordCloud(background_color='white',
                      font_path= 'C:\\Windows\\Fonts\\simsun',
                      scale=2,
                      stopwords=stopwords).generate_from_frequencies(word_count)
plt.figure(dpi=600)
plt.imshow(wordcloud, interpolation='bilinear')
plt.axis('off')
plt.show()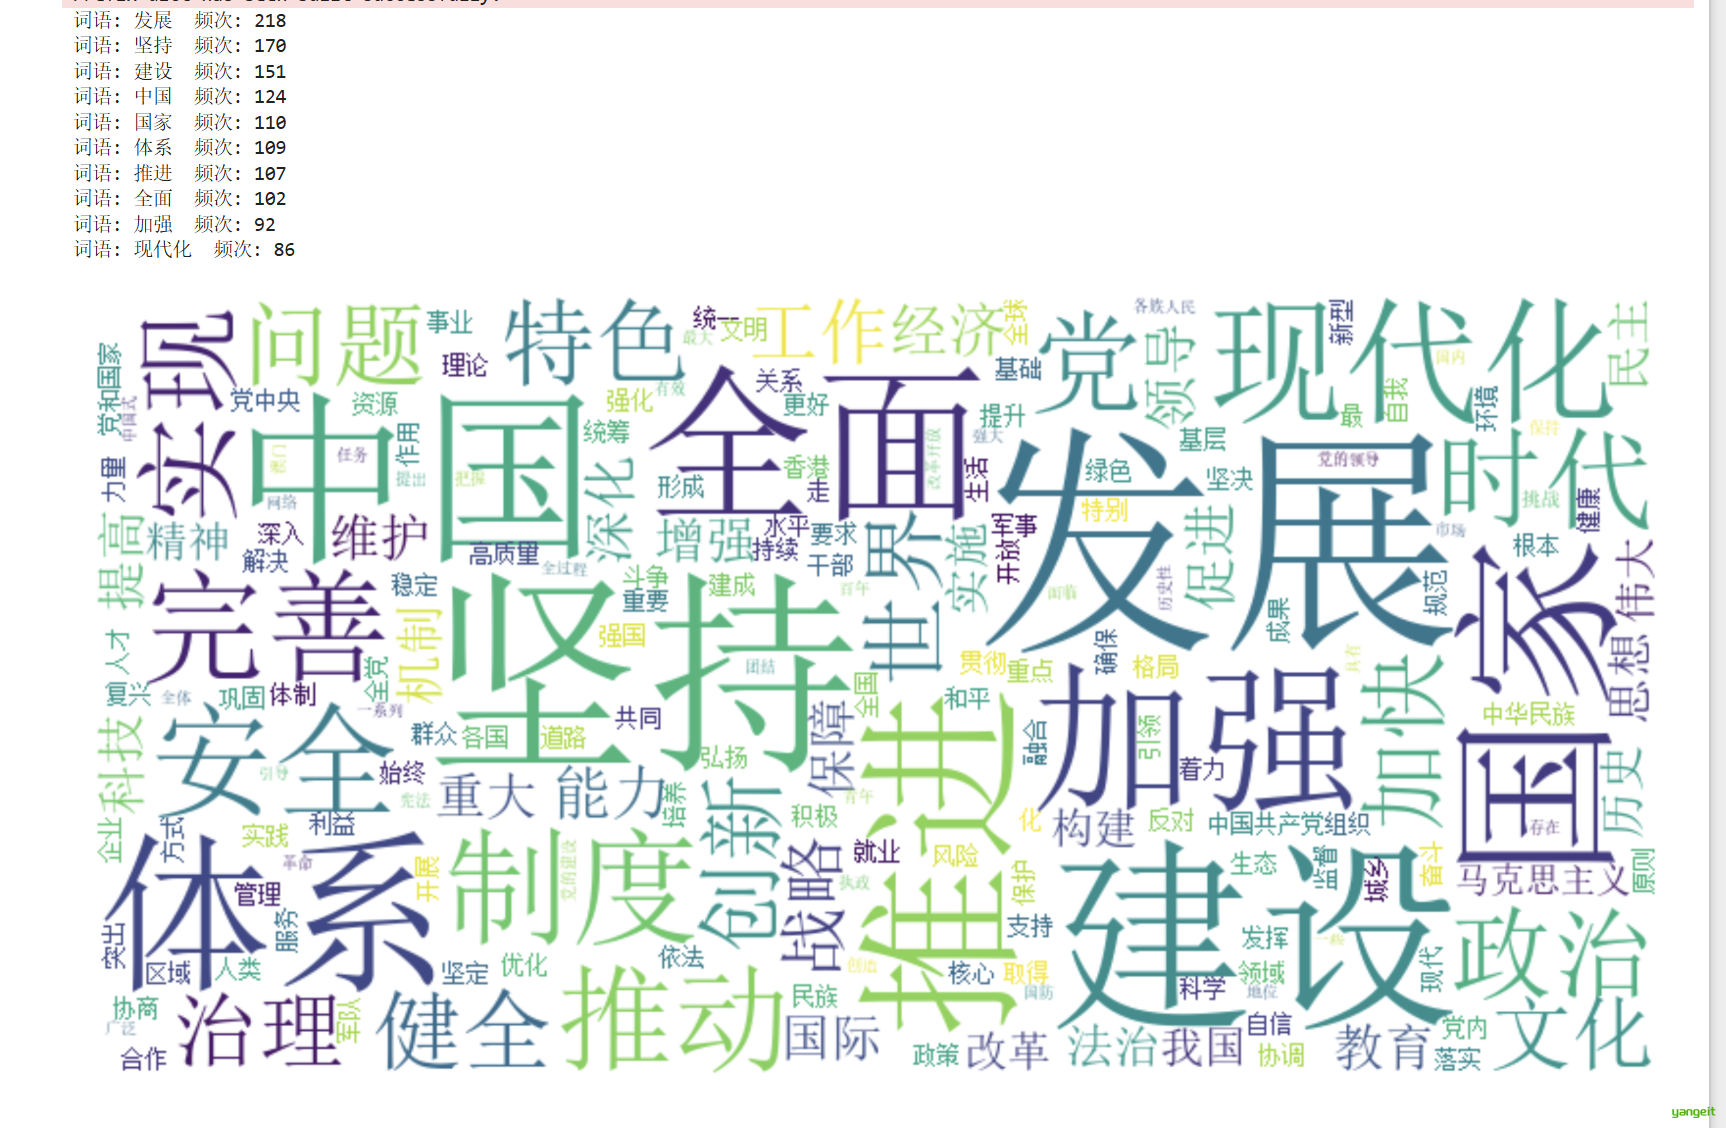
WordCloud 与 matplotlib:WordCloud 是专门画词云的库;matplotlib 是 Python 最常用的绘图库,负责把图显示出来。例:WordCloud 负责做菜,matplotlib 负责端上桌(显示)和打包带走(保存)——中文词云最大的坑是忘了设
font_path,满屏方块不是代码错,是字体没指定。
常见报错排查
| 现象 | 原因 | 解决办法 |
|---|---|---|
| 词云全是方块 | 没指定中文字体 | 设置 font_path 指向黑体/苹方 |
ModuleNotFoundError | 库没装 | pip install jieba wordcloud matplotlib |
| 画面被"的、了"占满 | 没去停用词 | 补充停用词表并过滤 len(w) > 1 |
读文件报 UnicodeDecodeError | 编码不匹配 | open(..., encoding="utf-8") |
自检
- 生成词云为什么要去掉"的、是、在"?A.它们太长 B.它们是高频无意义停用词,会盖住主题词 C.无法分词 D.会报错 B。停用词频次高但信息量低,会占据最大的字号。
- 笔记实践任务中分词使用的 jieba 模式是?A.全模式 B.精确模式 C.搜索引擎模式 D.模糊模式 B。
jieba.lcut精确模式最适合文本分析。 - 词云显示全是方块,最可能的原因是?A.没有指定中文字体 font_path B.分词数量太少 C.背景色设置错误 D.电脑没联网 A。WordCloud 默认字体不支持中文,必须设 font_path。
- 读文件报 UnicodeDecodeError 应该怎么办?A.换一台电脑 B.open(..., encoding="utf-8") C.删除文件重建 D.重装 Python!!B。编码不匹配,指定 utf-8 即可。!!
- wc.generate(...) 接收的参数是?A.中文词的列表 B.空格分隔的字符串 C.图片文件路径 D.词频字典 B。所以代码里写
wc.generate(" ".join(words))。
附本讲名词速查表
| 名词 | 一句话解释 | 出现位置 |
|---|---|---|
| 语料 / 语料库 | 供模型学习的文本材料,相当于课本 | 1.1 |
| 开放模型 / 封闭模型 | 权重公开可下载 vs 只给接口,2025 年差距仅 1.7% | 1.3 |
| 图灵测试 | 分不出对面是人还是机器,就算有智能 | 2 |
| 预训练 + 微调 | 先海量打底子,再针对性刷真题 | 2 |
| 参数量(8B) | 模型内部"旋钮"数量,越小越省显存 | 2 |
| 多模态 | 同时理解文字、图片、声音等多种信息 | 2 |
| 词法 / 句法 / 语义分析 | 划词标词性 → 划句子成分 → 概括中心思想 | 3 |
| 命名实体识别 NER | 把人名、地名、机构名等关键信息标出来 | 3 |
| 信息检索 | 从海量文本里找相关内容并排序 | 3 |
| 智能批改 | 模型自动评阅作业并给修改建议 | 4 |
| 对话系统 | 能多轮对话、带记忆的客服机器人 | 4 |
| 分词 | 给连续的汉字加上词语边界 | 5、6.2 |
| 停用词 | "的、了、在"这类高频无意义词,需要过滤 | 5、6.2 |
| 词向量 / 词嵌入 | 用一组数字表示词,意思相近的词位置也近 | 6.3 |
| TF-IDF | 词在本篇出现多、在别篇出现少 → 权重高 | 6.3 |
| SVM | 传统机器学习模型,靠找分界线分类 | 6.4 |
| Transformer | 靠注意力机制理解上下文的深度学习架构 | 6.4 |
| 注意力机制 | 处理某个词时自动决定该重点看哪些词 | 6.4 |
| 准确率 | 预测对的 ÷ 全部;样本不均衡时会骗人 | 6.5 |
| 精确率 | 我判定为正的里面真正为正的比例(查得准) | 6.5 |
| 召回率 | 真正为正的里面被我找出来的比例(查得全) | 6.5 |
| F1 值 | 精确率与召回率的调和平均,综合指标 | 6.5 |
| Conda / PyPI | Python 的包商店与环境管理器 | 7.1 |
| 预训练模型 / 微调 | 拿现成模型来用,再用自己的数据针对性训练 | 7.2 |
| 环境变量 Path | 系统查找命令的地址簿,没配对就报"不是内部命令" | 7.3 |
| WordCloud / matplotlib | 画词云的库 / 显示与保存图片的库 | 8 |