实训指南:用 DuckDB 从零搭一个汽车销量数据仓库
实训指南:用 DuckDB 从零搭一个汽车销量数据仓库
第 0 步 · 准备工作
一、为什么不能直接拿原始数据做分析
原始业务数据是为业务系统服务的,不是为分析服务的。直接分析会遇到三个问题:
- 格式不可算:销量是
'61,506'这样的字符串,带千分位,SUM()直接报错。 - 含义不明确:
'上汽通用五菱/微型车'一个字段塞了两个属性,拆不出来就没法按车型级别分组。 - 历史会丢失:车系价格是会变的。如果只存当前价格,那么"去年这款车卖多少钱"就永远答不上来。
数据仓库做的事,就是把业务数据转换成分析数据。
二、分层架构
ODS  原始数据层   原样落地,不动一个字符。出问题时能追溯"源头到底是什么"
 ↓
STG  清洗层       类型转换、字段拆分、缺失值处理、脏数据打标
 ↓
DIM  维度层       车系 / 品牌 / 级别 / 日期 的"字典表"
DWD  明细层       事实表,只存外键 + 度量,星型模型的核心
 ↓
DWS  汇总层       预聚合,查询快 100 倍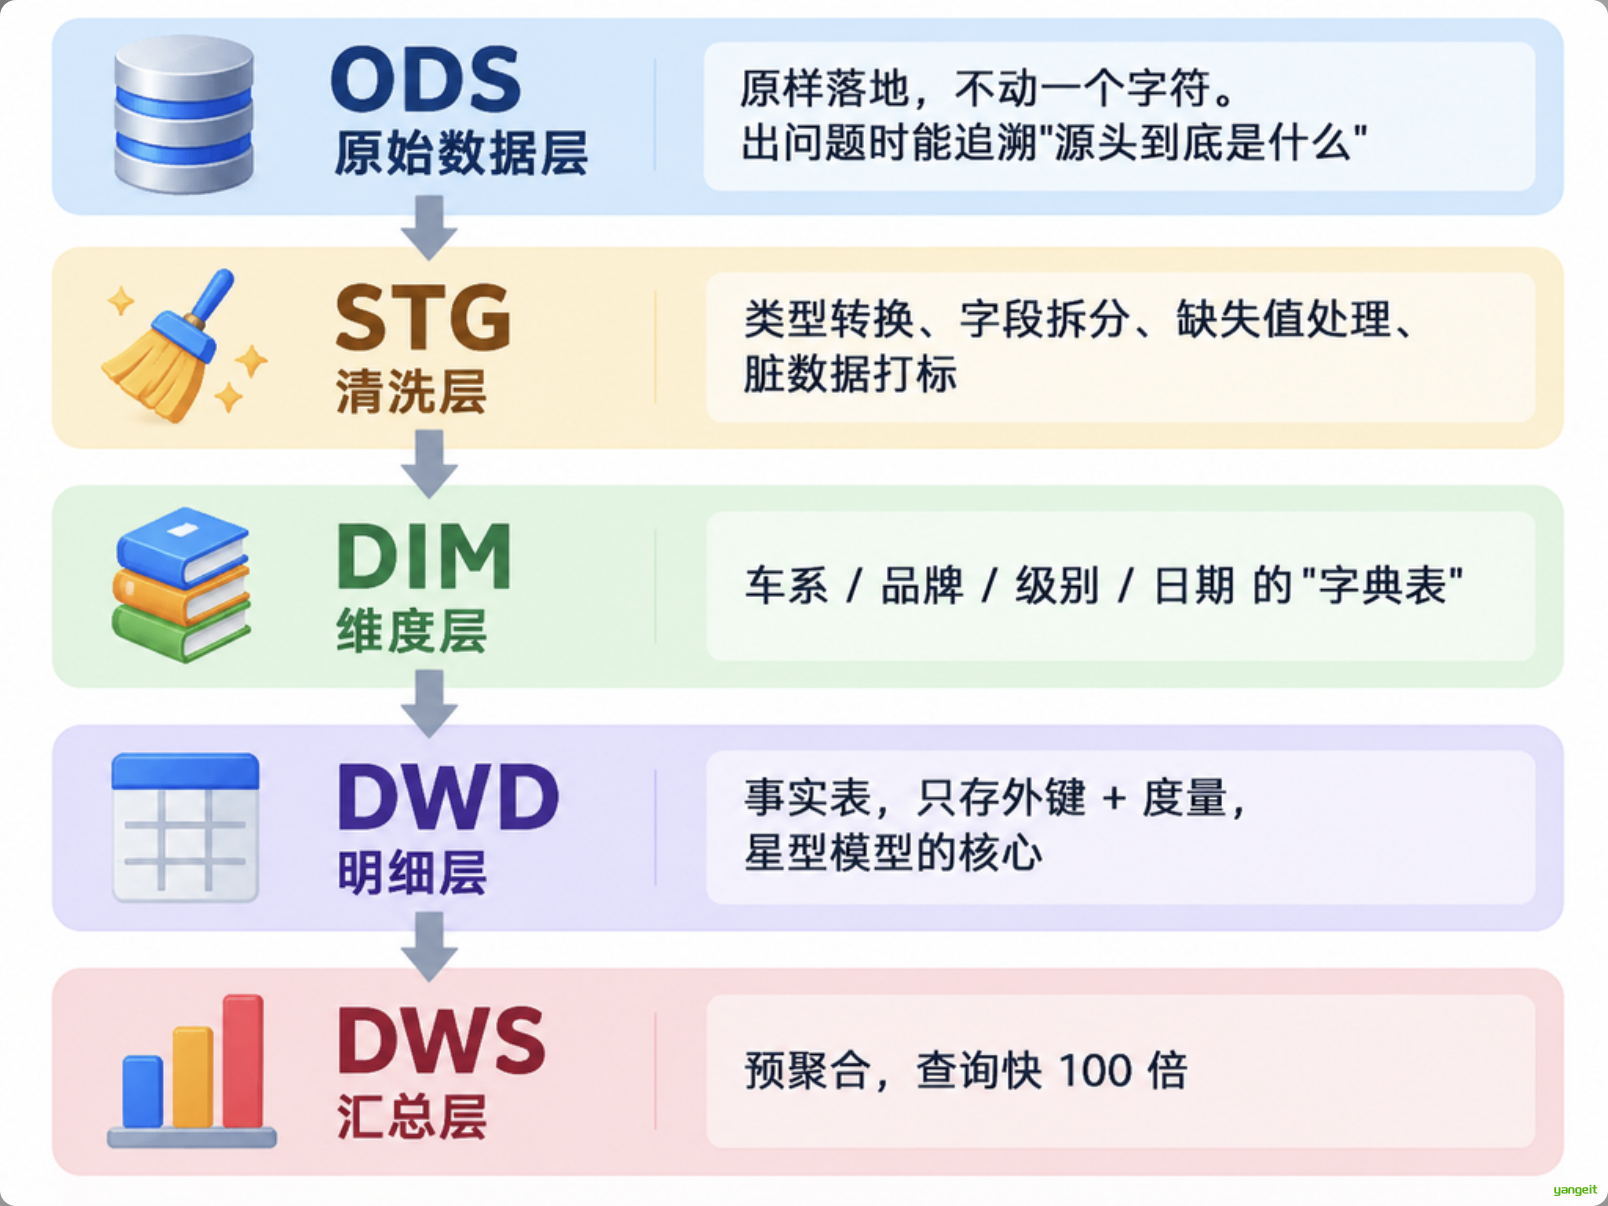
一句话记忆:ODS 存原样 → STG 洗干净 → DIM/DWD 建模型 → DWS 提前算。
为什么不能跳过 ODS 直接从 Excel 建维度表?
因为清洗逻辑会改。三个月后你发现价格解析规则写错了,如果 ODS 没了,就只能用"已经被你改坏的数据"重跑——错误被固化了,再也回不去。ODS 是后悔药。
三、维度建模:事实表 + 维度表
这是本次实训最核心的概念。Kimball 维度建模四步法:
| 步骤 | 问题 | 答案 |
|---|---|---|
| ① 选业务过程 | 你要分析什么业务动作? | 车系在每个月的销售 |
| ② 声明粒度 | 一行事实代表什么? | 一个车系 + 一个月 = 一行 |
| ③ 确定维度 | 从哪些角度去切分? | 日期、车系、品牌、车型级别 |
| ④ 确定事实 | 要度量的数字是什么? | 月销量(辆) |
粒度是维度建模里最重要的决定,本案例的粒度是"车系 × 月",所以这张表每一行都必须是唯一的 (series_id, sale_month) 组合。
事实表长什么样?
fact_monthly_sales(事实表)
├─ date_key      ──┐
├─ series_sk     ──┼── 外键,全部指向维度表
├─ brand_sk      ──┤    (sk = surrogate key,代理键)
├─ segment_sk    ──┘
└─ sale_qty         度量,可加总的数字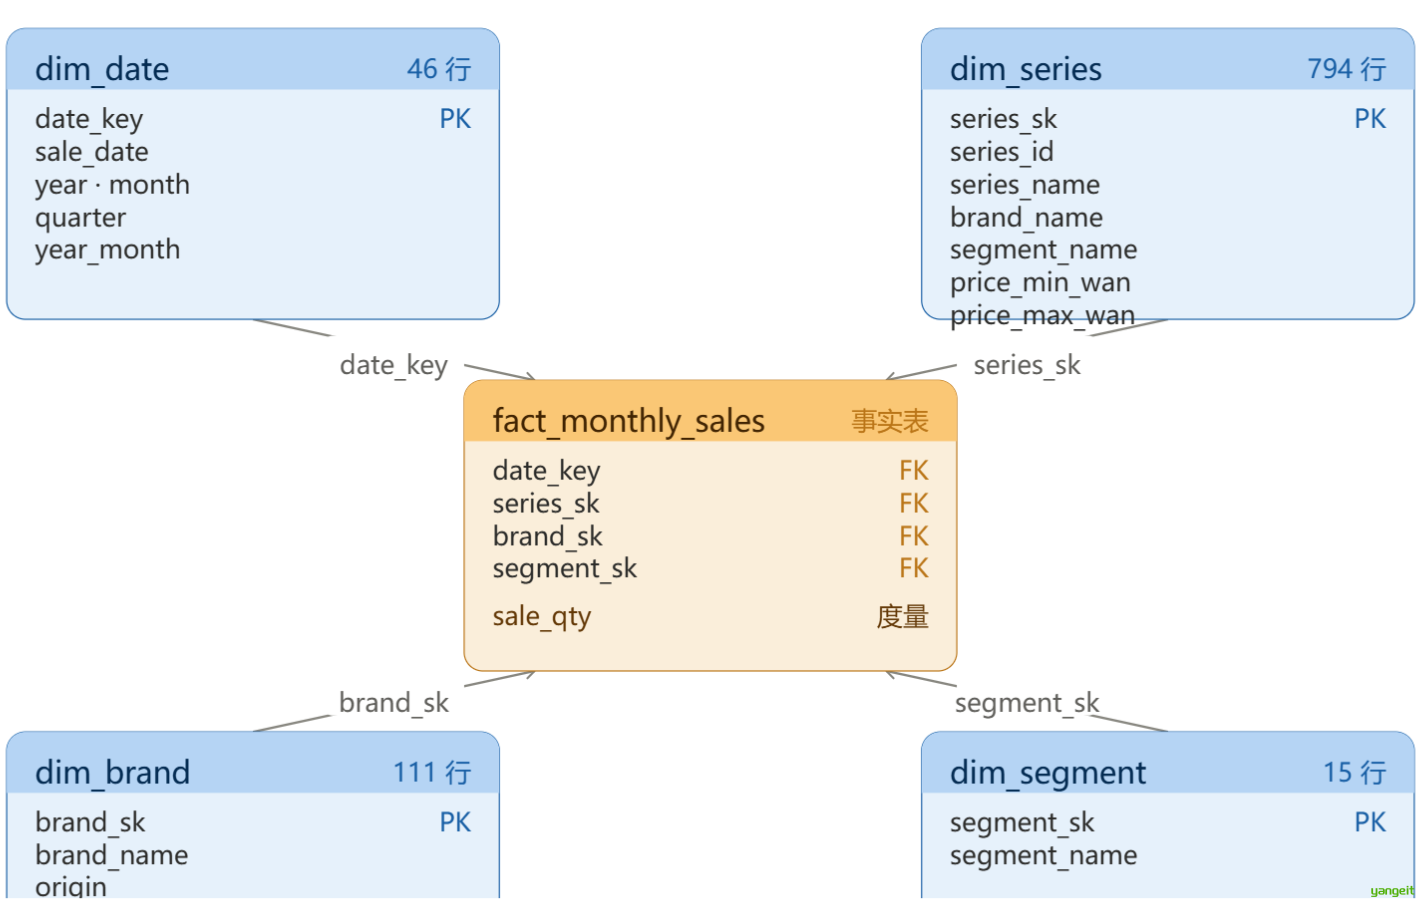
代理键 sk 是什么?
是数仓自己生成的自增 ID,不用业务系统的 ID。好处是:业务系统改了编码规则,数仓不受影响;还能留出 sk = -1 表示"未知成员"。
为什么用星型模型?
事实表在中间,维度表围一圈,像星星。查询时事实表 JOIN 维度表,一次 JOIN 就能拿到所有分析角度,SQL 简单、性能好、业务人员也看得懂。
四、DuckDB 是什么
一个嵌入式分析型数据库,一个 .duckdb 文件就是一个库,不需要装服务端、不需要配置端口。
- 语法接近 PostgreSQL,窗口函数、CTE、
QUALIFY全都支持 - 直接读 pandas DataFrame、Parquet、CSV,不用先
INSERT - 列式存储 + 向量化执行,百万行聚合是毫秒级
DuckDB 是"分析用的 SQLite"——这是理解它定位最快的一句话。
第 1 步 · 环境准备
先装 4 个包(已装会秒过)。%pip 前面加 % 是魔法命令,它保证装到当前 notebook 的内核里。
%pip install -q duckdb pandas openpyxl matplotlib第 2 步 · 连接数据库,加载原始数据
这里做三件事:定位数据文件、创建数据库、把 Excel 读进 pandas。
注意 DB_FILE.unlink(missing_ok=True) —— 每次运行都删掉旧库文件从头开始,保证结果可复现。
from pathlib import Path
import pandas as pd
import duckdb

pd.set_option("display.unicode.east_asian_width", True)   # 中文列对齐
pd.set_option("display.width", 200)
pd.set_option("display.max_columns", 30)

# ① 定位数据文件
for p in [
    Path("./data/懂车帝销售情况表.xlsx"),
]:
    if p.exists():
        DATA_FILE = p
        break
else:
    raise FileNotFoundError("找不到「懂车帝销售情况表.xlsx」,请把它放到 data/ 下")

# ② 建库:DuckDB 的一个文件 = 一个数据库
DB_FILE = Path("dw_lab.duckdb")
DB_FILE.unlink(missing_ok=True)
con = duckdb.connect(str(DB_FILE))

# ③ 读 Excel(全部按字符串读,保留最原始的样貌)
df_sales = pd.read_excel(DATA_FILE, sheet_name="销量表", dtype=str)
df_score = pd.read_excel(DATA_FILE, sheet_name="评分表", dtype=str)

print("数据文件 :", DATA_FILE)
print("数据库   :", DB_FILE.resolve())
print("DuckDB   :", duckdb.__version__)
print("销量表   :", df_sales.shape, "  评分表:", df_score.shape)
第 3 步 · 查看原始数据
停下来看 30 秒:下面这张表里有几处"不对劲"的地方,先自己找一找,再往下读。
df_sales[["车型号", "价格区间", "月销量", "品牌和车型", "销售月份", "车链接"]].head(5)第 4 步 · 再看评分表
df_score.head(5)细心的你是否发现的脏数据
| # | 位置 | 问题 | 后果 |
|---|---|---|---|
| 1 | 月销量 = '61,506' | 带千分位的字符串,不是数字 | SUM() 直接报错 |
| 2 | 品牌和车型 = '上汽通用五菱/微型车' | 一个字段塞了品牌 + 级别 | 没法按车型级别分组 |
| 3 | 车链接 = .../series/4499 | 业务主键埋在 URL 里 | 必须先抽出来才能关联 |
| 4 | 销售月份 = 20220101 | 用整数表示日期 | 没法做日期运算 |
| 5 | 价格区间 = '3.58-5.58万' | 区间是文本 | 没法算均价、没法分价格带 |
| 6 | 懂车分评价等级 = '“一般”' | 带了中文引号 | 分组时 '一般' 和 '“一般”' 是两回事 |
| 7 | 评价人数 = '共593人评价' | 数字混在文案里 | 没法求和 |
| 8 | 厂商指导价 = '11.100万' | 有 4 行小数点写错了 | 解析出 11.1 还是 1110? |
这就是 ODS 层存在的意义 —— 先把原始的、脏的东西原封不动存下来。
第 5 步 · ODS 层:原样落地
ODS 的原则只有一条:一个字符都不改,包括那些脏的。
con.register() 把 pandas DataFrame 注册成 DuckDB 里可以直接查的临时表,不需要 INSERT。
con.execute("CREATE SCHEMA IF NOT EXISTS ods")
con.register("_df_sales", df_sales)
con.register("_df_score", df_score)
con.execute("CREATE OR REPLACE TABLE ods.sales_raw AS SELECT * FROM _df_sales")
con.execute("CREATE OR REPLACE TABLE ods.score_raw AS SELECT * FROM _df_score")

con.sql("""
    SELECT 'ods.sales_raw' AS 表名, COUNT(*) AS 行数 FROM ods.sales_raw
    UNION ALL
    SELECT 'ods.score_raw',          COUNT(*)        FROM ods.score_raw
    ORDER BY 1
""").df()
第 6 步 · 数据体检:扫描缺失与异常
正式清洗前,先摸清家底。
注意这里的"缺失"不是 NULL —— 爬虫数据很少留 NULL,它更喜欢塞占位符:'暂无报价'、'暂无评分'、空字符串,甚至是一整段网页文案。这些比 NULL 危险得多,因为 IS NULL 抓不到它们。
con.sql("""
    SELECT '销量表.价格区间' AS 检查项,
           COUNT(*) FILTER (WHERE "价格区间" = '暂无报价' OR "价格区间" IS NULL) AS 问题行数
    FROM ods.sales_raw
    UNION ALL
    SELECT '销量表.品牌和车型 → 级别',
           COUNT(*) FILTER (WHERE split_part("品牌和车型", '/', 2) = '')
    FROM ods.sales_raw
    UNION ALL
    SELECT '评分表.懂车分',
           COUNT(*) FILTER (WHERE "懂车分" = '暂无评分' OR "懂车分" IS NULL)
    FROM ods.score_raw
    UNION ALL
    SELECT '评分表.评价等级 ← 被网页文案污染',
           COUNT(*) FILTER (WHERE length("懂车分评价等级") > 10)
    FROM ods.score_raw
    ORDER BY 问题行数 DESC
""").df()四种缺失,四种后果:
缺级别 1254 行、暂无评分 189 行、评价等级被灌文案 153 行、暂无报价 28 行。
记住:清洗前必须先知道缺在哪、缺多少。 拍脑袋fillna(0)是数据分析第一大忌。
第 7 步 · 亲手验证第 ① 个坑:销量是字符串
先试一下直接求和会怎样。 这一格故意让它报错,看完报错信息你就明白为什么要清洗了。
try:
    con.sql('SELECT SUM("月销量") FROM ods.sales_raw').df()
    print("居然成功了?那说明 pandas 偷偷帮你转了类型")
except Exception as e:
print("✖ 报错:", str(e).split("\n")[0])再看一眼它到底是什么类型(typeof() 是 DuckDB 的函数,返回存储类型):
con.sql("""
    SELECT "月销量" AS 原始值,
           typeof("月销量") AS 存储类型,
           replace("月销量", ',', '')            AS 去掉千分位,
           TRY_CAST(replace("月销量", ',', '') AS BIGINT) AS 转成数字
    FROM ods.sales_raw LIMIT 5
""").df()
第 8 步 · 验证第 ⑥ 个坑:评价等级被整段文案污染
第 6 步扫出 189 行"长度 > 10"的等级值。看看它们到底装了什么 —— 比预想的严重得多:
con.sql("""
    SELECT CASE WHEN length("懂车分评价等级") > 10
                THEN '[整段网页文案] ' || substr("懂车分评价等级", 1, 40) || '…'
                ELSE "懂车分评价等级" END                                   AS 等级原值,
           NULLIF(regexp_extract("懂车分评价等级", '(优秀|良好|一般|较差|极差)', 1), '') AS 白名单提取,
           COUNT(*) AS 行数
    FROM ods.score_raw
    GROUP BY 1, 2
    ORDER BY 行数 DESC
""").df()
这里有个很重要的清洗思路
这 153 行本来应该是「暂无评分」,但爬虫抓到的是页面上一段说明文字:
"懂车分来源为真实车主或试驾过的用户、车评人发表的评价,平台会根据评分人的各种行为判断一条评价……"两种修法:
- ❌ 黑名单:
trim()掉中文引号、再CASE WHEN排除长文本…… 网页文案隔三差五改版,你得跟着改规则,永远改不完。- ✅ 白名单:用
regexp_extract(col, '(优秀|良好|一般|较差|极差)', 1)只把认识的值取出来,其余一律变 NULL。清洗枚举型字段,白名单永远优于黑名单。 因为合法取值是有限且稳定的,而脏数据的花样是无穷的。
再看看那 4 行格式写错的价格:
con.sql("""
    SELECT "厂商指导价", "经销商报价", "懂车分"
    FROM ods.score_raw
    WHERE NOT regexp_matches("厂商指导价", '^[0-9]+\\.?[0-9]*-[0-9]+\\.?[0-9]*万$')
    LIMIT 6
""").df()思考:
11.100万到底是 11.1 万还是 1110 万?
看它的经销商报价(3.58-5.58万这种量级)和车型就知道了 —— 这是一辆十万级的车,所以是 11.1 万。
脏数据怎么修,不能只看这一个字段,得结合业务常识和其他字段交叉验证。 这是数据清洗里最容易出错的地方。
第 9 步 · STG 层:开始清洗(销量表)
清洗层的核心纪律:只做转换和打标,不删行。
删行是不可逆的。今天觉得"缺价格的行没用"删掉了,下个月业务说"我要统计缺失率",这些数据就再也找不回来了。正确做法是打一个 is_price_missing 标记,让下游自己决定要不要用。
con.execute("CREATE SCHEMA IF NOT EXISTS stg")
con.execute("""
CREATE OR REPLACE TABLE stg.sales_clean AS
WITH base AS (
    SELECT
        -- 坑③:从 URL 里抽业务主键
        regexp_extract("车链接", '/series/([0-9]+)', 1)     AS series_id,
        "车型号"                                             AS series_name,
        -- 坑②:拆分复合字段「上汽通用五菱/微型车」
        split_part("品牌和车型", '/', 1)                     AS brand_name,
        NULLIF(split_part("品牌和车型", '/', 2), '')         AS segment_name,
        "价格区间",
        CAST("销售月份" AS INTEGER)                          AS sale_month,
        "月销量"
    FROM ods.sales_raw
)
SELECT
    series_id,        -- 【车系ID】业务主键,从车链接抽出,如 4499
    series_name,      -- 【车系名称】如「五菱宏光MINIEV」
    brand_name,       -- 【品牌名称】如「上汽通用五菱」
    segment_name,     -- 【车型级别】如「微型车」;缺失为 NULL(1254 行)
    sale_month,       -- 【销售月份】业务日期键,YYYYMMDD,如 20220101
    -- 坑④:20220101 → 真正的日期类型
    strptime(CAST(sale_month AS VARCHAR), '%Y%m%d')::DATE    AS sale_date,
    --       ↑【销售月首日】DATE 型,方便做日期运算、画时间序列
    -- 坑⑤:'3.58-5.58万' → 3.58 和 5.58;'暂无报价' → NULL(TRY_CAST 失败返回 NULL)
    TRY_CAST(regexp_extract("价格区间", '^([0-9.]+)', 1)    AS DOUBLE) AS price_min_wan,
    --       ↑【最低价】单位「万元」;原价缺失时为 NULL
    COALESCE(TRY_CAST(regexp_extract("价格区间", '-([0-9.]+)万$', 1) AS DOUBLE),
             TRY_CAST(regexp_extract("价格区间", '^([0-9.]+)', 1)    AS DOUBLE)) AS price_max_wan,
    --       ↑【最高价】单位「万元」;COALESCE 是为了兼容只有一个单价的情况
    -- 打标不删行
    ("价格区间" = '暂无报价')                                AS is_price_missing,
    --       ↑【价格缺失标记】布尔型,原始为「暂无报价」时 = true(共 28 行)
    -- 坑①:'61,506' → 61506
    TRY_CAST(replace("月销量", ',', '') AS BIGINT)           AS sale_qty
--       ↑【月销量】★ 本表唯一的度量,单位「辆」,可跨维度 SUM
FROM base
""")
print("stg.sales_clean 建好了")
第 10 步 · 看看清洗效果
查询时用中文给字段起别名,输出结果的表头一眼就懂 —— 写分析 SQL 时养成这个习惯。
con.sql("""
    SELECT series_id       AS 车系ID,
           series_name     AS 车系名称,
           brand_name      AS 品牌,
           segment_name    AS 车型级别,
           sale_month      AS 销售月份,
           sale_date       AS 销售月首日,
           price_min_wan   AS 最低价_万元,
           price_max_wan   AS 最高价_万元,
           is_price_missing AS 价格缺失,
           sale_qty        AS 月销量_辆
    FROM stg.sales_clean LIMIT 6
""").df()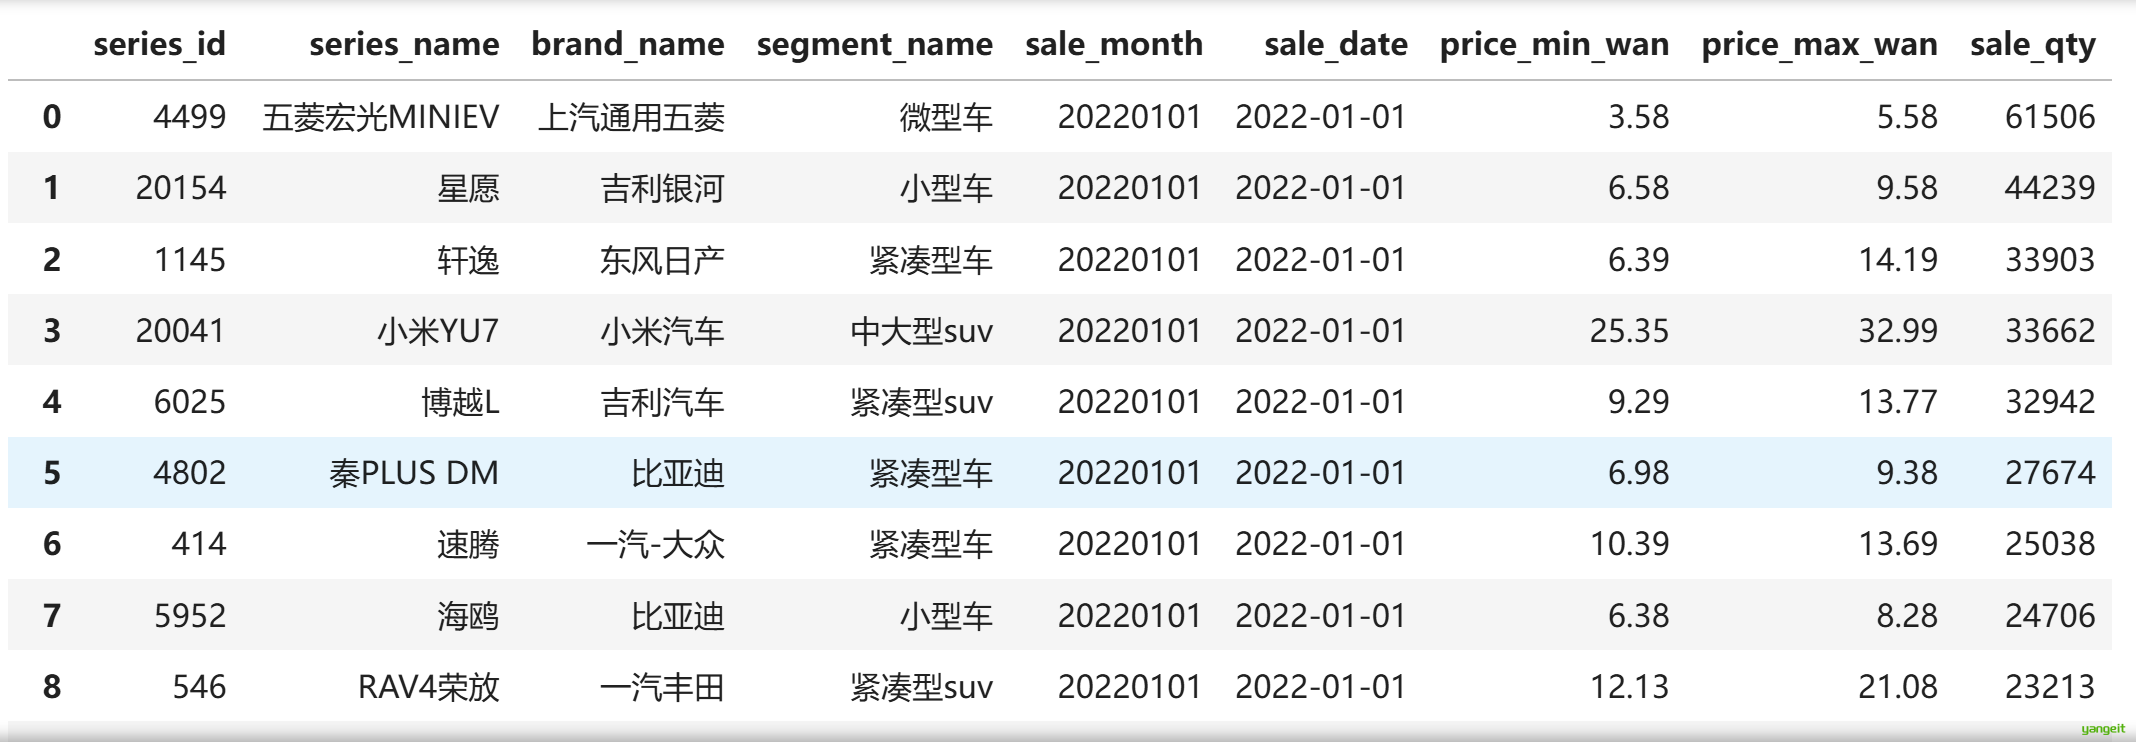
📖 字段说明书 · stg.sales_clean
这张表 10 个字段,按角色分成三组看,就再也不会记混:
| 字段 | 中文名 | 类型 | 角色 | 说明 | 示例 |
|---|---|---|---|---|---|
series_id | 车系 ID | VARCHAR | 🔑 业务主键 | 从车链接 /series/4499 抽出;与评分表同义,靠它跨表关联 | 4499 |
series_name | 车系名称 | VARCHAR | 维度属性 | 车系的中文名 | 五菱宏光MINIEV |
brand_name | 品牌名称 | VARCHAR | 维度属性 | 复合字段斜杠前半段 | 上汽通用五菱 |
segment_name | 车型级别 | VARCHAR | 维度属性 | 斜杠后半段;缺失时为 NULL(1254 行) | 微型车 |
sale_month | 销售月份 | INTEGER | 🔑 业务日期键 | YYYYMMDD 整数,将来关联 dim_date.date_key | 20220101 |
sale_date | 销售月首日 | DATE | 维度属性 | sale_month 转成真日期,做日期运算、画时间序列要用它 | 2022-01-01 |
price_min_wan | 最低价 | DOUBLE | 维度属性 | 单位万元,从「3.58-5.58万」拆出 | 3.58 |
price_max_wan | 最高价 | DOUBLE | 维度属性 | 单位万元;只有一个单价时与最低价相同 | 5.58 |
is_price_missing | 价格缺失标记 | BOOLEAN | 🏷 质量标记 | 原始值为「暂无报价」时 = true(28 行)。打标不删行 | false |
sale_qty | 月销量 | BIGINT | 📊 度量 | 单位「辆」。本表唯一可加总的数字 | 61506 |
看懂字段角色的意义:后面建维度表时,
维度属性会被搬进dim_*表并换成_sk代理键,
事实表里只留下🔑 键和📊 度量—— 这就是为什么dwd.fact_monthly_sales只有 5 列。
stg.score_clean 的 6 个字段同理:
| 字段 | 中文名 | 说明 | 示例 |
|---|---|---|---|
series_id | 车系 ID | 从懂车分链接 /score/4499 抽出,与销量表同义 | 4499 |
score | 懂车分 | 0–5 分;暂无评分时为 NULL(189 行,不是 0) | 3.52 |
score_level | 评分等级 | 白名单提取:优秀 / 良好 / 一般 / 较差 / 极差 | 良好 |
review_cnt | 评价人数 | 从「共1793人评价」里抽出的数字 | 1793 |
msrp_min_wan | 厂商指导价下限 | 单位万元 | 6.59 |
msrp_max_wan | 厂商指导价上限 | 单位万元 | 13.99 |
🔤 全库命名约定(看后缀知含义)
| 后缀 | 含义 | 出现位置 |
|---|---|---|
_id | 业务主键,来自源系统 | series_id |
_sk | 代理键,数仓自己生成的自增 ID | brand_sk |
_key | 日期键 | date_key |
_wan | 单位是万元(不是元!) | price_min_wan |
_cnt | 计数 | review_cnt |
is_ | 布尔标记 | is_price_missing |
= -1 | 未知成员(维度关联失败时的兜底) | segment_sk = -1 |
第 11 步 · 清洗层自检:行数必须守恒
这是清洗层唯一的硬性检查:ODS 进多少行,STG 就必须出多少行。少了说明误删,多了说明 JOIN 写错了导致行数膨胀。
con.sql("""
    SELECT (SELECT COUNT(*) FROM ods.sales_raw)                          AS ods行数,
           (SELECT COUNT(*) FROM stg.sales_clean)                        AS stg行数,
           (SELECT COUNT(*) FROM stg.sales_clean WHERE sale_qty IS NULL) AS 销量解析失败,
           (SELECT COUNT(*) FROM stg.sales_clean WHERE price_min_wan IS NULL) AS 缺价格行数,
           (SELECT COUNT(*) FROM stg.sales_clean WHERE segment_name IS NULL)  AS 缺级别行数,
           (SELECT SUM(sale_qty) FROM stg.sales_clean)                   AS 总销量
""").df()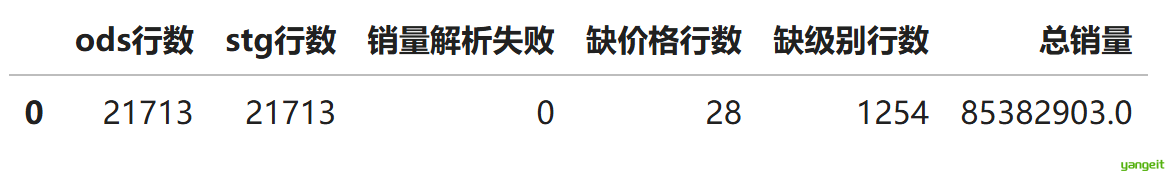
✅ 自检点 1:ods行数 = stg行数 = 21713,销量解析失败 = 0。对上了才继续。
注意
缺级别行数 = 1254被原样保留了,只是记成NULL。
清洗层只标记、不填值、不删行 —— 填成"未知"是下游建模时维度表的事(第 16 步会用-1兜住它)。
这样职责清晰:STG 只负责"如实表达缺失",DIM 才负责"如何展示缺失"。
第 12 步 · 清洗评分表
同样的套路:抽主键、去文案、数字化、缺失置 NULL。
注意 score 用 TRY_CAST 后,'暂无评分' 会变成 NULL 而不是 0 —— 这个区别至关重要,下一格立刻就能看到后果。
con.execute("""
CREATE OR REPLACE TABLE stg.score_clean AS
SELECT
    regexp_extract("懂车分链接", '/score/([0-9]+)', 1)                       AS series_id,
    TRY_CAST("懂车分" AS DOUBLE)                                             AS score,
    -- 白名单提取:只认这 5 个值,其余(中文引号、整段文案)一律变 NULL
    NULLIF(regexp_extract("懂车分评价等级", '(优秀|良好|一般|较差|极差)', 1), '') AS score_level,
    TRY_CAST(regexp_extract("评价人数", '([0-9]+)', 1) AS INTEGER)           AS review_cnt,
    TRY_CAST(regexp_extract("厂商指导价", '^([0-9.]+)', 1) AS DOUBLE)        AS msrp_min_wan,
    COALESCE(TRY_CAST(regexp_extract("厂商指导价", '-([0-9.]+)万$', 1) AS DOUBLE),
             TRY_CAST(regexp_extract("厂商指导价", '^([0-9.]+)', 1) AS DOUBLE)) AS msrp_max_wan
FROM ods.score_raw
""")

con.sql("""
    SELECT COUNT(*)                                        AS 总行数,
           COUNT(*) FILTER (WHERE score IS NULL)           AS 暂无评分,
           COUNT(*) FILTER (WHERE score_level IS NULL)     AS 等级缺失,
           ROUND(AVG(score), 2)                            AS 平均分_已排除缺失,
           ROUND(AVG(COALESCE(score, 0)), 2)               AS 平均分_错误填0
    FROM stg.score_clean
""").df()
🔴 看清楚这两列的区别:
3.81和2.90。
把 189 行缺失当 0,平均分被凭空拉低了 0.91 分 —— 从"良好偏上"直接跌到"不及格"。
而且样本量越大、缺失越多,偏差越大。
更隐蔽的是:填 0 之后数据"看起来完全正常",不报错、不告警,但结论是错的。
缺失值处理铁律:缺失就是 NULL,不是 0。
第 13 步 · DIM 层:日期维度
维度表是数仓的"字典"。建维度表时有两个通用规矩:
- 加一个自增代理键
sk(surrogate key) - 插入一行
sk = -1的未知成员
第 2 条是新手最容易漏的。为什么必须有?因为事实表用 LEFT JOIN 关联维度,一旦某行匹配不上,sk 就会是 NULL。而 NULL 不能参与 JOIN 和 GROUP BY 的正常语义,这行事实会在后续所有分析里凭空消失。用 -1 兜住,这行事实就还在,只是被归到"未知"里,随时能查出来。
con.execute("CREATE SCHEMA IF NOT EXISTS dim")
con.execute("""
CREATE OR REPLACE TABLE dim.dim_date AS
SELECT DISTINCT
    sale_month                        AS date_key,
    sale_date,
    YEAR(sale_date)                   AS year,
    MONTH(sale_date)                  AS month,
    QUARTER(sale_date)                AS quarter,
    printf('%04d-%02d', YEAR(sale_date), MONTH(sale_date)) AS year_month
FROM stg.sales_clean
""")
print("dim_date 行数:", con.sql("SELECT COUNT(*) FROM dim.dim_date").fetchone()[0])
第 14 步 · DIM 层:车系维度
这里有个必须处理的坑:同一个车系在不同月份可能有不同价格(调价了)。如果对 (series_id, 价格) 做 DISTINCT,一个车系就会变成多行,事实表 JOIN 时行数直接膨胀。
本实训取最新一次价格(ORDER BY sale_month DESC 取第一条)。这就是简化版的 SCD Type 1 —— 只保留当前值,不保留历史。
con.execute("""
CREATE OR REPLACE TABLE dim.dim_series AS
WITH latest AS (
    SELECT series_id, series_name, brand_name, segment_name,
           price_min_wan, price_max_wan,
           ROW_NUMBER() OVER (PARTITION BY series_id ORDER BY sale_month DESC) AS rn
    FROM stg.sales_clean
)
SELECT ROW_NUMBER() OVER (ORDER BY series_id) AS series_sk,
       series_id, series_name, brand_name,
       COALESCE(segment_name, '未知')          AS segment_name,   -- 维度表负责"如何展示缺失"
       price_min_wan, price_max_wan
FROM latest WHERE rn = 1
""")

# 未知成员
con.execute("""
INSERT INTO dim.dim_series
VALUES (-1, '-1', '未知车系', '未知品牌', '未知', NULL, NULL)
""")
print("dim_series 行数:", con.sql("SELECT COUNT(*) FROM dim.dim_series").fetchone()[0], "(含 1 行未知成员)")
第 15 步 · DIM 层:品牌维度
品牌属于主数据(MDM, Master Data):变化慢、被多系统共享、需要人工维护的参考数据。品牌属于"自主 / 合资 / 外资"哪个阵营,原始数据里没有,是靠主数据补出来的。
真实项目里主数据一般单独存一张表由人维护,这里为了 notebook 自包含,直接写在代码里。
# 品牌 → 阵营(主数据 MDM)
自主 = "比亚迪 上汽通用五菱 奇瑞汽车 吉利汽车 长安汽车 长城汽车 吉利银河 一汽红旗 理想汽车 零跑汽车 广汽埃安新能源 赛力斯汽车 长安启源 广汽传祺 领克 上汽集团 蔚来 小鹏汽车 小米汽车 深蓝汽车 极氪 东风乘用车 一汽奔腾 方程豹 奇瑞新能源 北汽新能源 北京汽车 腾势汽车 岚图汽车 阿维塔科技 智己汽车 星途 东风风行 江汽集团 吉利几何 东风汽车 凯翼汽车 睿蓝汽车 合众汽车 北京汽车制造厂 大通 江铃集团新能源 赛力斯蓝电汽车 鑫源汽车 东风小康 开瑞汽车 瑞驰汽车 长安轻型车 曹操汽车 吉麦新能源 大运汽车 创维汽车 二一二越野车 合创汽车 飞凡汽车 江淮汽车 SWM斯威汽车 至境 知豆电动车 猛士科技 仰望 东南汽车 中国重汽VGV 一汽海马 海马汽车 电动屋 一汽吉林 宏瑞汽车 华晨新日 领途汽车 LEVC 远航汽车 新龙马汽车"
合资 = "上汽大众 一汽-大众 广汽丰田 一汽丰田 东风日产 华晨宝马 一汽奥迪 北京奔驰 广汽本田 东风本田 上汽通用别克 北京现代 沃尔沃亚太 一汽-大众捷达 上汽通用凯迪拉克 长安福特 长安马自达 上汽通用雪佛兰 起亚 长安林肯 上汽奥迪 奇瑞捷豹路虎 smart 东风标致 江铃福特 福建奔驰 东风雪铁龙 上汽大众斯柯达 光束汽车 神龙汽车 东风英菲尼迪 郑州日产 DS汽车"
外资 = "特斯拉中国 Polestar 起亚(进口) DS(进口)"

BRAND_ORIGIN = {b: "自主" for b in 自主.split()}
BRAND_ORIGIN.update({b: "合资" for b in 合资.split()})
BRAND_ORIGIN.update({b: "外资" for b in 外资.split()})

mdm = pd.DataFrame({"brand_name": list(BRAND_ORIGIN.keys()),
                    "origin":     list(BRAND_ORIGIN.values())})
con.register("_mdm", mdm)

con.execute("""
CREATE OR REPLACE TABLE dim.dim_brand AS
WITH b AS (SELECT DISTINCT brand_name FROM stg.sales_clean)
SELECT ROW_NUMBER() OVER (ORDER BY b.brand_name) AS brand_sk,
       b.brand_name,
       COALESCE(m.origin, '其他')                AS origin
FROM b LEFT JOIN _mdm m ON m.brand_name = b.brand_name
""")
con.execute("INSERT INTO dim.dim_brand VALUES (-1, '未知品牌', '未知')")

con.sql("SELECT origin AS 阵营, COUNT(*) AS 品牌数 FROM dim.dim_brand GROUP BY 1 ORDER BY 品牌数 DESC").df()
输出最后那行「未知 · 1 个」就是刚插入的未知成员。每张维度表都会有这么一行,
-1是数仓里的万能兜底值。
第 16 步 · DIM 层:车型级别维度
这里有个很容易踩的坑,值得停下来看清楚。
stg 里有 1254 行 segment_name IS NULL。而 SELECT DISTINCT 是会保留 NULL 的(NULL 在 SQL 里被当作一个合法的"值"参与去重)—— 不信你先把下面的 WHERE 去掉跑一次,会看到维度表最后多出一个 segment_name 为空的幽灵成员。
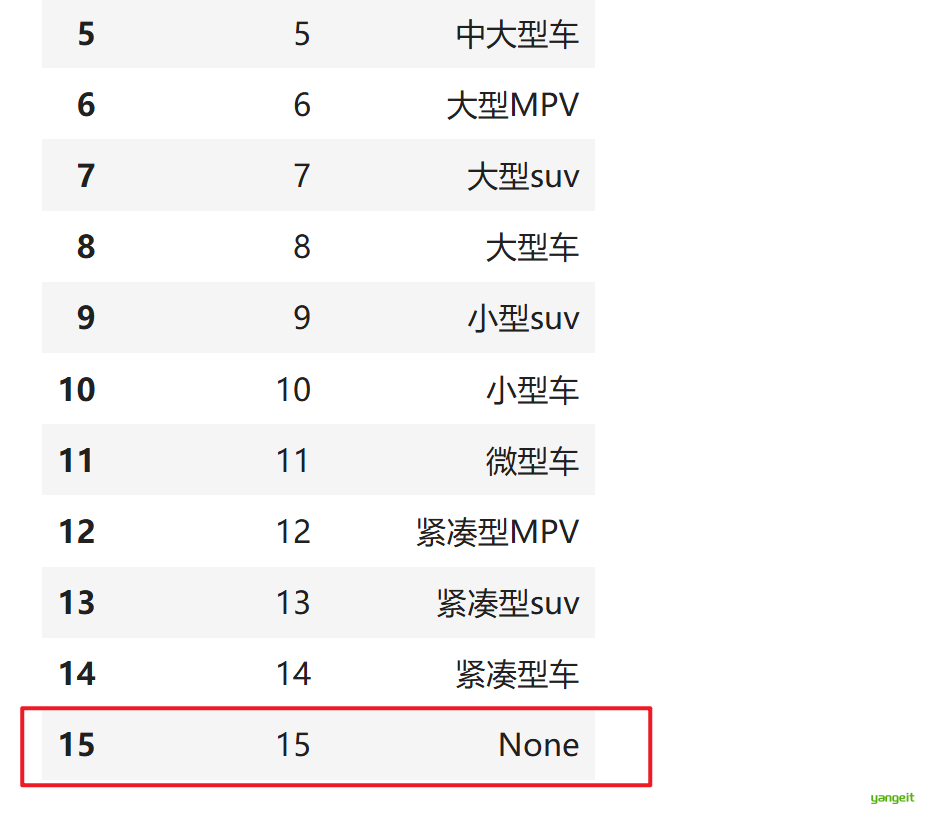
所以必须显式过滤:
con.execute("""
CREATE OR REPLACE TABLE dim.dim_segment AS
SELECT ROW_NUMBER() OVER (ORDER BY segment_name) AS segment_sk, segment_name
FROM (SELECT DISTINCT segment_name FROM stg.sales_clean
      WHERE segment_name IS NOT NULL)          -- ← 必须显式排除,DISTINCT 不会帮你做
""")
con.execute("INSERT INTO dim.dim_segment VALUES (-1, '未知')")

con.sql("SELECT * FROM dim.dim_segment ORDER BY segment_sk").df()
✅ 检查:表里应该只有 segment_sk = -1 这一行叫「未知」,真实级别 14 个,合计 15 行。多出来一行就说明上面那段没看懂。
为什么 STG 层要把缺失留成 NULL,而不是填成 '未知'?
假设 STG 当初填成了字符串
'未知',那么DISTINCT会产出'未知'(来自数据),你又INSERT了(-1, '未知'),维度表里就出现了两个都叫"未知"的成员。后果很严重:事实表按
segment_name关联时,那 1254 行会各匹配到 2 条记录 —— 事实行数从 21713 膨胀成 22967,总销量从 8538 万虚增到 8776 万。而且 SQL 不报错、不告警,每个聚合结果都比真实值高一点点,谁都不会怀疑。
反过来,如果缺失是 NULL:由于 SQL 的三值逻辑,
NULL = NULL的结果是unknown,JOIN 根本匹配不上,这些行会安全地落到-1。这就是第 11 步那条纪律的价值 —— STG 只负责如实表达缺失(NULL),DIM 才负责决定如何展示它(-1)。 缺失在每一层只有一种表示方式,就不会出现歧义成员。
第 17 步 · 维度层总览
星型模型的四个角都就位了。核对一遍行数:
con.sql("""
    SELECT 'dim_date'    AS 维度表, COUNT(*) AS 行数, '日期维度' AS 说明 FROM dim.dim_date
    UNION ALL SELECT 'dim_series',  COUNT(*), '车系维度' FROM dim.dim_series
    UNION ALL SELECT 'dim_brand',   COUNT(*), '品牌维度' FROM dim.dim_brand
    UNION ALL SELECT 'dim_segment', COUNT(*), '车型级别维度' FROM dim.dim_segment
    ORDER BY 1
""").df()
第 18 步 · DWD 层:建事实表
这一步就是把「清洗好的明细」和「维度表」JOIN 起来,把业务键换成代理键。
三个要点:
- 用
LEFT JOIN而不是INNER JOIN—— 匹配不上的事实不能丢 COALESCE(sk, -1)—— 匹配不上的落到未知成员- 事实表只留外键和度量,不冗余维度属性(品牌名要查就去 JOIN
dim_brand)
con.execute("CREATE SCHEMA IF NOT EXISTS dwd")
con.execute("""
CREATE OR REPLACE TABLE dwd.fact_monthly_sales AS
SELECT
    -- 4 个外键:全部指向 dim_* 维度表。COALESCE(...,-1) 保证关联失败时落未知成员
    COALESCE(d.date_key,    -1) AS date_key,      -- 【日期键】→ dim_date,如 20220101
    COALESCE(s.series_sk,   -1) AS series_sk,     -- 【车系代理键】→ dim_series
    COALESCE(b.brand_sk,    -1) AS brand_sk,      -- 【品牌代理键】→ dim_brand
    COALESCE(g.segment_sk,  -1) AS segment_sk,    -- 【级别代理键】→ dim_segment,无级别时 = -1
    -- 1 个度量:本表唯一的可加数字
    t.sale_qty                  AS sale_qty       -- 【月销量】单位「辆」,★ 可跨任意维度 SUM
FROM stg.sales_clean t
LEFT JOIN dim.dim_date    d ON d.date_key    = t.sale_month
LEFT JOIN dim.dim_series  s ON s.series_id   = t.series_id
LEFT JOIN dim.dim_brand   b ON b.brand_name  = t.brand_name
LEFT JOIN dim.dim_segment g ON g.segment_name= t.segment_name
""")
print("dwd.fact_monthly_sales 建好了")
📖 字段说明书 · dwd.fact_monthly_sales
整张事实表只有 5 列:4 个外键 + 1 个度量。 这不是偷懒,这就是维度建模的标准形态。
| 字段 | 中文名 | 类型 | 角色 | 指向 / 说明 |
|---|---|---|---|---|
date_key | 日期键 | INTEGER | 🔑 外键 | → dim_date.date_key,如 20220101 |
series_sk | 车系代理键 | BIGINT | 🔑 外键 | → dim_series.series_sk,粒度最细的一层 |
brand_sk | 品牌代理键 | BIGINT | 🔑 外键 | → dim_brand.brand_sk,可向上汇总到品牌 |
segment_sk | 级别代理键 | BIGINT | 🔑 外键 | → dim_segment.segment_sk,无级别时 = -1(1254 行) |
sale_qty | 月销量 | BIGINT | 📊 度量(可加) | 单位「辆」,可跨车系/品牌/级别/月份任意 SUM |
三个"为什么":
① 为什么事实表不存品牌名、车系名这些维度属性?
如果存了,品牌一改名就要 UPDATE 两万多行事实记录;而存 brand_sk 的话,只需改 dim_brand 里的 1 行。
这就是维度建模抗业务变化的根本机制 —— 事实表只记"发生了什么",不记"它是谁"。
② 为什么 date_key 不叫 date_sk?
日期维度是唯一例外:业界普遍直接用 YYYYMMDD 整数当主键。因为它本身就是一个天然、稳定、可读的整数键,再套一层代理键只会白白多一次 JOIN。
③ 为什么度量只有 sale_qty 一个?
因为只有可加的度量才能存进事实表。sale_qty 可以跨任何维度 SUM;
而"均价""市占率""同比增幅"这类不可加的比率型指标,存进去再汇总就是错的(分子分母各加一遍),必须现算 —— 这正是 DWS 层和分析查询存在的理由。
一句话记住事实表的长相:
一堆 _sk 外键 + 一个能 SUM 的数字。
看到不符合这个形状的事实表,八成是设计错了。
第 19 步 · 事实表自检:参照完整性
这是维度建模质量的核心检查。
con.sql("""
    SELECT COUNT(*)                                     AS 事实行数,
           COUNT(*) FILTER (WHERE date_key   = -1)      AS 日期落未知,
           COUNT(*) FILTER (WHERE series_sk  = -1)      AS 车系落未知,
           COUNT(*) FILTER (WHERE brand_sk   = -1)      AS 品牌落未知,
           COUNT(*) FILTER (WHERE segment_sk = -1)      AS 级别落未知,
           SUM(sale_qty)                                AS 总销量,
           COUNT(DISTINCT series_sk || '-' || date_key) AS 粒度唯一数
    FROM dwd.fact_monthly_sales
""").df()
✅ 自检点 2(三条全部对上,星型模型才算建对):
| 检查项 | 期望值 | 说明 |
|---|---|---|
事实行数 | 21713 | 与 ODS 完全一致,一行没丢 |
总销量 | 85,382,903 | 与第 11 步的 总销量 完全相等(度量守恒) |
粒度唯一数 | 21713 | 等于事实行数,说明"车系 × 月"粒度无重复 |
级别落未知 | 1254 | 正是缺级别的那些行,被 -1 兜住了 |
第三行最容易被人忽略,但它最重要。
粒度唯一数 < 事实行数说明事实表有重复;> 事实行数不可能。而事实行数 > ODS 行数 说明 JOIN 时发生了行数膨胀 —— 通常是维度表里同一个业务键有多条记录(比如第 16 步说的两个"未知")。行数膨胀是维度建模最隐蔽的错误:SQL 不报错、总数看着也合理,但每个聚合结果都是虚高的。
养成习惯:每建一张事实表,都拿这一格 SQL 量一遍。
第 20 步 · 跑通星型 JOIN
一次 JOIN 拿到所有分析角度 —— 这就是星型模型的价值。
con.sql("""
    SELECT d.year_month                       AS 月份,
           b.brand_name                       AS 品牌,
           b.origin                           AS 阵营,
           g.segment_name                     AS 级别,
           SUM(f.sale_qty)                    AS 销量
    FROM dwd.fact_monthly_sales f
    JOIN dim.dim_date    d ON d.date_key    = f.date_key
    JOIN dim.dim_brand   b ON b.brand_sk    = f.brand_sk
    JOIN dim.dim_segment g ON g.segment_sk  = f.segment_sk
    WHERE d.year_month = '2025-10'
    GROUP BY 1, 2, 3, 4
    ORDER BY 销量 DESC
    LIMIT 8
""").df()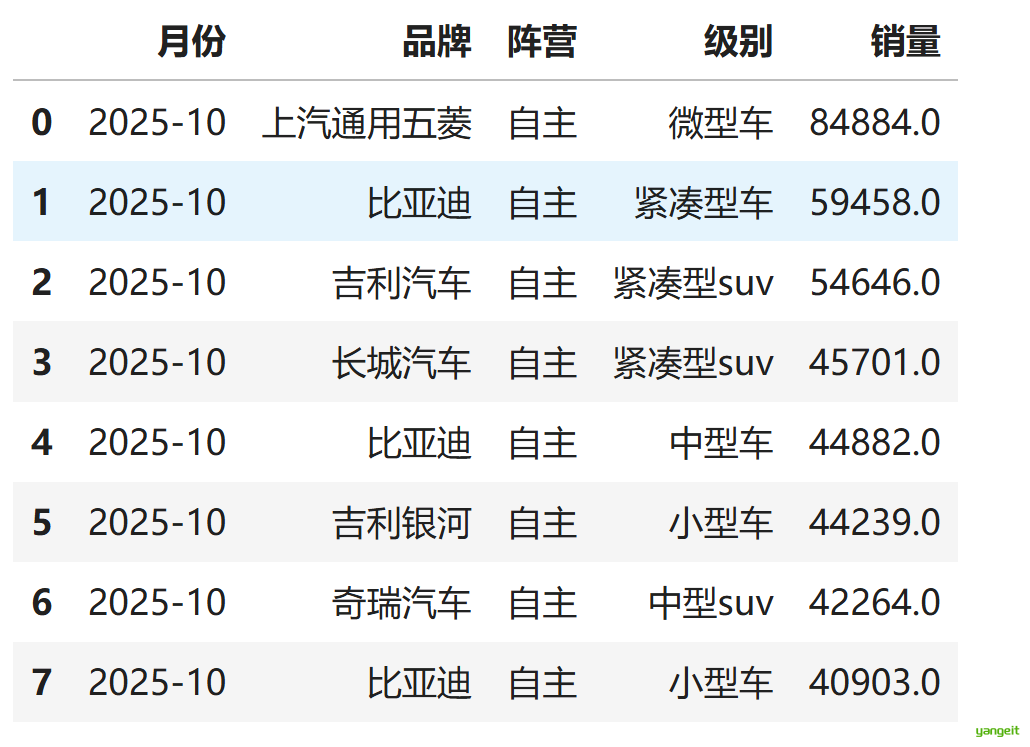
第 21 步 · DWS 层:预聚合
如果每次分析都要扫 2 万行明细 JOIN 四张表,那就太慢了。把最常用的聚合提前算好存下来,这就是 DWS 层。
2 万行数据量小还看不出差距,数据量到千万级时,查 DWS 比查 DWD 快上百倍。
con.execute("CREATE SCHEMA IF NOT EXISTS dws")
con.execute("""
CREATE OR REPLACE TABLE dws.brand_month AS
SELECT f.date_key, d.year, d.month, d.year_month,
       b.brand_sk, b.brand_name, b.origin,
       SUM(f.sale_qty)             AS sale_qty,
       COUNT(DISTINCT f.series_sk) AS series_cnt
FROM dwd.fact_monthly_sales f
JOIN dim.dim_date  d ON d.date_key = f.date_key
JOIN dim.dim_brand b ON b.brand_sk = f.brand_sk
GROUP BY 1, 2, 3, 4, 5, 6, 7
""")

con.sql("""
    SELECT year_month AS 月份, brand_name AS 品牌, origin AS 阵营, sale_qty AS 销量
    FROM dws.brand_month
    WHERE year_month = '2025-10'
    ORDER BY sale_qty DESC LIMIT 10
""").df()
🎯 业务分析实操
数仓建完了,现在用它干活。下面 5 道题,每道都配了"看什么"的引导。
分析 ① · 月度大盘走势
q1 = con.sql("""
    SELECT d.year_month AS 月份,
           SUM(f.sale_qty) AS 销量
    FROM dwd.fact_monthly_sales f
    JOIN dim.dim_date d ON d.date_key = f.date_key
    GROUP BY 1 ORDER BY 1
""").df()
q1.head(12)
运行结果 :
月份	销量
0	2022-01	2262169.0
1	2022-02	2262169.0
2	2022-03	2262169.0
3	2022-04	2262169.0
4	2022-05	2262169.0
5	2022-06	2262169.0
6	2022-07	2262169.0
7	2022-08	2185146.0
8	2022-09	2262169.0
9	2022-10	1710027.0
10	2022-11	1530537.0
11	2022-12	2033275.0
把趋势画出来
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["SimHei", "Microsoft YaHei"]
plt.rcParams["axes.unicode_minus"] = False

ax = q1.plot(x="月份", y="销量", kind="line", marker="o",
             figsize=(13, 4), legend=False, color="#c0392b",
             title="乘用车月度销量大盘(2022-01 ~ 2025-10)")
ax.set_ylabel("销量(辆)")
plt.xticks(rotation=60)
plt.grid(alpha=.3)
plt.tight_layout()
plt.show()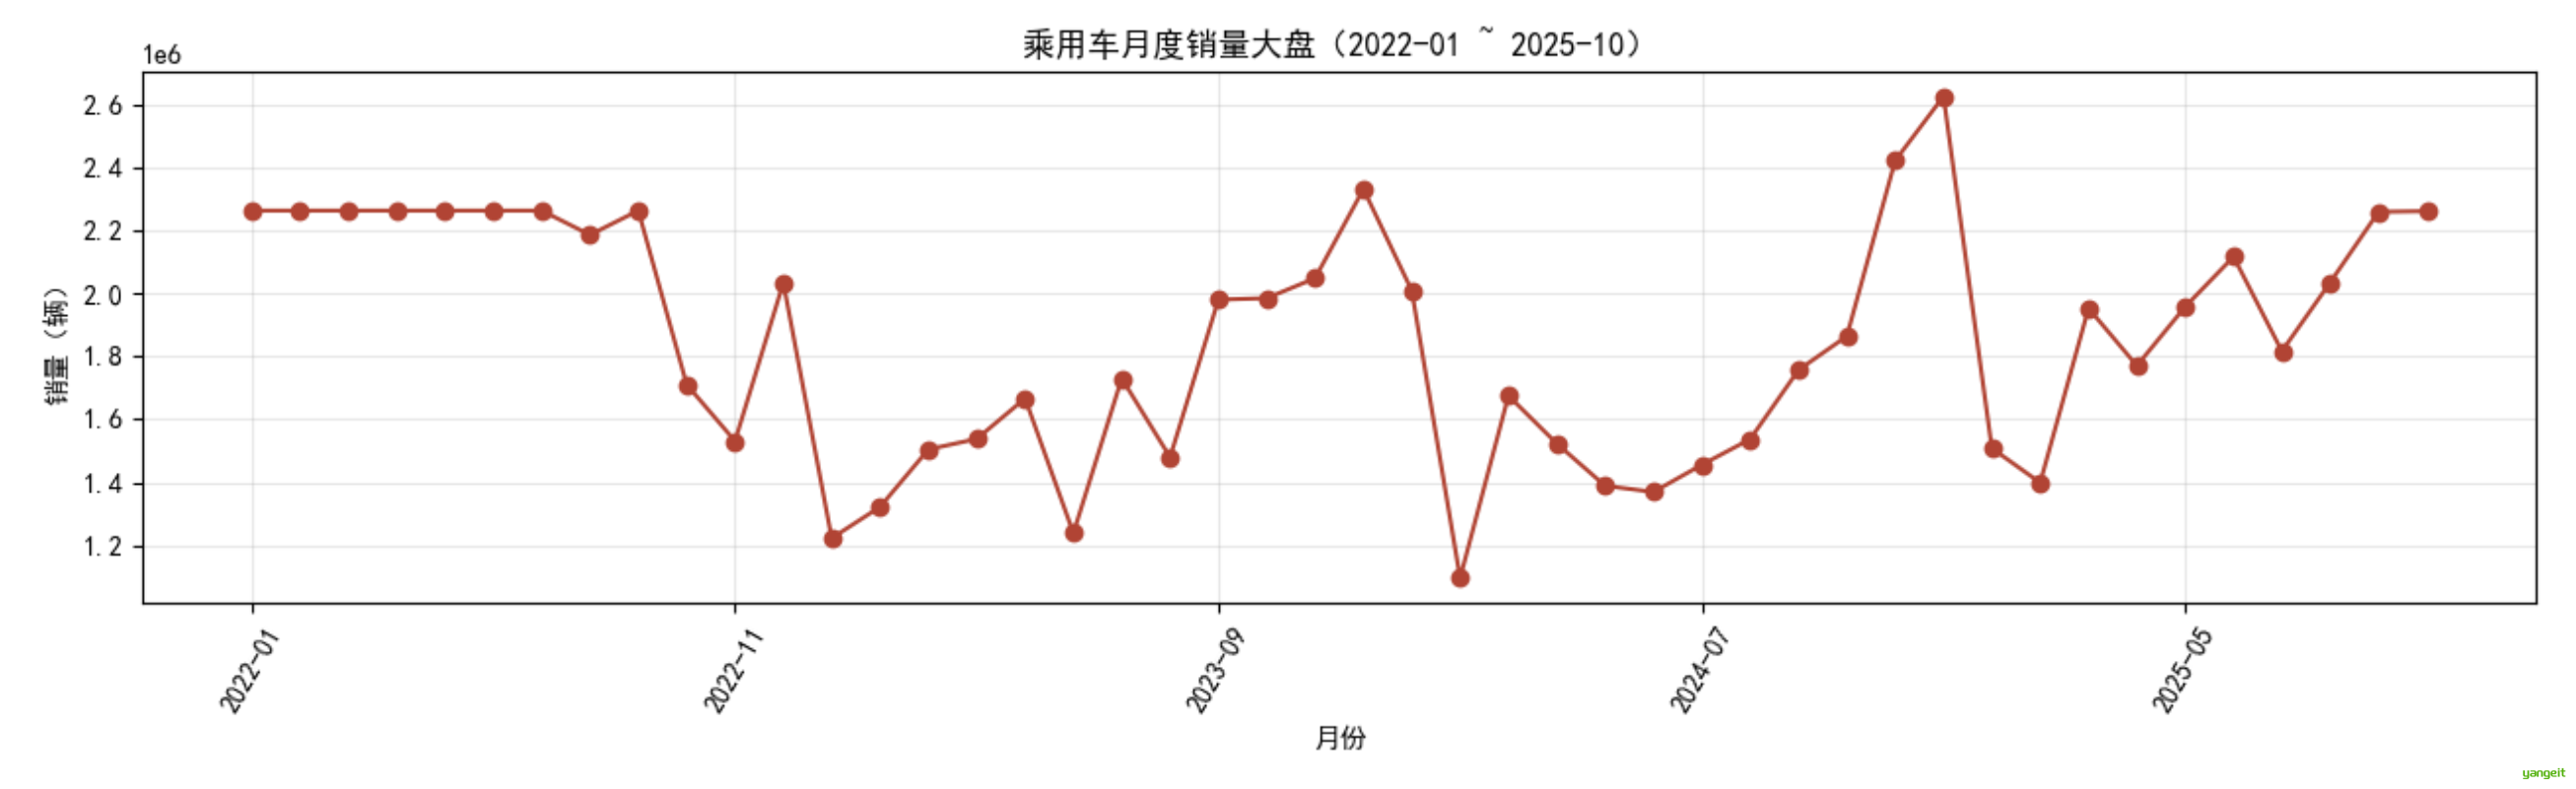
🚨 出问题了
看图说话:2022 年上半年那段曲线,是不是一条笔直的水平线?
一个真实的汽车市场,不可能连续多个月总销量一分不差。这是数据问题,不是业务现象。用 SQL 把它抓出来。
先试最直觉的写法 —— 拿每个月和它的上一个月比:
con.sql("""
WITH m AS (
    SELECT date_key, SUM(sale_qty) AS qty
    FROM dwd.fact_monthly_sales GROUP BY 1
)
SELECT date_key                              AS 月份,
       qty                                   AS 当月总销量,
       LAG(qty) OVER (ORDER BY date_key)     AS 上月总销量
FROM m
QUALIFY qty = "上月总销量"        -- QUALIFY:DuckDB 的窗口函数过滤语法,不用套子查询
ORDER BY 1
""").df()
月份	当月总销量	上月总销量
0	20220201	2262169.0	2262169.0
1	20220301	2262169.0	2262169.0
2	20220401	2262169.0	2262169.0
3	20220501	2262169.0	2262169.0
4	20220601	2262169.0	2262169.0
5	20220701	2262169.0	2262169.0
抓到了 6 个月。但这条规则有盲区 —— 它只能发现"和紧邻的上个月一模一样"。万一重复的月份中间夹了一个正常月份呢?
换个更严谨的思路:按总销量分组,看哪个值出现了不止一次。
con.sql("""
WITH m AS (
    SELECT date_key, SUM(sale_qty) AS qty
    FROM dwd.fact_monthly_sales GROUP BY 1
)
SELECT qty                                                AS 总销量,
       COUNT(*)                                           AS 出现月数,
       string_agg(CAST(date_key AS VARCHAR), ' ' ORDER BY date_key) AS 月份
FROM m
GROUP BY qty
HAVING COUNT(*) > 1
""").df()
实际是 8 个月:
2022-01 ~ 2022-07加上2022-09。
2022-09 被上一条规则漏掉了 —— 因为它前面夹着数据正常的 2022-08。结论:检测重复快照要用「值 + 出现次数」分组,不能只比相邻行。
这条经验适用于所有周期性采集的数据:日快照、月结、传感器上报。
再验证得狠一点 —— 逐车系比对,看是不是整张表都被复制了:
con.sql("""
WITH a AS (SELECT series_id, sale_qty AS q1 FROM stg.sales_clean WHERE sale_month = 20220101),
     b AS (SELECT series_id, sale_qty AS q2 FROM stg.sales_clean WHERE sale_month = 20220201)
SELECT COUNT(*)                                AS 共同车系数,
       COUNT(*) FILTER (WHERE q1 = q2)         AS 销量完全相同,
       ROUND(100.0 * COUNT(*) FILTER (WHERE q1 = q2) / COUNT(*), 1) AS 相同占比
FROM a JOIN b USING (series_id)
""").df()
这个坑为什么值得单独讲
665 个车系,行级 100% 相同 —— 2022-01 的快照被原样复制到了
02~07和09,共 8 个月共用同一份数据(采集脚本的 bug)。可怕的地方在于:它能通过所有常规校验。格式合法、主键不重复、值域正常、总量合理。唯一性约束也抓不到它,因为
(series_id, sale_month)确实不重复。只有跨期对比才能让它现形。
三个教训:
- 数据质量检查不能只看单表单列,必须有跨期、跨维度的对比规则,而且规则本身要经得起"漏检"的推敲(上面第一条 SQL 就漏了 2022-09)
- 可视化是最好的质检工具 —— 一条水平直线,肉眼 0.1 秒就发现了,写 SQL 规则反而想不到
- 发现之后不要偷偷改数据。正确做法是打标,让每次分析的人自己决定要不要排除这几个月
→ 下面所有分析,涉及 2022 年的结论都要谨慎。
顺便说一句:2022-08 只采到 340 个车系,而 2022-01 有 665 个 —— 采集覆盖本身也在变,所以 2022 年的同比基本不可用。
分析 ② · 品牌 TOP10(2025 年累计)
con.sql("""
    SELECT b.brand_name                        AS 品牌,
           b.origin                            AS 阵营,
           SUM(f.sale_qty)                     AS 销量,
           COUNT(DISTINCT f.series_sk)         AS 在售车系数,
           ROUND(AVG(f.sale_qty), 0)           AS 车系月均销量,
           ROUND(100.0 * SUM(f.sale_qty) /
                 SUM(SUM(f.sale_qty)) OVER (), 2) AS 市占率百分比
    FROM dwd.fact_monthly_sales f
    JOIN dim.dim_date  d ON d.date_key = f.date_key
    JOIN dim.dim_brand b ON b.brand_sk = f.brand_sk
    WHERE d.year = 2025
    GROUP BY 1, 2
    ORDER BY 销量 DESC
    LIMIT 10
""").df()
SUM(SUM(...)) OVER ()是窗口函数套聚合,用来在明细行上算总计,从而得到每行占总和的比例。这是算占比最简洁的写法。
	品牌	阵营	销量	在售车系数	车系月均销量	市占率百分比
0	比亚迪		 自主	2561843.0	44	7216.0	13.43
1	吉利银河	自主	939599.0	11	11054.0	4.93
2	奇瑞汽车	自主	903256.0	29	4014.0	4.74
3  上汽通用五菱	自主	841361.0	33	3596.0	4.41
4	上汽大众	合资	826040.0	15	6403.0	4.33
5	吉利汽车	自主	782310.0	9	9425.0	4.10
6	一汽-大众	合资	724493.0	14	5890.0	3.80
7	一汽丰田	合资	652777.0	14	5934.0	3.42
8	广汽丰田	合资	637413.0	12	6188.0	3.34
9	长安汽车	自主	579049.0	21	3688.0	3.04
分析 ③ · 车型级别结构变迁(透视)
看轿车 / SUV / MPV 的份额怎么变。用 FILTER 做条件聚合,比 CASE WHEN 更清爽。
con.sql("""
    SELECT g.segment_name AS 车型级别,
           SUM(f.sale_qty) FILTER (WHERE d.year = 2022) AS y2022,
           SUM(f.sale_qty) FILTER (WHERE d.year = 2023) AS y2023,
           SUM(f.sale_qty) FILTER (WHERE d.year = 2024) AS y2024,
           SUM(f.sale_qty) FILTER (WHERE d.year = 2025) AS y2025
    FROM dwd.fact_monthly_sales f
    JOIN dim.dim_date    d ON d.date_key   = f.date_key
    JOIN dim.dim_segment g ON g.segment_sk = f.segment_sk
    GROUP BY 1
    ORDER BY y2025 DESC
    LIMIT 12
""").df()
⚠️ 注意:2022 年那一列被重复快照污染了(只有 2022-01 是真数据 + 6 个月的复制),所以 2022 列不能用来比趋势。这正是分析① 发现的问题的实际影响
| 车型级别 | y2022 | y2023 | y2024 | y2025 | |
|---|---|---|---|---|---|
| 0 | 紧凑型suv | 5446727.0 | 4896497.0 | 4873169.0 | 4317934.0 |
| 1 | 中型suv | 3703247.0 | 2792929.0 | 3265096.0 | 2894909.0 |
| 2 | 紧凑型车 | 4299569.0 | 4629647.0 | 3880574.0 | 2884652.0 |
| 3 | 中型车 | 3281321.0 | 2516942.0 | 2939761.0 | 2640193.0 |
| 4 | 中大型车 | 1479739.0 | 980399.0 | 1142602.0 | 1197071.0 |
| 5 | 中大型suv | 1915569.0 | 848127.0 | 1178313.0 | 1152895.0 |
| 6 | 微型车 | 1738604.0 | 891383.0 | 954521.0 | 1139468.0 |
| 7 | 小型车 | 1439266.0 | 872305.0 | 977704.0 | 1096302.0 |
| 8 | 小型suv | 755899.0 | 625756.0 | 488965.0 | 597570.0 |
| 9 | 未知 | 637985.0 | 593073.0 | 562833.0 | 580526.0 |
| 10 | 大型suv | 610363.0 | 142775.0 | 255702.0 | 407012.0 |
| 11 | 紧凑型MPV | 131493.0 | 154779.0 | 93293.0 | 76039.0 |
分析 ④ · 同比环比(窗口函数实战)
这是 BI 报表里最常见的需求,也是最容易写错的地方。
先看两个典型的错误写法:
-- ✖ 错误 1:LAG(qty, 12) 是"往前数第 12 行",不是"去年同月"
--          中间只要缺一个月(比如 2022-08 没采到),后面全部错位
LAG(qty, 12) OVER (ORDER BY year_month)

-- ✖ 错误 2:date_key - 100 算上月,跨年会得到 20250001 这种不存在的日期
WHERE date_key = 20250301 - 100
正确做法:先把月份转成连续的序号,再用自关联精确匹配。
con.sql("""
WITH m AS (
    SELECT d.year, d.month,
           d.year * 12 + d.month        AS month_idx,   -- 连续月份序号,跨年不会断
           SUM(f.sale_qty)              AS qty
    FROM dwd.fact_monthly_sales f
    JOIN dim.dim_date d ON d.date_key = f.date_key
    GROUP BY 1, 2, 3
)
SELECT cur.year_month                        AS 月份,
       cur.qty                               AS 当月销量,
       mom.qty                               AS 上月销量,
       ROUND(100.0 * (cur.qty - mom.qty) / mom.qty, 1) AS 环比百分比,
       yoy.qty                               AS 去年同月,
       ROUND(100.0 * (cur.qty - yoy.qty) / yoy.qty, 1) AS 同比百分比
FROM (
    SELECT printf('%04d-%02d', year, month) AS year_month,
           year, month, month_idx, qty
    FROM m
) cur
LEFT JOIN m mom ON mom.month_idx = cur.month_idx - 1     -- 精确匹配上月
LEFT JOIN m yoy ON yoy.month_idx = cur.month_idx - 12    -- 精确匹配去年同月
WHERE cur.year = 2025
ORDER BY 1
""").df()
因为 2022-02 ~ 2022-07 的数据是重复的,同比会失真。所以上面只查 2025 年,同比基准落在 2024 年,数据干净。
这也说明一个道理:数据质量决定了你能做什么分析。数据脏,很多分析根本做不了。
分析 ⑤ · 自主 vs 合资:阵营格局演变
con.sql("""
    SELECT d.year                                          AS 年份,
           b.origin                                        AS 阵营,
           SUM(f.sale_qty)                                 AS 销量,
           ROUND(100.0 * SUM(f.sale_qty) /
                 SUM(SUM(f.sale_qty)) OVER (PARTITION BY d.year), 1) AS 份额百分比
    FROM dwd.fact_monthly_sales f
    JOIN dim.dim_date  d ON d.date_key = f.date_key
    JOIN dim.dim_brand b ON b.brand_sk = f.brand_sk
    GROUP BY 1, 2
    ORDER BY 1, 销量 DESC
""").df()
OVER (PARTITION BY d.year)让占比在每一年内各自归一到 100%,而不是全表归一。这就是"组内占比"的写法。
| 年份 | 阵营 | 销量 | 份额百分比 | |
|---|---|---|---|---|
| 0 | 2022 | 自主 | 16593013.0 | 64.9 |
| 1 | 2022 | 合资 | 8607355.0 | 33.7 |
| 2 | 2022 | 外资 | 355969.0 | 1.4 |
| 3 | 2023 | 自主 | 10253700.0 | 51.2 |
| 4 | 2023 | 合资 | 9182962.0 | 45.8 |
| 5 | 2023 | 外资 | 603784.0 | 3.0 |
| 6 | 2024 | 自主 | 12445517.0 | 60.1 |
| 7 | 2024 | 合资 | 7612572.0 | 36.7 |
| 8 | 2024 | 外资 | 657959.0 | 3.2 |
| 9 | 2025 | 自主 | 12485296.0 | 65.5 |
| 10 | 2025 | 合资 | 6125964.0 | 32.1 |
| 11 | 2025 | 外资 | 458812.0 | 2.4 |
📝 实训报告内容(模板在学习通有)
把下面这张表复制到你的报告里,把「你的答案」列填满即可。 前 6 行是必填,后 3 行是加分项。
| # | 问题 | 你的答案 |
|---|---|---|
| 1 | 本数仓的事实表粒度是什么?为什么必须先确定粒度? | |
| 2 | 你的数仓有几张维度表?分别是什么?画出星型模型图(手绘拍照即可) | |
| 3 | ODS / STG / DIM / DWD / DWS 各自的作用是什么?为什么不能跳过 ODS? | |
| 4 | 列出你处理过的 至少 5 种脏数据,写明「原始格式 → 清洗后 → 用了什么函数」 | |
| 5 | 事实表行数是多少?与 ODS 相比有没有丢失?总销量是否守恒? | |
| 6 | 用一句话总结 2025 年汽车市场的格局(谁领先、什么级别最火、自主份额多少) | |
| 7 | ⭐ 分析① 发现的数据问题是什么?怎么发现的?对后续分析有什么影响? | |
| 8 | ⭐ 缺失值为什么置 NULL 而不是 0?用本实训的数据举个例子说明后果 | |
| 9 | ⭐ 维度表为什么要有 sk = -1 的未知成员?不用它会怎样? |
报告要求:800 字以上,第 4 题做成表格,第 2 题配图。把关键 cell 的输出截图贴在报告里。